federal-ai-enforcement
收藏资源简介:
US Federal AI Enforcement Tracker(美国联邦人工智能执法追踪器)是一个来源可查的数据集,专门收录美国联邦层面涉及人工智能或自动化系统的执法行动及相关官方材料。该数据集旨在为人工智能监管、法律执行和公共政策研究提供结构化的实证数据。数据以结构化表格(CSV)和JSON格式提供,包含核心字段如唯一标识、执法机构、目标对象、日期信息、法律依据、案件状态、AI议题标签等,以及支持性字段如案卷号、来源引用等,确保数据的可追溯性和可验证性。数据集适用于人工智能治理、法律合规分析、监管政策研究等场景,遵循CC BY 4.0许可协议,但需注意其描述性研究性质,并非法律建议。
The US Federal AI Enforcement Tracker is a verifiable dataset that specifically collects enforcement actions and related official materials at the U.S. federal level involving artificial intelligence or automated systems. It aims to provide structured empirical data for AI regulation, law enforcement, and public policy research. The data is provided in structured formats (CSV and JSON), including core fields such as unique identifiers, enforcement agencies, targets, dates, legal authorities, case statuses, AI issue tags, and supporting fields like docket numbers and source citations to ensure traceability and verifiability. The dataset is suitable for applications in AI governance, legal and compliance analysis, regulatory policy research, and more, under the CC BY 4.0 license, with the note that it is descriptive research and not legal advice.
数据集概要
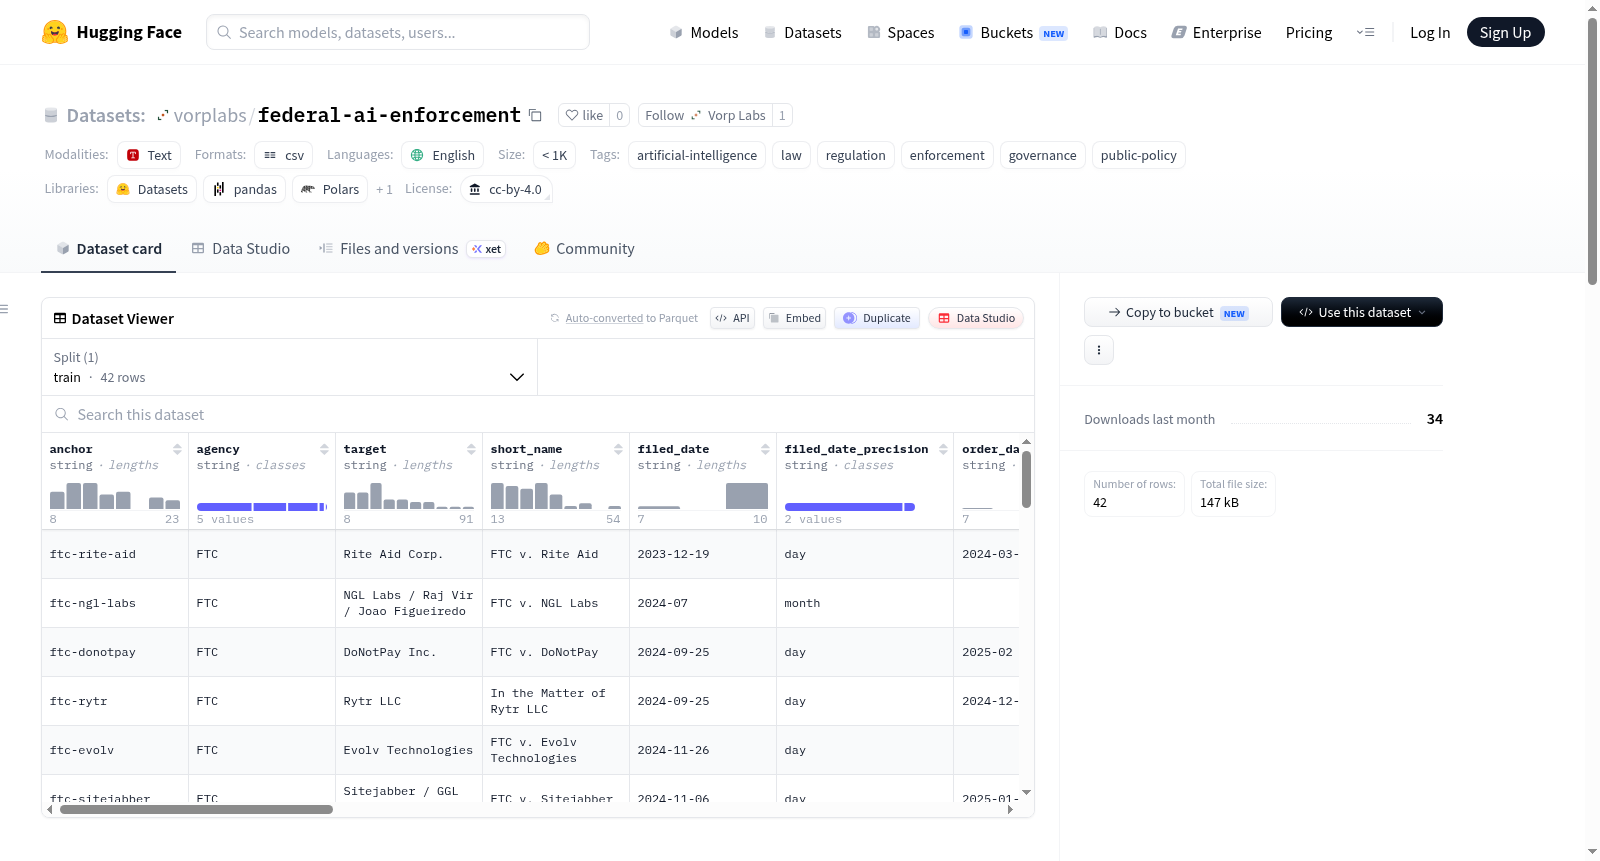
数据集名称为 US Federal AI Enforcement Tracker,由 Vorp Labs 维护,是一个基于原始来源的美国联邦执法行动及相关官方材料的数据集,涉及人工智能或自动化系统。
版本与规模
- 当前版本:2026.07.19
- 覆盖范围:截至 2026-07-18,追踪 42项联邦执法行动。
- 数据集规模:类别为 n<1K(记录数少于1000条)。
许可与语言
- 许可证:CC BY 4.0(署名 4.0 国际)
- 语言:英语
数据文件与格式
主要数据文件为 federal-ai-enforcement.csv,存放于 releases/2026.07.19/ 目录下。完整发布包包含以下文件:
federal-ai-enforcement.csv:平面行动表,适用于电子表格和分析。federal-ai-enforcement.json:结构化发布对象,包含行动记录、相关材料、变更日志和监控来源。release-manifest.json:版本、来源URL、记录计数、字节计数及SHA-256校验和。CITATION.cff:机器可读的引用元数据。README.md:版本特定的文档。SHA256SUMS:文件完整性校验文件。LICENSE.txt:CC BY 4.0 许可条款。
主要字段
数据集中每条行动记录包含以下关键字段:
anchor、agency、target、shortName:行动标识与参与者。filedDate、orderDate及其精度字段:日期信息及不确定性标记。legalAuthority、status、outcome、summary、aiIssueTags:法律依据、状态、结果、摘要及AI相关标签。docketOrFileNumbers、events、penalties、relatedAnchors:案卷号、事件、处罚及关联行动。factChecks、openItems、sources、url:事实核查、未决事项、来源链接及记录级溯源。
用途与限制
- 该数据集为描述性研究,不构成法律建议。
- 不保证涵盖所有涉及软件或算法的执法事项。
- 使用前请核对原始来源链接及数据截止日期。
永久标识符与规范来源
- 规范研究页面:https://vorplabs.com/ai-regulatory-updates/federal-enforcement
- 规范发布清单:https://vorplabs.com/datasets/federal-ai-enforcement/manifest.json
- 不可变GitHub发布:https://github.com/vorplabs/research-datasets/tree/73c7586aa4df7640000760520fdbcf96d371303c/datasets/federal-ai-enforcement/2026.07.19
- 版本DOI:https://doi.org/10.5281/zenodo.21456232
- 概念DOI:https://doi.org/10.5281/zenodo.21456231
完整性验证
可在发布目录中运行以下命令进行SHA-256校验:
shasum -a 256 -c SHA256SUMS