
awesome-wikipedia
收藏官方服务:
资源简介:
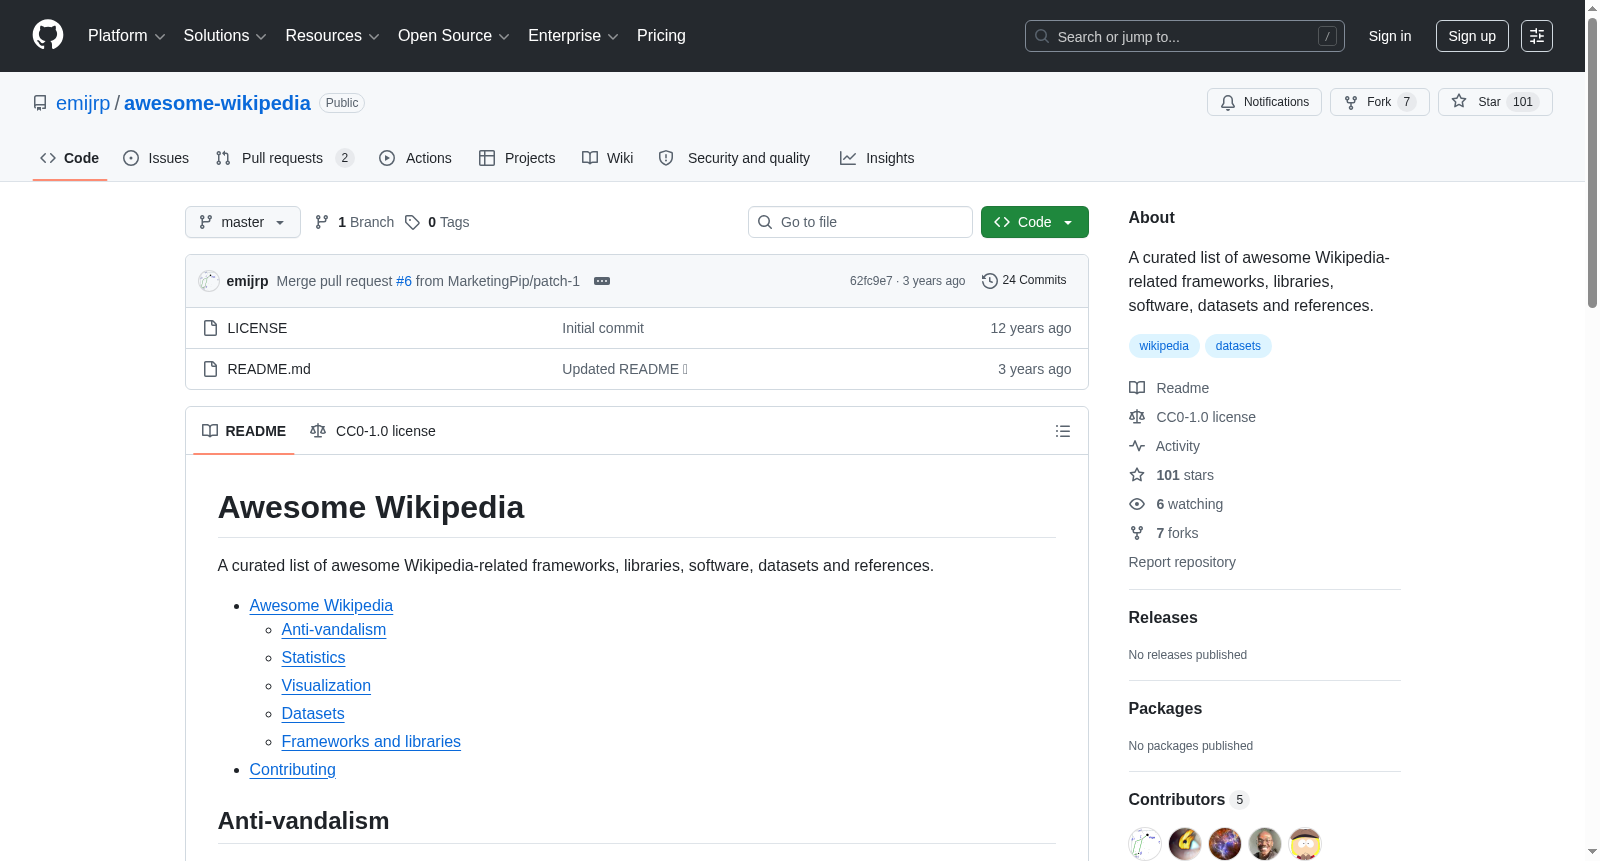
这是一个精心策划的资源列表,专注于收集和整理与维基百科相关的数据集,包括数据库转储和页面浏览统计数据等资源。
This is a carefully curated list of resources focused on collecting and organizing Wikipedia-related datasets, including database dumps, page view statistics, and other relevant resources.
创建时间:
2014-07-02
原始信息汇总
数据集概述
基本信息
- 名称:Awesome Wikipedia
- 地址:https://github.com/emijrp/awesome-wikipedia
- 类型:维基百科相关资源汇总列表,包含框架、库、软件、数据集和参考资料
数据集部分
该页面专门列出与维基百科相关的数据集资源,包括:
-
Database dump(数据库转储)
- 链接:http://dumps.wikimedia.org/backup-index.html
- 内容:每个维基媒体项目的XML转储,包含每篇文章和每次编辑的元数据与文本。还提供页面链接、分类、日志、保护和图像元数据等其他数据集,大小为几GB。
-
Page views statistics(页面浏览量统计)
- 链接:http://dumps.wikimedia.org/other/pagecounts-raw/
- 内容:每小时压缩的文件,包含每个页面的浏览次数统计。
相关工具与资源
-
框架和库(用于处理维基百科数据)
- MediaWiki Utilities:从MediaWiki安装、从库数据库和XML转储中提取和处理数据
- pywikibot:通过API访问MediaWiki网站的官方库
- Wikidata Toolkit:用于处理Wikidata和其他Wikibase站点数据的开源Java库
- WikiData SDK:用于查询Wikidata信息的JavaScript工具套件
- wtf_wikipedia:用于解析维基百科标记的JavaScript工具
-
Web扩展
- Wikiref:Firefox扩展,可提取Wikipedia页面的特定引用(文本和链接)、编辑文本内容并导出为JSON
-
统计工具
- stats.grok.se:多种语言维基百科的页面浏览量统计,可按月和最近30/60/90天选择,支持JSON导出
- Wikimedia Report Card:维基媒体项目核心指标(独立访问者、页面浏览等)的月度数字与图表
- wlm-stats:关于“维基爱古迹”摄影比赛的统计与图表
- wmcharts:维基媒体项目活动图表,包括近期更改、新页面、删除、封禁、保护、文件上传、回退等
-
可视化工具
- Listen to Wikipedia:维基百科实时编辑活动的视觉与音频展示
- wikipulse:各主要语言维基百科实时编辑率展示
- wlm-maps:为“维基爱古迹”摄影比赛提供地图,方便查找附近古迹
- wmcounter:所有维基媒体项目的近实时计数器
-
抗破坏工具
- Huggle:用于维基百科的半自动抗破坏工具
其他链接
- 维基百科相关统计与工具页面索引(如“所有人类知识”、维基百科统计、维基百科工具、维基媒体工具实验室)
搜集汇总
数据集介绍
构建方式
在浩瀚的维基百科生态系统中,各类工具与资源星罗棋布,然而缺乏一个系统化的导航目录。该数据集以精选清单的形式,通过社区贡献的协作模式,从反破坏工具、统计与可视化项目、数据集资源、框架库及浏览器扩展等多个维度,对维基百科相关的优秀开源项目进行梳理与归类。构建过程依托GitHub平台,通过提交Issue或Pull Request的方式持续吸纳社区智慧,确保清单的时效性与全面性。
特点
该数据集的独特之处在于其高度的结构化和领域专精性。它不仅收录了如Huggle等反破坏工具、Listen to Wikipedia等实时可视化项目,还整合了数据库转储、页面浏览量统计等核心数据集资源,以及MediaWiki Utilities、Pywikibot等开发框架。作为维基百科生态的索引,它横跨工具使用、数据分析和程序开发等多个层次,为不同需求的用户提供了便捷的入口,体现了开源社区知识共享与协作的精髓。
使用方法
该数据集的使用方法直观而灵活。用户可直接浏览GitHub仓库中的README文件,通过分类目录快速定位所需资源,每个条目均附有直达项目页面的链接。开发者可依据清单中的框架与库(如Wikidata Toolkit、wtf_wikipedia)进行二次开发,研究者则可利用Datasets部分的数据库转储进行大规模分析。此外,用户还可通过贡献指南主动参与清单的维护与扩展,共同完善这一维基百科资源的知识图谱。
背景与挑战
背景概述
维基百科作为全球最大的开放式在线百科全书,自2001年创立以来,已成为人类知识汇聚与共享的重要平台。其海量的结构化与非结构化数据,为自然语言处理、知识图谱构建、社会网络分析等领域提供了丰沃的研究土壤。在此背景下,由研究者Emijrp等人维护的awesome-wikipedia资源清单应运而生,旨在系统性地收录与维基百科相关的框架、库、软件、数据集及参考文献。该清单自发布以来,持续更新,不仅为学术界与工业界提供了便捷的工具索引,更推动了维基百科数据在反破坏检测、编辑行为分析、知识可视化等方向的研究进展,成为连接维基百科生态与计算科学社区的关键桥梁。
当前挑战
awesome-wikipedia所面临的挑战首先源于维基百科数据本身的复杂性。维基百科每日产生海量编辑活动,数据规模呈指数级增长,如何从持续更新的XML转储与页面浏览统计中高效提取、清洗并整合多语言、多模态信息,成为领域内的核心难题。其次,在反破坏工具(如Huggle)的研发中,需应对日益隐蔽的恶意编辑行为,平衡检测准确率与实时性。此外,现有统计与可视化工具(如Listen to Wikipedia)虽能实时呈现编辑动态,但在跨语言项目的统一度量与长期趋势建模上仍显不足。构建过程中,工具与库的兼容性、API调用的稳定性以及数据隐私保护,同样为资源整合与持续维护带来了技术层面的严峻考验。
常用场景
经典使用场景
在知识图谱构建与自然语言处理领域,Awesome Wikipedia 数据集凭借其涵盖全球多语言、多领域的海量结构化与非结构化内容,成为训练语言模型、抽取实体关系以及构建语义网络的基石。研究者常借助其完整的页面文本与编辑历史,进行文本分类、摘要生成及知识推理等基准任务,从而推动通用人工智能对开放域知识的理解能力。
解决学术问题
该数据集有效解决了学术研究中大规模、高质量标注数据匮乏的困境。通过提供包含元数据、页面链接及分类标签的完整快照,它支持了对维基百科编辑动态的量化分析,例如反破坏机制评估与内容演化建模。其开源特性还促进了跨语言知识对齐和低资源语言处理的突破,显著降低了构建多语种知识库的门槛。
衍生相关工作
基于该数据集,衍生出多项经典工作,包括半自动反破坏工具 Huggle、实时编辑可视化项目 Listen to Wikipedia,以及解析维基标记语言的 JavaScript 库 wtf_wikipedia。这些工作不仅提升了社区维护效率,还催生了 Wikidata Toolkit 等标准化数据处理框架,为后续研究提供了可复用的技术栈与基准测试环境。
以上内容由遇见数据集搜集并总结生成


