
遇见数据集

eliteresearch/researchscope-papers

收藏
Hugging Face2026-06-07 更新2026-06-14 收录
官方服务:

资源简介:

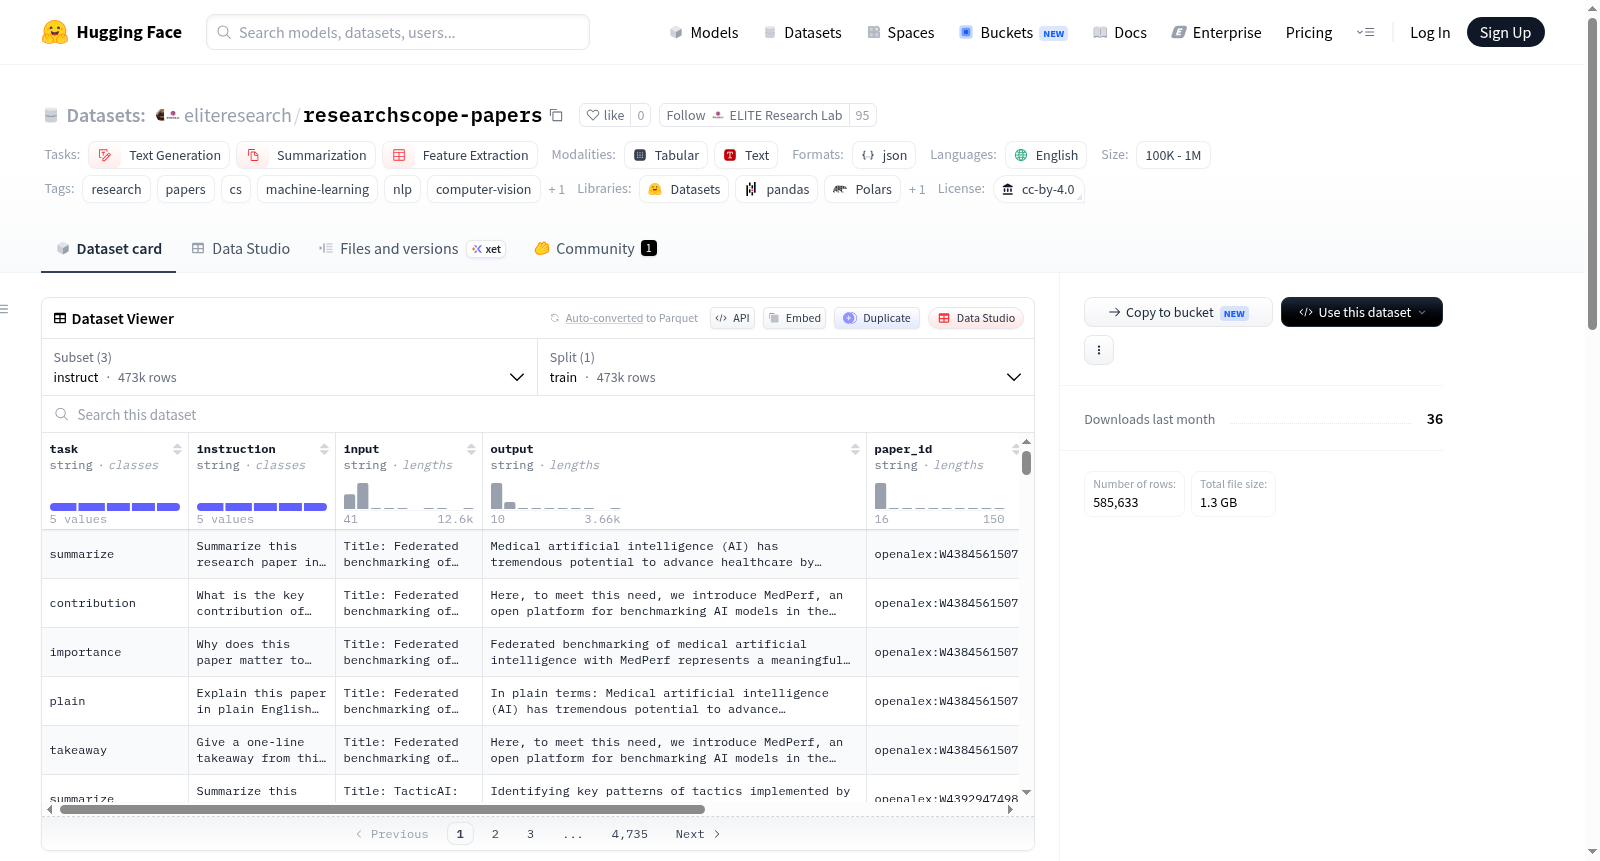
ResearchScope Papers是一个由ResearchScope维护的开放计算机科学研究论文数据集,通过GitHub Actions自动更新。数据集包含102,058篇论文的原始元数据、473,434条指令调优行,以及A*论文的逐章节微调行。数据来源包括arXiv、OpenAlex、ACL Anthology、OpenReview、PMLR、CVF和Semantic Scholar等,涵盖NeurIPS、ICML、ICLR、ACL、EMNLP、CVPR、AAAI、IJCAI、JMLR、TMLR、TACL、TPAMI、NMI等多个顶级会议和期刊。数据集文件包括:papers.jsonl(原始论文元数据,如标题、摘要、作者、会议、年份、标签和分数)、instruct.jsonl(指令调优对,用于总结、关键贡献、重要性解释和通俗英语转换)和sections.jsonl(A*论文的逐章节微调行,包含摘要、引言、相关工作、方法、实验、结果和结论等真实正文文本,可用于训练逐章节写作代理)。

ResearchScope Papers is an open CS research paper dataset maintained by ResearchScope, updated automatically via GitHub Actions. It includes 102,058 papers (raw metadata), 473,434 instruction-tuning rows, and per-section fine-tuning rows for A* papers. Sources include arXiv, OpenAlex, ACL Anthology, OpenReview, PMLR, CVF, and Semantic Scholar, with venues such as NeurIPS, ICML, ICLR, ACL, EMNLP, CVPR, AAAI, IJCAI, JMLR, TMLR, TACL, TPAMI, and NMI. The dataset files are: papers.jsonl (raw paper metadata — title, abstract, authors, venue, year, tags, scores), instruct.jsonl (instruction-tuning pairs — summarize, key contribution, why it matters, plain English), and sections.jsonl (per-section fine-tuning rows for A* papers — real body text of abstract, introduction, related_work, method, experiments, results, conclusion, filterable by the section field to train a per-section writing agent).

提供机构:
eliteresearch
搜集汇总
数据集介绍
eliteresearch/researchscope-papers 数据集图片
构建方式
ResearchScope-Papers是一个面向计算机科学领域的开放研究论文数据集,由ResearchScope项目维护并通过GitHub Actions实现自动更新。其构建过程整合了arXiv、OpenAlex、ACL Anthology、OpenReview、PMLR、CVF及Semantic Scholar等多个权威学术来源,覆盖NeurIPS、ICML、ICLR、ACL、EMNLP、CVPR、AAAI、IJCAI、JMLR、TMLR、TACL、TPAMI、NMI等顶级会议与期刊。数据集包含三个核心配置:papers配置存储论文的原始元数据,包括标题、摘要、作者、发表 venue、年份、标签及评分;instruct配置提供面向指令微调的任务对,涵盖摘要生成、关键贡献提炼、重要性阐释及通俗解释;sections配置则聚焦A*论文的各个章节,如摘要、引言、相关工作、方法、实验、结果与结论等真实正文内容。
特点
该数据集最显著的特点在于其多维度与多层次的结构设计,总计收录约102,058篇论文的原始元数据,并衍生出473,434条指令微调数据。papers配置保留了论文的完整元信息,便于进行大规模文献计量分析或构建检索系统。instruct配置创新性地将学术论文转化为自然语言指令任务,为摘要生成、关键点提取等文本生成任务提供了高质量的训练样本。sections配置更是独具匠心,允许研究者基于section字段过滤出特定章节的文本,从而训练针对特定写作任务(如引言撰写)的专项语言模型,这种精细化的粒度设计极大地拓展了数据集在学术文本生成领域的应用潜力。
使用方法
用户可通过HuggingFace的datasets库便捷地加载该数据集,使用load_dataset函数并指定相应的配置名称即可获取不同粒度的数据。例如,调用load_dataset('kishormorol/researchscope-papers', 'papers', split='train')可获取全部论文的原始元数据;调用load_dataset('kishormorol/researchscope-papers', 'instruct', split='train')则获得指令微调数据;而调用load_dataset('kishormorol/researchscope-papers', 'sections', split='train')并配合filter方法(如过滤section字段为'introduction'的行)可提取特定章节的文本,进而训练如引言写作助手等专门化模型。数据采用JSONL格式存储,兼容常见的深度学习框架与数据处理流程,且遵循CC BY 4.0许可协议,适应广泛的研究与开发场景。
背景与挑战
背景概述
ResearchScope-Papers数据集由ResearchScope团队维护,依托GitHub Actions实现自动化更新,于近期创建并持续迭代,旨在为计算机科学领域,尤其是机器学习、自然语言处理与计算机视觉等子方向,提供大规模、结构化的学术文献资源。该数据集整合了arXiv、OpenAlex、ACL Anthology、OpenReview、PMLR、CVF及Semantic Scholar等多元来源,覆盖NeurIPS、ICML、ICLR、CVPR等顶级会议与期刊,收录超过10万篇论文的元数据,并衍生出47万余条指令微调样本及按章节划分的细粒度微调数据。其核心研究问题在于如何系统化地整理与标注海量学术文本,以支撑文本生成、摘要、特征提取等任务,为科研文献的自动化理解与辅助写作提供基础设施。作为开放的科学文献数据集,它显著降低了研究者获取和利用元数据的门槛,推动了学术文本挖掘、论文生成模型及科研辅助工具的发展。
当前挑战
该数据集所解决的领域核心挑战在于学术文献的非结构化与多源性障碍。传统上,研究者难以从分散的数据库(如arXiv、OpenReview)中高效获取标准化的论文元数据与全文内容,导致文献综述、知识发现及生成式模型的训练效率低下。ResearchScope-Papers通过统一的数据模式整合来源,但构建过程面临严峻挑战:其一,多源数据格式不一,如OpenAlex的API响应与ACL Anthology的HTML解析需定制化处理以适配JSONL结构;其二,版权与许可问题复杂,需确保文本内容遵循各来源的原始协议(如CC0、CC BY),并在归入数据集时保持合规标注;其三,文献数量庞大且持续增长,自动化流水线需应对API速率限制、增量更新与去重逻辑,以维持数据的新鲜度与一致性。此外,指令微调样本的生成依赖高质量的元数据与人工标注模板,如何平衡自动化产出与语义准确性也是一大考验。
常用场景
经典使用场景
ResearchScope-Papers数据集汇聚了来自arXiv、ACL Anthology、OpenReview等十余个顶级学术来源的逾十万篇计算机科学论文元数据,为研究者提供了横跨机器学习、自然语言处理、计算机视觉等核心领域的广阔语料库。其最经典的用途在于支撑学术论文的自动生成与摘要提炼任务,通过配置的指令微调(instruct)和章节级(sections)数据子集,研究者能够训练模型理解论文的宏观结构——从摘要、引言到实验与结论,进而在论文撰写辅助、文献综述自动化乃至科研写作智能体构建中发挥关键作用。该数据集尤以覆盖NeurIPS、ICML、CVPR等顶会论文的完整章节内容见长,为文本生成领域的细粒度建模与跨学科知识迁移提供了坚实的数据基础。
实际应用
在实际应用层面,ResearchScope-Papers数据集为科研工具与教育平台的智能化升级注入了活力。它可用于构建论文摘要生成器,帮助研究人员快速把握领域前沿动态;也可赋能学术搜索引擎,通过深度学习模型对论文标题、摘要与全文进行语义匹配,提升检索的精确度与召回率。此外,基于该数据集训练的写作辅助工具能够自动生成论文引言、衔接相关工作,甚至为实验部分提供假说驱动的文本草稿,极大缩短了论文撰写周期。对于学术出版机构与预印本平台而言,它还能辅助自动化审稿初筛、研究影响力评估以及跨学科推荐系统的开发,真正实现了数据驱动下的科研流程再造。
衍生相关工作
围绕ResearchScope-Papers数据集已涌现出一系列具有启发性的衍生工作。在论文结构生成方面,研究者基于其章节级数据开发了面向特定部分(如方法或实验)的专用语言模型,能够根据上下文自动补全论文的逻辑链条。在学术知识图谱构建领域,该数据集的作者与引用信息被用于训练论文-作者-学术会议的多维关系预测模型,促进了科研合作网络的深度分析。此外,部分工作将该数据集作为基准,评估对比不同规模的预训练模型在论文摘要与关键贡献抽取任务上的表现,进而催生了更为鲁棒的学术文本理解评价体系。这些衍生研究不仅验证了数据集的广泛适用性,也为未来科研智能体的开发奠定了理论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

