
遇见数据集

Kukedlc/Personas-Argentinas-1k

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

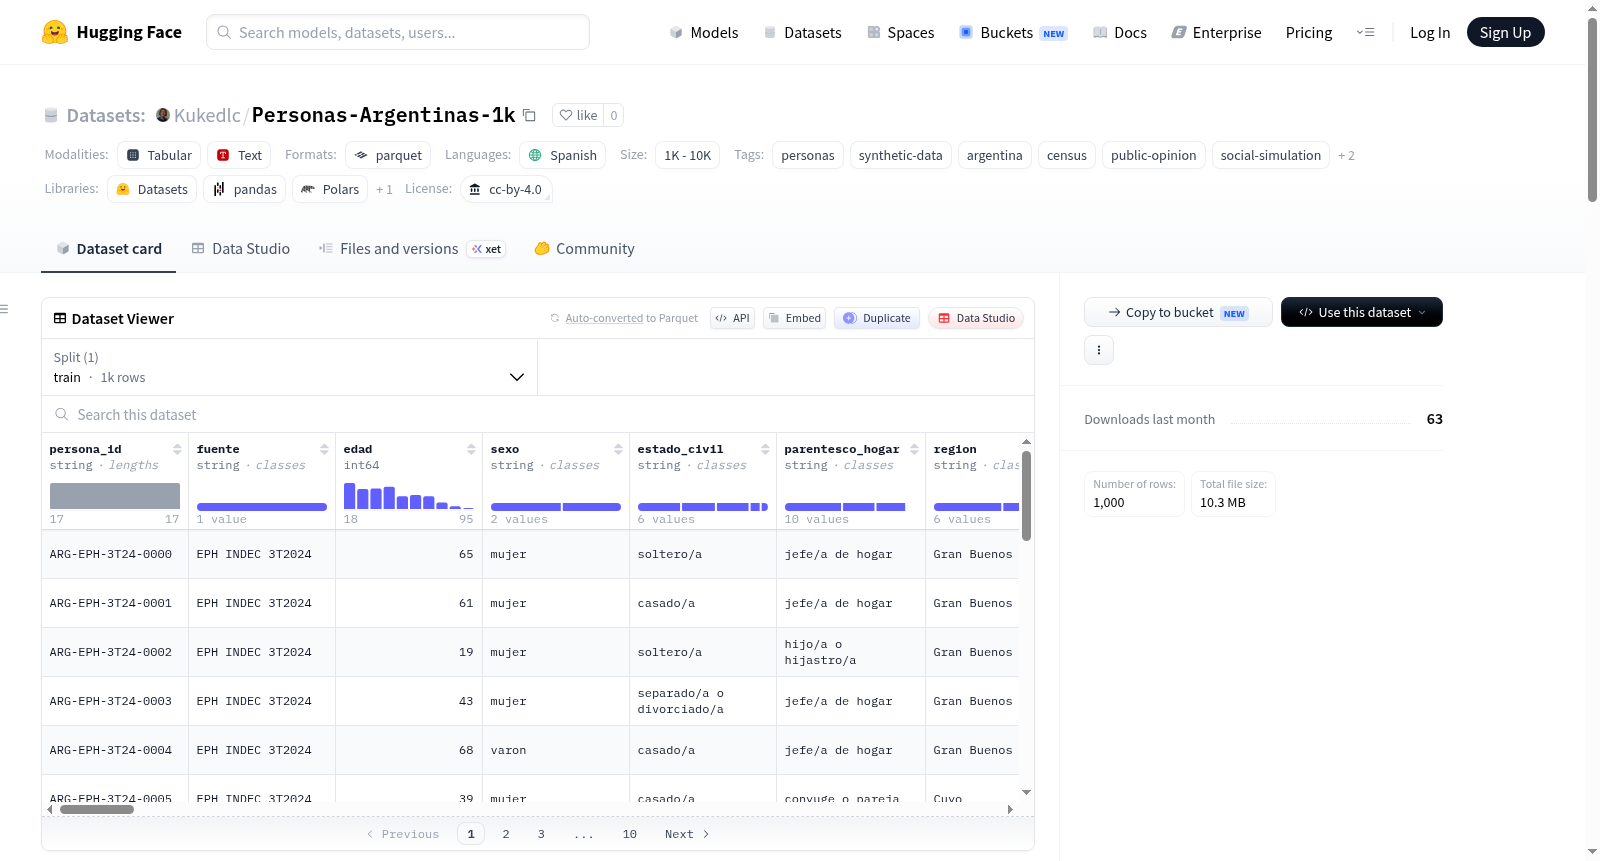
Personas Argentinas是一个多用途的合成数据集,包含1000个阿根廷人的合成人口,基于官方统计来源(如阿根廷国家统计和普查局INDEC的永久家庭调查EPH、2022年全国人口普查、Latinobarómetro 2023阿根廷民意调查等)构建,具有统计严谨性。每个合成人物整合了以下信息:基于人口普查和官方调查锚定的人口统计学和社会经济特征(如年龄、性别、教育水平、职业、收入、地区等);基于大五人格模型(OCEAN)的个性档案;通过分层统计插值方法基于真实民意调查数据校准的意见、价值观和意识形态立场(如左-右意识形态、投票意向、对机构的信任度等);以及连贯的传记(包括生活史、区域语言风格、兴趣、目标等)。数据集旨在支持可重复研究、社会模拟、人口建模、合成调查和焦点小组、受众细分测试,以及具有个性和对话的智能体开发。数据以JSON Lines和Parquet格式提供,包含71列。数据集是持续扩展的第一个版本,主要覆盖城市人口,并注意了内部一致性和多样性控制。

Personas Argentinas is a multipurpose synthetic dataset comprising a synthetic population of 1000 Argentine individuals, constructed with statistical rigor from official sources. Each synthetic person integrates demographics anchored in the national census and official surveys, a personality profile, an opinion and values positioning calibrated against real data, and a coherent biography. It is designed for reproducible research, social simulation, and population modeling. The dataset is based on official statistical sources such as INDECs Permanent Household Survey (EPH), the 2022 National Census, Latinobarómetro 2023 Argentina public opinion survey, and others. It includes 71 columns covering demographics, personality (Big Five OCEAN traits), opinion and values (e.g., ideology, voting intention, institutional trust), and a dense biography. The data is provided in JSON Lines and Parquet formats. This is the first version, continuously expanding, with a focus on urban populations and controlled for internal coherence and diversity.
提供机构:
Kukedlc
搜集汇总
数据集介绍
Kukedlc/Personas-Argentinas-1k 数据集图片
构建方式
该数据集基于阿根廷国家统计与普查研究所(INDEC)2024年第三季度永久住户调查(EPH)的微观数据,通过按人口权重比例抽样,保留年龄、教育、职业、收入、地区与家庭结构等变量的联合分布,构建了1000名具有真实代表性的合成阿根廷人口。价值观与意见模块则采用分层热卡插补法,锚定于2023年拉丁晴雨表调查数据,确保意见分布的总体结构与真实人口一致。人格特质依据大五人格模型,结合已知的人口统计学效应生成百分位评分。每名个体的传记信息均经过内部一致性审核与语言校验,避免矛盾与同质化,从而保留社会人口中真实存在的异质性组合。
特点
数据集的核心优势在于其多维度有机整合与统计真实性。人口统计学特征直接源自官方调查的联合分布,而非独立抽样,这保证了诸如“高学历低收入”等真实存在的非典型组合得以呈现。意见与价值观数据经校准后,其加总分布(如投票意向、制度信任)与原始调查高度吻合,使合成人口在模拟公共舆论时具备生态效度。每一份人物档案均包含71个字段,涵盖人口学、大五人格、详尽的社会政治态度、宗教信仰、职业编码及一段带有区域表达风格的生活史叙事,可支撑从微观仿真到角色扮演的多元研究需求。
使用方法
数据集以JSONL和Parquet两种格式发布,便于不同技术背景的研究者灵活调用。JSONL格式保留了所有嵌套字段的原始结构,适合需要完整人物描述的代理仿真或自然语言生成任务;Parquet格式则将嵌套字段序列化为JSON字符串,便于在Python的Pandas或R的data.table中进行快速的聚合统计与数据分析。使用者可直接加载全体数据,依据性别、年龄、教育层次或地区等任意维度进行子群抽样,用于构建多智能体社会仿真、开展虚拟焦点小组测试、预研选举模型,或作为自然语言处理研究中阿根廷地区西班牙语角色扮演与对话系统的基准人格语料库。
背景与挑战
背景概述
Personas-Argentinas-1k数据集由研究团队基于阿根廷国家统计与普查研究所(INDEC)的永久住户调查(EPH)、2022年全国人口普查,以及拉丁裔晴雨表2023年公众意见调查等多源官方数据,于2024年构建而成。该数据集旨在解决社会模拟、意见动态研究和计算社会科学中缺乏真实代表性合成人口的问题,提供了1000名具备统计学严谨性的阿根廷合成个体。通过保留年龄、教育、收入、区域等属性的联合分布,并利用分层热卡插补法校准价值观与投票意向,该数据集在复现真实人口异质性的同时,避免了传统独立采样导致的不合理组合,为调查预测试、角色扮演代理及可复现的群体实验提供了坚实基准。其影响力体现在:作为首个整合官方微观数据与心理人格模型的阿根廷多用途合成群体,推动了拉丁美洲计算社会科学的实证基础建设。
当前挑战
所解决的领域挑战在于:现有合成人口数据集常因属性独立采样而产生不符合现实的个体组合,无法有效支撑对真实社会结构的模拟;Personas-Argentinas-1k通过保留官方微观数据的联合分布和校准意见数据,确保了群体层面的统计真实性,克服了研究中的代表性偏差。构建过程中的挑战包括:将来源不同、分类体系各异的官方数据(如EPH的城乡覆盖差异、拉丁裔晴雨表的政党标签随时间变迁)进行对齐和标准化,同时保证每个个体内部传记、人格与政治态度的逻辑自洽(如左翼意识形态与环保态度一致),并避免因样本量有限导致罕见但真实存在的群体特征被抹平。此外,数据集仅覆盖城市集合区,尚未纳入农村人口,需在后续版本中扩展校准范围以提升全国代表性。
常用场景
经典使用场景
Personas-Argentinas-1k 数据集为社会科学计算与人口模拟领域提供了一座精巧的桥梁,其经典使用场景聚焦于多智能体社会仿真与随机对照实验。研究人员可依托该数据集构建具有真实人口统计学特征与心理属性的合成智能体群体,进而模拟选举投票、舆论演化、政策接受度测试等复杂社会互动过程。该数据集的精髓在于其不仅保留了年龄、教育、收入等维度的联合分布,更融入了基于拉丁裔民调校准的思想立场与人格特质,使得模拟结果能够逼近真实社会的异质性与涌现模式,为探究微观个体行为如何汇聚为宏观社会现象提供了坚实的数据基础。
衍生相关工作
该数据集的发布已催生了一系列富有成效的后续工作。在方法论层面,研究者借鉴其构建合成人口的联合分布保真度审计框架,开发出评估合成数据与现实数据之间多维度匹配程度的统计指标。在应用拓展方面,围绕该数据集衍生了基准测试专用模块,用于评估语言模型在模拟阿根廷政治对话时的党派偏见程度与事实准确性。此外,一个值得关注的横向迁移工作是将该数据集的构建范式——即融合普查微观数据与大范围社会调查的加权插补流程——适配至智利和巴西的官方数据源,生成了可比较的南锥体国家合成人口集合,从而为跨国比较研究提供了标准化的数据基础设施。
数据集最近研究
最新研究方向
Personas-Argentinas-1k数据集代表了合成人口建模领域的前沿突破,它通过严格对齐阿根廷官方普查与调查数据(如INDEC的EPH和Latinobarómetro),生成了1000个兼具人口统计、人格特质、社会态度与连贯传记的虚拟个体。当前研究热点集中在利用此类高保真合成群体进行社会模拟与计算社会科学实验,例如代替真实受访者开展民意调查预测试、构建具备文化背景的角色扮演代理、以及复现选举行为与制度信任的结构性分布。该数据集的独特价值在于其保留了属性间的联合分布与真实异质性,避免了传统抽样方法的组合失真,为可重复的跨学科研究提供了标准化基准,同时也引发了对合成数据伦理边界与透明度规范的深入探讨。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

