semantic-job-search-dataset
收藏资源简介:
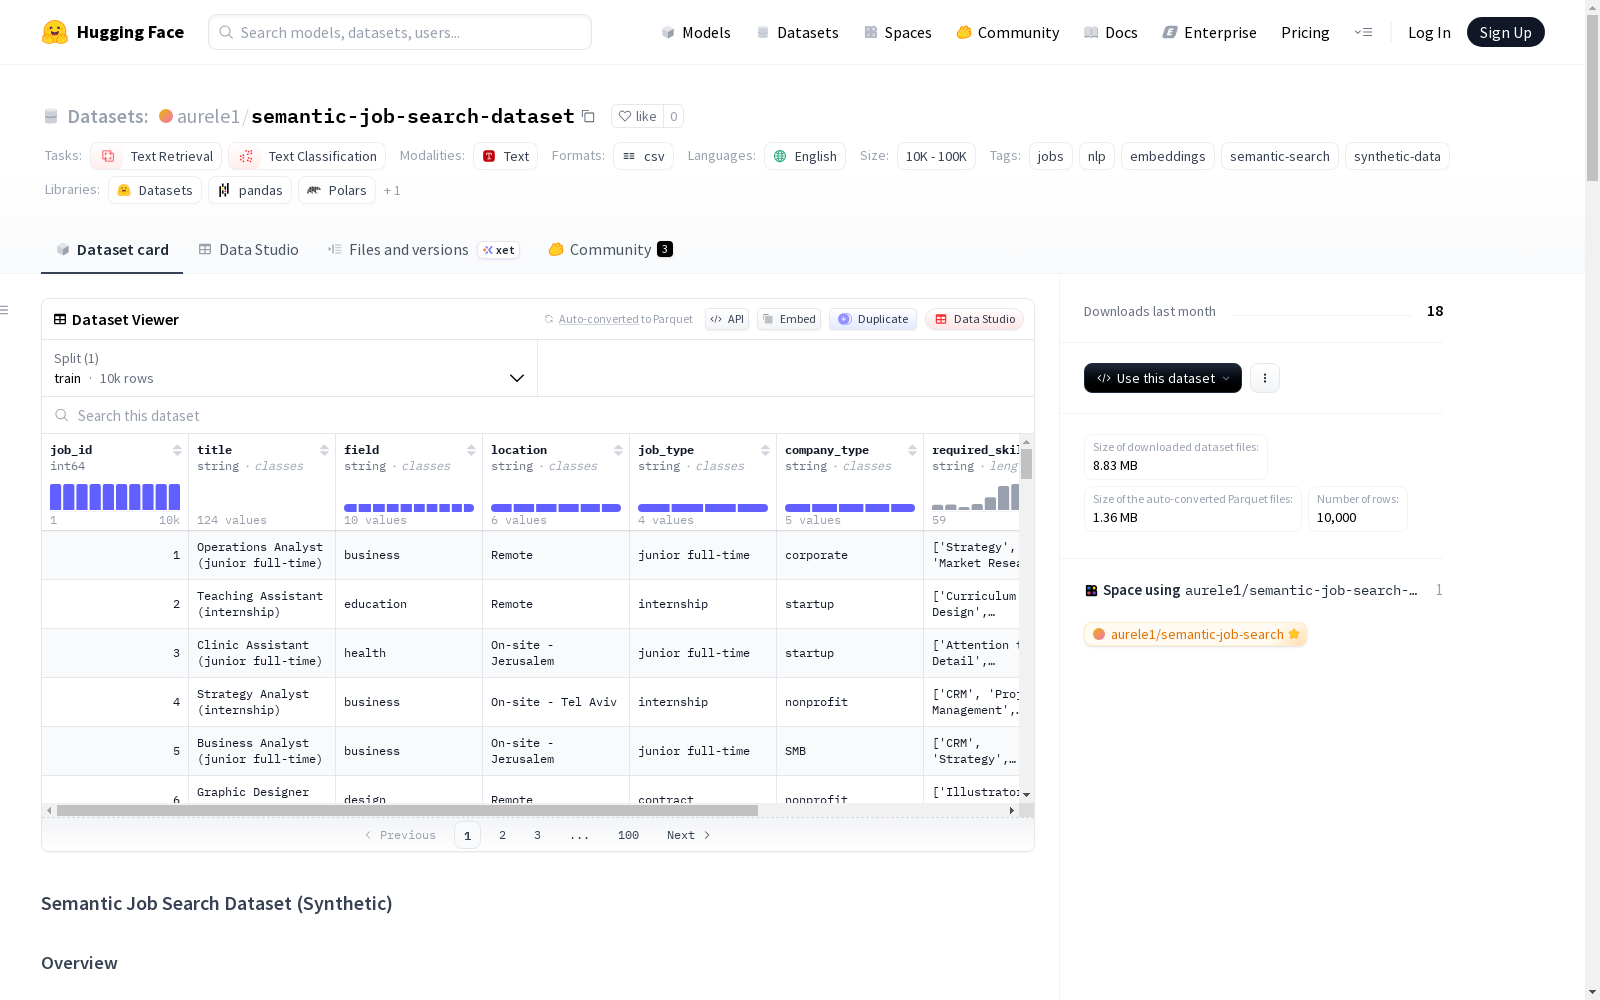
该数据集包含10,000条合成的职位发布数据,专为语义搜索和NLP实验设计。每条记录代表一个职位列表,包含结构化属性(如领域、地点、职位类型)和简短的自然语言描述。数据集是课程最终项目的一部分,用于支持使用Sentence-Transformer嵌入和余弦相似度进行语义职位搜索的Gradio应用。数据集还包含了嵌入模型的使用和语义检索管道的实现细节,适用于语义搜索/检索实验、嵌入模型比较、聚类和相似性分析等用途。所有条目均为合成生成,用于教育和基准测试目的。
Semantic Job Search Dataset (Synthetic) 数据集概述
数据集基本信息
- 数据集名称:Semantic Job Search Dataset (Synthetic)
- 语言:英语
- 类型:合成数据
- 标签:jobs, nlp, embeddings, semantic-search, synthetic-data
- 任务类别:text-retrieval, text-classification
- 规模类别:10K<n<100K
- 数据量:10,000 条记录
- 字段数:9 列
数据集内容与结构
该数据集包含 10,000 条合成的招聘信息,专为语义搜索和 NLP 实验设计。每条记录代表一份招聘信息,包含结构化属性和简短的自然语言描述。
数据模式
每条记录包含以下字段:
- title (字符串):职位名称
- field (字符串):领域/类别(例如,数据、市场营销、软件)
- location (字符串):工作地点格式(例如,现场办公 / 混合办公 / 远程办公 + 城市)
- job_type (字符串):雇佣类型(例如,实习、全职、合同)
- company_type (字符串):组织类型(例如,初创公司、企业、代理机构)
- required_skills (字符串):逗号分隔的技能列表
- tags (字符串):逗号分隔的标签/关键词
- description (字符串):简短的自然语言职位描述
- skill_count (整数):从
required_skills中提取的技能数量
探索性数据分析摘要
基本统计
- 数据集平衡且完全结构化,各记录格式一致。
- 添加了派生特征 skill_count 以量化每个职位所需的技能数量。
技能数量分布
skill_count(每个职位的技能数量)摘要:
- 平均值:3.79
- 中位数:4
- 最小值 / 最大值:0 / 10
- 标准差:2.21
描述长度(以单词计)
职位描述简短且长度一致:
- 平均值:87.58
- 标准差:1.46
- 最小值 / 最大值:80 / 93 这种一致性有助于语义搜索模型的基准测试,因为它减少了由极短/极长文本引起的差异。
可视化摘要图表
- 各领域职位分布:

- 职位描述长度分布:

- 各领域内职位类型分布:

数据处理与应用
嵌入生成
数据集使用多个 Hugging Face Sentence-Transformer 模型(MiniLM、MPNet 和 BGE)进行了嵌入。嵌入被保存为 .npy 文件并进行 L2 归一化,以支持通过点积进行快速余弦相似度检索。基于轻量级检索评估和实际考虑(嵌入大小和效率),MiniLM 被选为最终部署模型。
语义检索流程
实现了一个端到端的语义检索流程:用户查询被转换为嵌入,与预计算的职位嵌入计算余弦相似度,系统返回最相似的 Top-K 职位信息及其关键元数据。
应用演示
在 Hugging Face Spaces 上部署了一个 Gradio 应用程序,用于演示语义职位搜索系统。该应用程序直接从该 Hugging Face 数据集存储库加载数据集,从 Space 加载选定的嵌入文件,并提供三个“快速入门”查询用于一键演示。
预期用途
该数据集适用于:
- 语义搜索/检索实验
- 嵌入模型比较(质量 vs. 大小 vs. 速度)
- 聚类、相似性分析和轻量级 NLP 流程
- 构建演示应用程序(例如,Gradio + Hugging Face Spaces)
关于合成数据的说明
所有条目均使用预训练语言模型合成生成,旨在用于教育和基准测试目的(非真实招聘信息)。
项目文件(建议)
为完整记录项目,数据集存储库还应包含:
EDA.ipynb(探索性数据分析笔记本)Synthetic_Data_Generation.ipynb(数据生成笔记本)