
MCG-NJU/Seeker-173K
收藏官方服务:
资源简介:
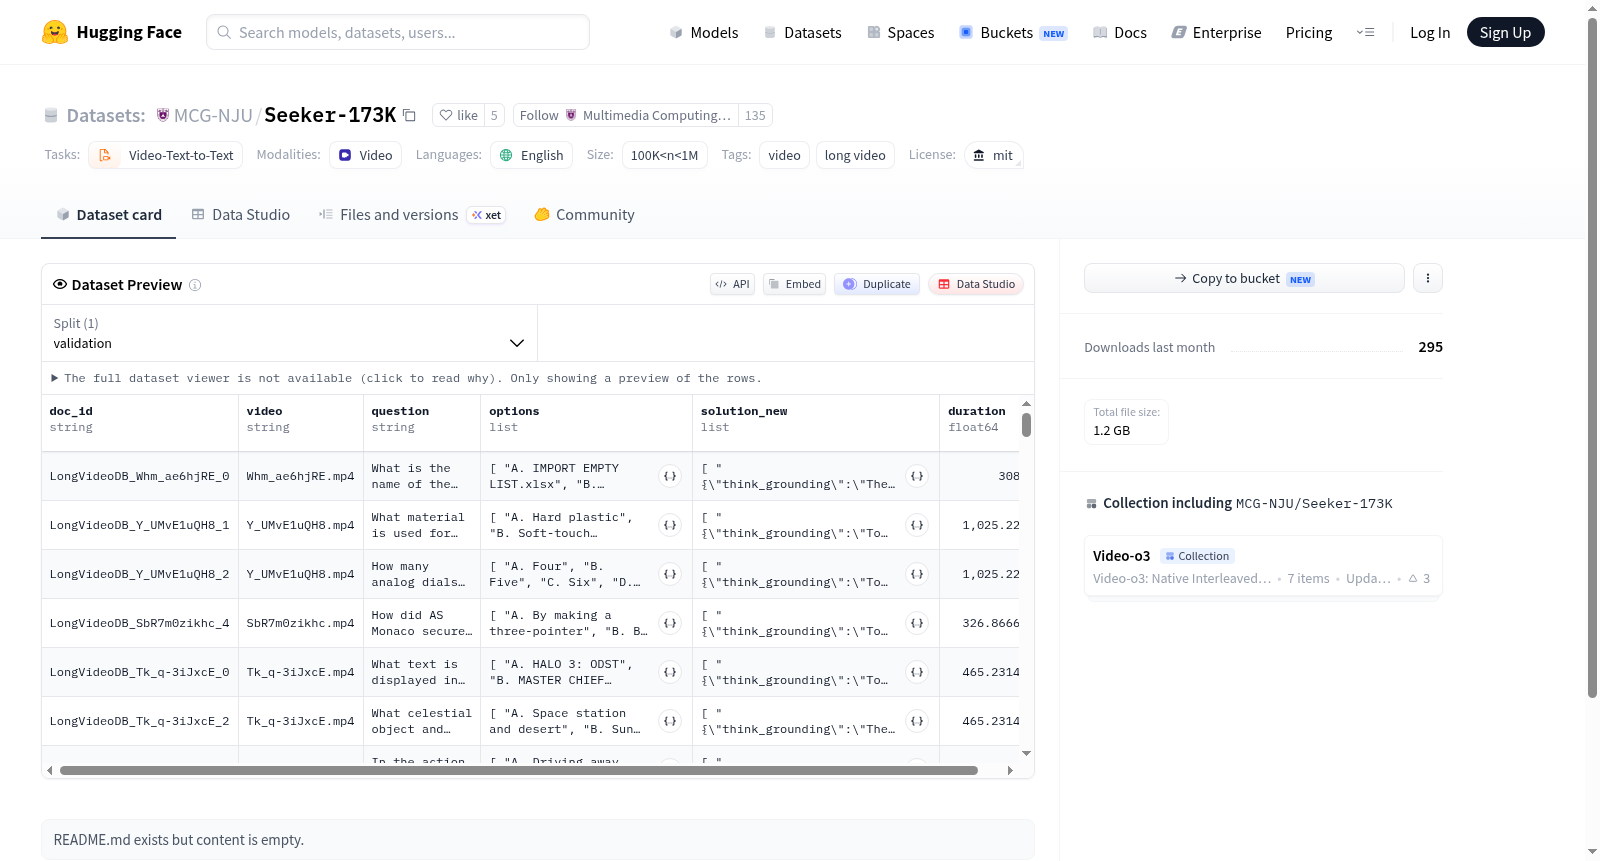
一个用于视频-文本到文本任务的数据集,专注于长视频,包含100K到1M个样本。
A dataset for video-text-to-text tasks, focusing on long videos, with 100K to 1M samples.
提供机构:
MCG-NJU搜集汇总
数据集介绍
构建方式
Seeker-173K数据集构建于大规模视频理解领域,旨在弥合长视频与文本描述之间的语义鸿沟。该数据集通过系统性地收集和筛选来自公开来源的长视频片段,并配以精细的人工标注与自动清洗流程,确保每一条视频-文本对均具备高度相关性。构建过程中,研究团队综合运用了时间戳对齐、关键帧提取以及多轮质检机制,最终形成了173K规模的高质量样本库,为长视频推理任务奠定坚实基础。
使用方法
使用者可通过HuggingFace平台直接加载Seeker-173K数据集,利用内置的Python接口将其无缝集成至视频-文本多模态模型训练流程。推荐将视频帧序列与对应文本标注进行配对,并借助预训练视觉编码器与文本解码器构建端到端架构。在训练过程中,建议采用动态帧采样策略以适配长视频特性,同时可结合数据增强技术如时空裁剪来提升模型泛化能力。数据集已按标准格式划分训练集与验证集,便于直接用于序列到序列或对比学习范式。
背景与挑战
背景概述
随着多模态学习领域的蓬勃发展,长视频理解成为计算机视觉与自然语言处理交叉研究的前沿焦点。现有数据集多聚焦于短视频片段,难以支撑对分钟级乃至更长时间跨度的视频内容进行深度语义理解。在此背景下,Seeker-173K数据集应运而生,由研究者于近年构建,采用MIT开源协议,旨在推动视频到文本生成任务的发展。该数据集包含超过17.3万个样本,覆盖英文标注,专注于长视频理解,为模型在复杂叙事结构、跨帧事件关联等任务上提供了丰富的训练与评估资源。其发布不仅弥补了学术界在长视频理解基准上的空白,更对视频问答、自动字幕生成等领域产生了重要推动作用。
当前挑战
Seeker-173K所解决的领域核心挑战在于长视频理解中的时空上下文建模与语义压缩问题:传统方法难以在保留关键信息的同时处理数分钟视频带来的计算开销与信息冗余。构建过程中,数据采集需从海量视频中筛选出具有连贯叙事的长片段,并确保标注质量与时间跨度平衡;同时,标注人员需要面对跨帧事件追踪、多模态对齐等复杂任务,仅依靠单帧或短片段标注经验难以准确描述长时序依赖关系。此外,数据集规模与长视频存储、处理资源的矛盾也构成了技术瓶颈,如何在有限成本下维持数据多样性并避免标注偏差,是构建过程中必须克服的关键挑战。
常用场景
经典使用场景
Seeker-173K数据集专注于长视频文本检索与生成任务,是视频理解与自然语言处理交叉领域的重要资源。该数据集包含超过17万条视频-文本对,覆盖丰富的长视频片段,旨在推动模型对时间跨度长、语义复杂的视频内容进行精确语意对齐。经典使用场景包括基于视频片段的自动摘要生成、关键事件定位以及跨模态检索,尤其在需要理解视频整体叙事逻辑与动态演变的场景中展现独特价值。研究者可利用该数据集训练模型从海量视频中高效筛选出与查询意图匹配的内容,或生成连贯的文本描述以概括视频核心情节。
解决学术问题
在学术研究中,Seeker-173K主要解决了长视频理解中跨模态语义匹配困难、时序信息建模不足等关键问题。传统视频文本数据集多聚焦于短视频片段,难以支撑对时长较长、内容多变的视频进行深度分析。该数据集通过提供大规模、高多样性的长视频文本对,使研究者能够探索如何捕捉视频帧间的长距离依赖关系与事件演变模式。其意义在于,为构建能够理解完整视频故事线的智能系统奠定了数据基础,推动视频描述生成、时序动作定位和信息检索等任务从短片段向长视频场景拓展,显著提升了模型在真实复杂环境下的泛化能力。
实际应用
实际应用中,Seeker-173K所支撑的技术可广泛部署于智能视频监控、影视内容管理与在线教育平台。在监控安防领域,模型能够自动分析长时监控录像,快速定位异常事件并生成简洁的文字报告;在影视媒体行业,可用于自动为长视频生成标签、摘要或字幕,极大提升内容检索与归档效率。在线教育场景下,该数据集帮助模型理解教学视频的完整流程,自动提炼知识点与时间节点,辅助学生高效复习。此外,Seeker-173K还适用于视障辅助系统,通过将视频实时转换为语音描述,增强信息可访问性,从而在无障碍技术领域发挥重要社会价值。
数据集最近研究
最新研究方向
在视频理解与生成的前沿领域,Seeker-173K数据集为长视频与文本对齐任务提供了关键支撑。随着多模态大模型对时序动态建模需求的激增,该数据集聚焦于超10万量级的长视频样本,弥补了现有基准在持续时间与语义复杂性上的不足。其研究导向紧密关联近期多模态叙事生成、视频问答与检索等热点,尤其适配于需要跨帧上下文推理的复杂场景。通过涵盖百万级样本的细粒度标注,Seeker-173K推动了长视频表征学习从片段的静态匹配向动态故事理解的范式跃迁,为构建具备持久记忆与因果推理能力的视觉语言系统奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


