
SeanSha30/swedish-pre-a1-learning-agent-dataset
收藏官方服务:
资源简介:
该数据集是一个结构化的Pre-A1级别瑞典语学习资源,适用于小型学习代理。它包含词汇、句子示例、对话功能定义和对话规划序列,覆盖六个日常生活场景。
This dataset is a structured Pre-A1 Swedish learning resource for a small learning agent. It includes vocabulary, sentence examples, dialogue function definitions, and dialogue planning sequences across six daily-life scenarios.
提供机构:
SeanSha30搜集汇总
数据集介绍
构建方式
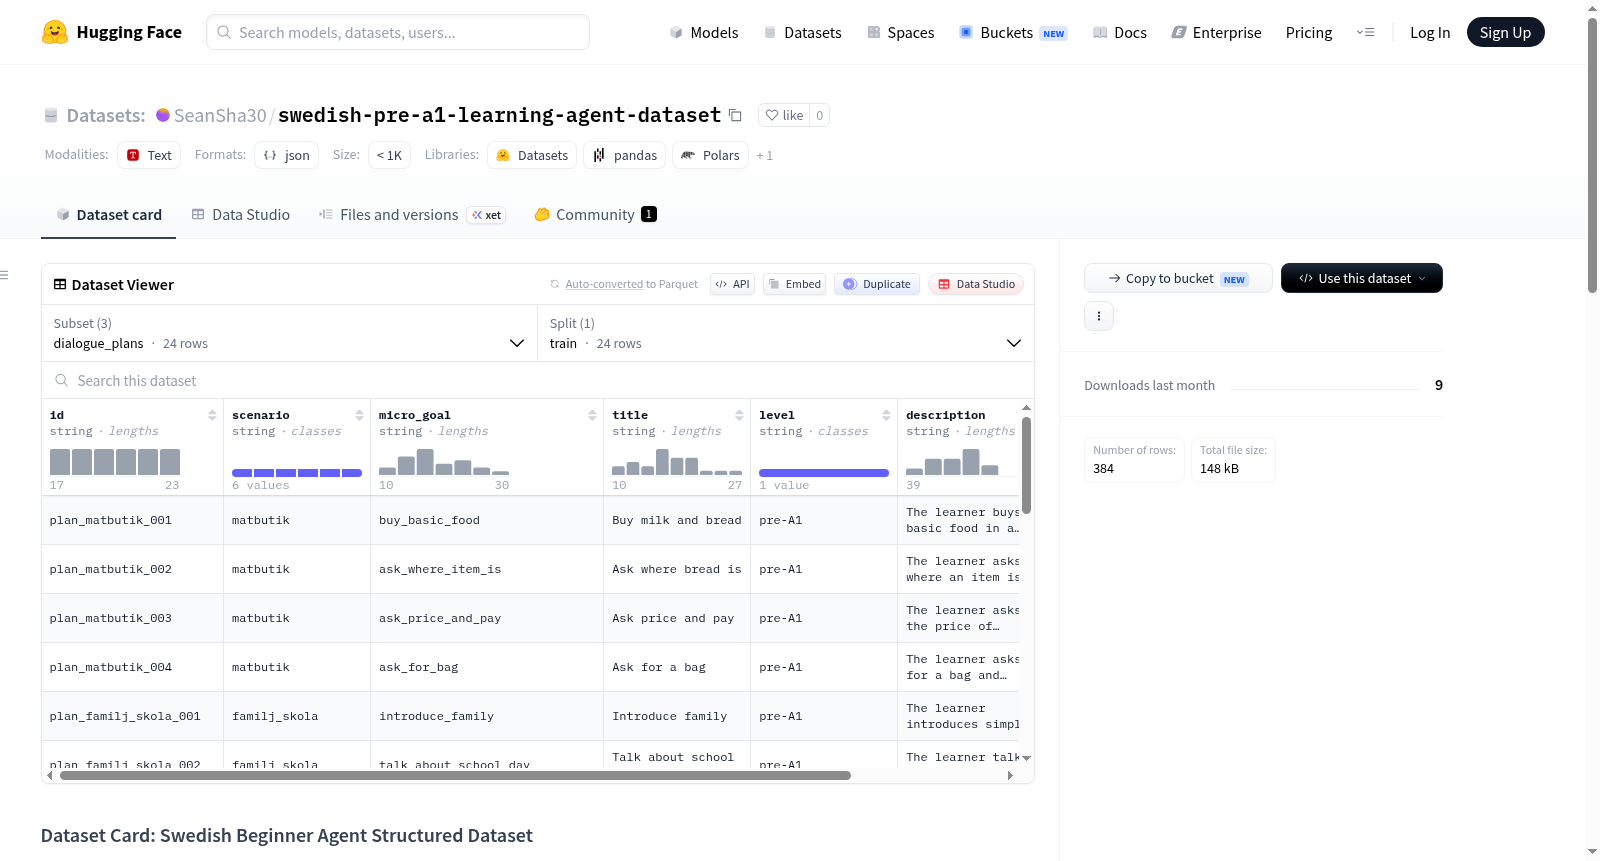
该数据集专为瑞典语初学者(Pre-A1级别)设计,旨在支撑小型学习代理的交互式语言习得。构建过程融合了人工智能辅助生成与人工结构化整理,聚焦于六种日常生活场景,系统性地收录了基础词汇、句型范例及对话流程。数据以三类JSONL文件组织:词汇表(vocabulary.jsonl)包含单词及其英中释义、词性、场景归属与例句;句子示例(sentence_examples.jsonl)提供带功能标签和上下文槽位的完整句子;对话规划(dialogue_plans.jsonl)则定义了从微观目标到序列步骤的骨架,每一部分均经过人工校验以确保准确性与教学适配性。
特点
该数据集最突出的特点在于其为小规模学习代理量身定制的结构化设计。词汇、句子与对话计划三者紧密关联,通过场景、等级、功能等字段实现跨模块检索与衔接,支持检索增强生成(RAG)与多轮对话的连贯输出。此外,数据涵盖瑞典语、英语与中文三语注释,便于不同母语背景的初学者理解。其内容高度简化,专注于Pre-A1级别的核心表达,避免了复杂语法与生僻词汇,从而降低认知负荷,提升学习效率。
使用方法
使用者可基于HuggingFace Datasets库直接加载该数据集的三个子配置(vocabulary、sentence_examples、dialogue_plans),并根据需求将其整合至语言学习代理的流水线中。例如,利用词汇子集进行单词解释与练习生成,借助句子示例子集实现基于场景的例句检索,或采用对话计划子集作为模板驱动多轮对话的自动生成。该数据集特别适用于教学演示、原型开发及初步的对话系统验证,但需注意其规模有限且为合成数据,正式教学场景下建议由母语者进行审校与扩充。
背景与挑战
背景概述
该数据集名为Swedish Beginner Agent Structured Dataset,创建于当代自然语言处理与教育技术交叉领域,由专注于低资源语言学习智能体的研究团队构建。核心研究问题在于如何为瑞典语零基础学习者(Pre-A1级别)提供结构化、可检索的语料资源,以支持小规模学习代理的对话生成与词汇解释。数据集涵盖词汇、例句及对话规划,涉及六个日常场景,并辅以英文和中文翻译,旨在弥合传统教材与智能语言学习系统之间的鸿沟。其影响力主要体现在为检索增强型瑞典语学习代理、初学者对话生成及简单练习创建提供了基准资源,推动了多模态、低资源语言教育数据集的标准化与实用化。
当前挑战
该数据集面临的首要挑战是所解决的领域问题:在瑞典语初学者学习场景中,现有教育资源多偏向静态教材,缺乏动态、可交互且适配智能代理的结构化语料,导致学习代理难以生成连贯且符合语境的对话。构建过程中,主要挑战包括数据规模有限且完全为合成生成,虽经人工辅助结构化,但语言真实性和文化适切性有待母语者验证;此外,部分翻译为适配初学者简化,可能丢失细微语义,影响准确性。多语言注释(瑞典语、英语、中文)的一致性维护亦构成难点,尤其是在功能架构与对话规划序列的映射过程中,需确保跨语言标签的严谨对齐以支持可靠的检索增强生成。
常用场景
经典使用场景
在语言学习与智能教育领域,该数据集为构建面向零基础瑞典语学习者的对话式教学代理提供了核心资源。它覆盖了购物、用餐、问路等六个日常生活场景,每个场景均包含结构化的词汇表、例句库以及对话规划序列,使得学习代理能够实现基于检索的词汇解释、场景化句子生成与连贯对话管理。这种设计不仅适合用于构建轻量级的教学演示系统,也为人机交互中的任务型对话生成实验提供了可复现的基准数据。
衍生相关工作
该数据集的发布催生了若干衍生研究方向,包括:基于其多层级结构化标签设计的小样本对话状态追踪模型;利用其对话计划序列进行意图解耦与微调指令生成的工作;以及将其作为辅助数据用于预训练语言模型在瑞典语场景理解任务上的零样本微调。部分研究者还借鉴其三级数据架构,构建了面向其他低资源语言(如芬兰语、冰岛语)的类似学习代理数据集。
数据集最近研究
最新研究方向
该数据集专为初级瑞典语学习者设计,整合了词汇、例句与对话规划三重结构,契合当前低资源语言学习智能体与检索增强生成技术的前沿浪潮。在自然语言处理领域,面向A1/Pre-A1水平的精细化教学数据日益稀缺,而本数据集精准聚焦这一空白,覆盖日常生活中的六大场景,提供三语对照与对话功能定义,为构建可解释、可交互的轻量级自适应学习系统提供了基础。它启发研究者探索如何在小型化、合成化数据上实现有效的对话生成与词汇教学,同时也为多语言教育NLP模型在低资源语言上的公平性与可及性研究开辟了实验土壤。
以上内容由遇见数据集搜集并总结生成


