nmrexp-cnmr-peaklist-1.5M
收藏资源简介:
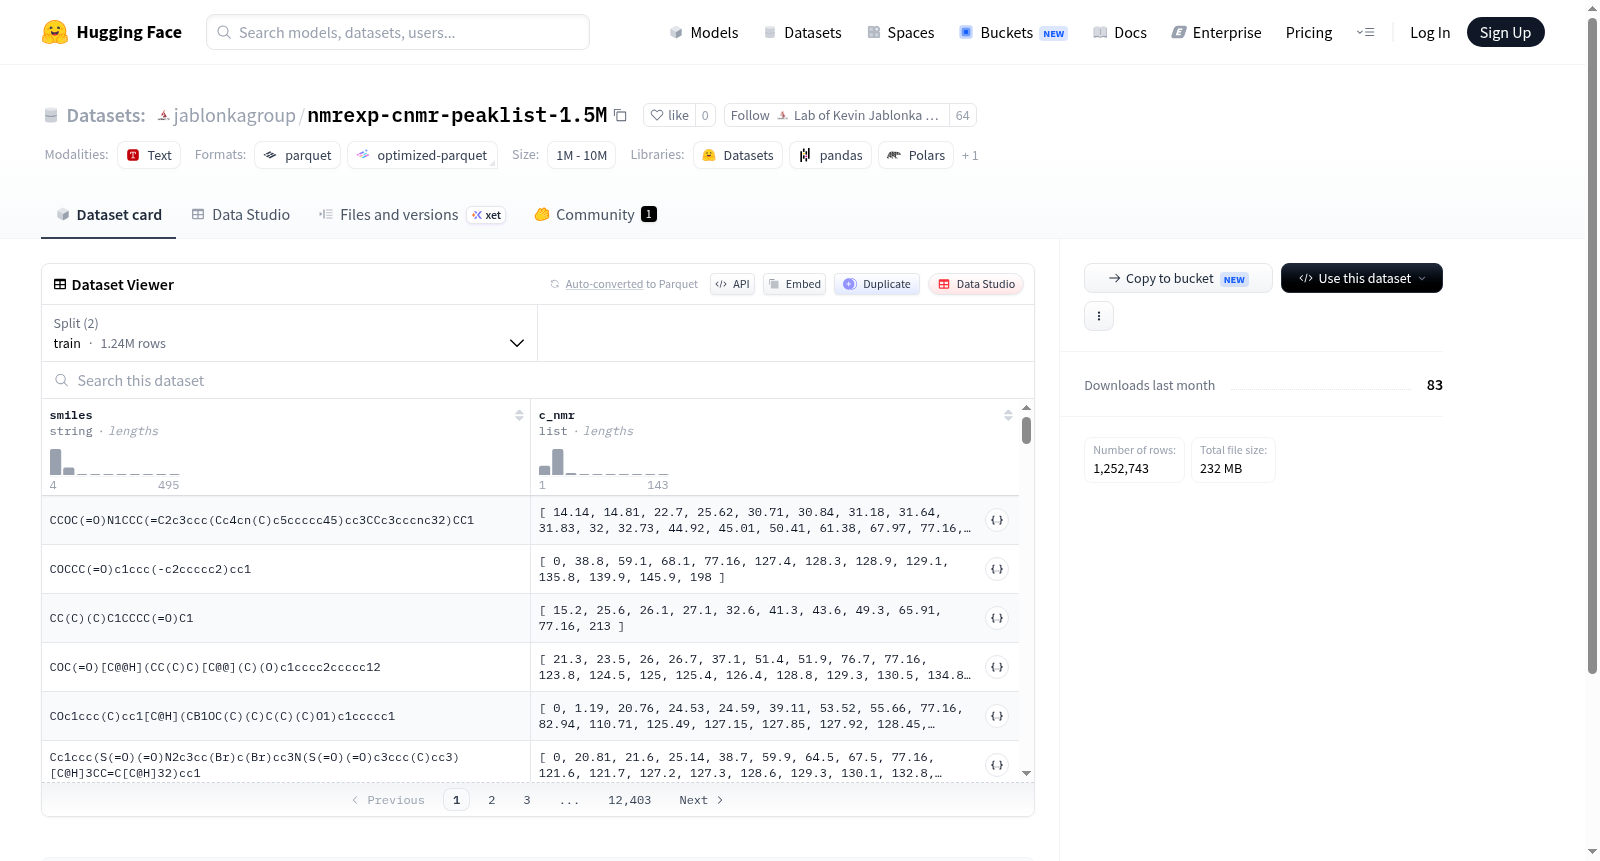
该数据集主要用于碳-13核磁共振(C-NMR)化学位移的预测与分析。数据集中包含分子SMILES表示、碳-13 NMR化学位移列表(c_nmr)、最小化学位移(x_min)、最大化学位移(x_max)、溶剂(solvent)以及核磁共振基频(base_frequency_MHz)。训练集包含1,240,216个样本,验证集包含12,527个样本,总计约125万个样本。数据集可用于训练机器学习模型,以根据分子结构预测碳-13 NMR化学位移,广泛应用于化学信息学、药物发现和分子性质预测等领域。
This dataset is primarily used for the prediction and analysis of carbon-13 nuclear magnetic resonance (C-NMR) chemical shifts. It contains molecular SMILES representations, carbon-13 NMR chemical shift lists (c_nmr), minimum chemical shift (x_min), maximum chemical shift (x_max), solvent (solvent), and nuclear magnetic resonance base frequency (base_frequency_MHz). The training set includes 1,240,216 samples, the validation set includes 12,527 samples, totaling approximately 1.25 million samples. The dataset can be used to train machine learning models to predict carbon-13 NMR chemical shifts based on molecular structure, widely applied in fields such as cheminformatics, drug discovery, and molecular property prediction.
数据集概述
该数据集名为 nmrexp-cnmr-peaklist-1.5M,由 jablonkagroup 发布,是一个用于核磁共振(NMR)领域研究的数据集。数据集的主要内容和结构如下:
-
数据特征:包含两个字段:
smiles(字符串类型):表示分子结构的SMILES表达式。c_nmr(浮点数列表):对应分子的碳-13核磁共振(¹³C NMR)谱峰列表。
-
数据划分:数据集分为训练集和验证集两部分:
- 训练集:包含约 124万 个样本(1,240,216条),数据量约 261.8 MB。
- 验证集:包含约 1.25万 个样本(12,527条),数据量约 2.64 MB。
-
总体规模:数据集总大小约 264.5 MB,下载大小约 232.5 MB,合计样本数超过 125万,符合“1.5M”的名称暗示。
-
文件结构:默认配置下,数据文件以分片形式存储,训练集路径为
data/train-*,验证集路径为data/val-*。
该数据集适用于分子结构解析、NMR谱图预测或相关的机器学习任务,提供了分子SMILES与碳谱峰列表的对应关系。