
kurakurai/MBPP-Plus-FR
收藏官方服务:
资源简介:
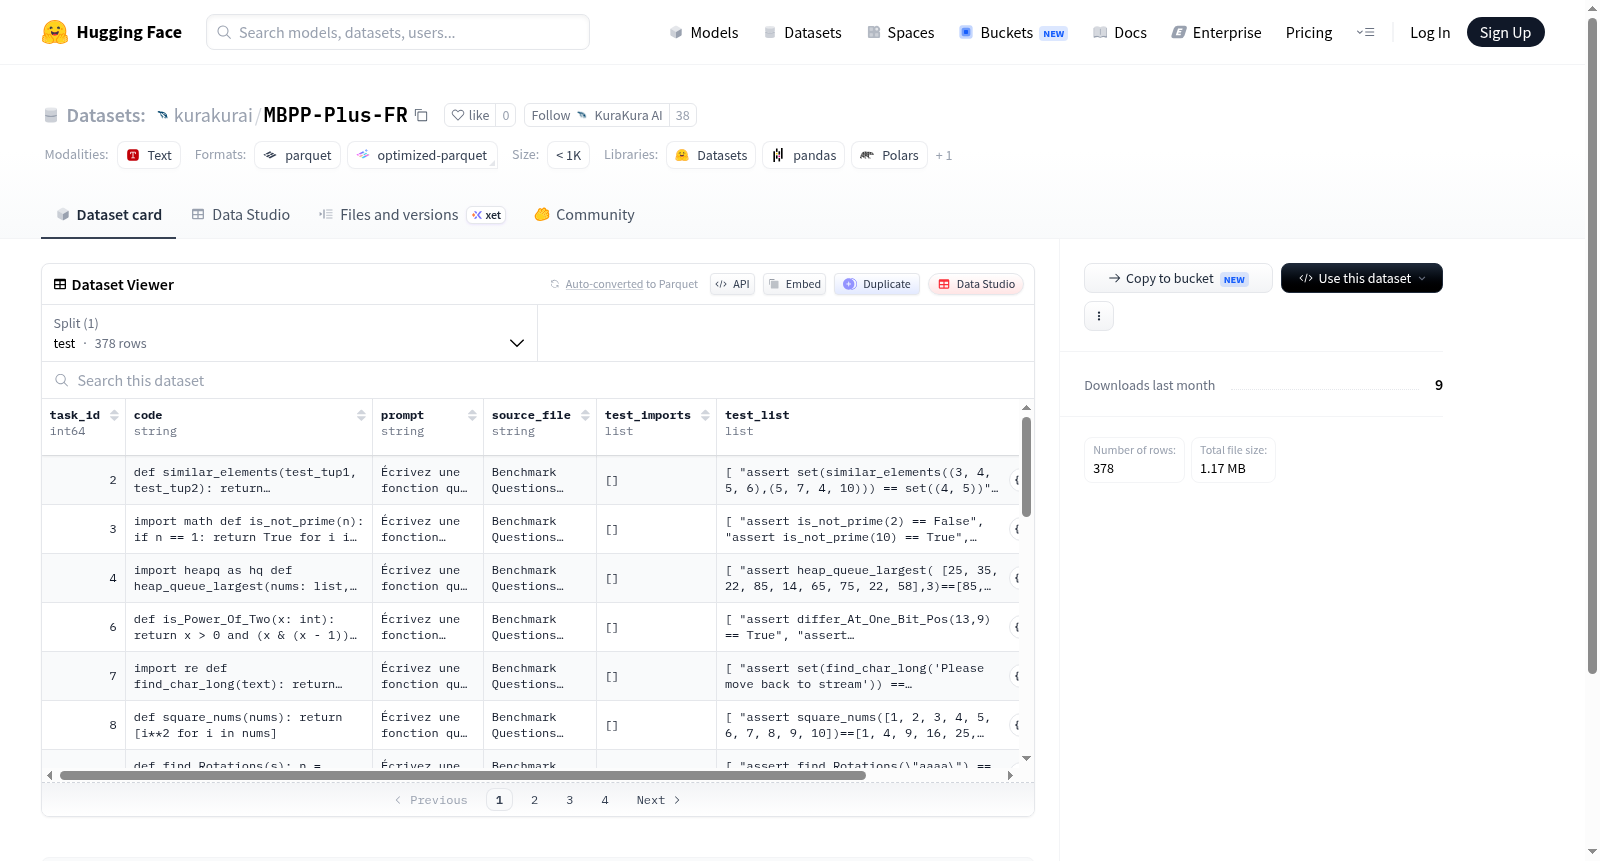
--- dataset_info: features: - name: task_id dtype: int64 - name: code dtype: string - name: prompt dtype: string - name: source_file dtype: string - name: test_imports list: string - name: test_list list: string - name: test dtype: string splits: - name: test num_bytes: 4848252 num_examples: 378 download_size: 1165843 dataset_size: 4848252 configs: - config_name: default data_files: - split: test path: data/test-* ---
提供机构:
kurakurai搜集汇总
数据集介绍
构建方式
MBPP-Plus-FR数据集是基于MBPP(Mostly Basic Programming Problems)数据集扩展和翻译而来的法语版本。原始MBPP数据集包含974个Python编程问题,每个问题由任务描述、代码解决方案和测试用例组成。MBPP-Plus-FR选取了其中378个经过验证的高质量样本,通过人工翻译和校对将问题描述、代码注释及测试用例转换为法语,同时保留了原始数据集的结构化格式。数据集的构建还包括对测试用例的增强,确保每个问题都具备完整的输入输出验证机制,从而保证数据集的可用性和准确性。
使用方法
使用MBPP-Plus-FR数据集时,用户可以通过HuggingFace的datasets库加载数据,指定config为'default'即可获取包含378个样本的测试集。每个样本的'prompt'字段提供法语编程问题描述,'code'字段为参考解决方案,'test_list'和'test'字段提供单元测试。用户可设计模型根据prompt生成代码,然后利用提供的测试用例评估生成代码的通过率。数据集适用于监督学习场景下的代码生成任务评估,特别适合针对法语编程教育需求的研究与开发。
背景与挑战
背景概述
MBPP-Plus-FR数据集是面向法语编程语言理解与生成任务的高质量评估基准,于2023年由法国国家信息与自动化研究所(INRIA)及多家法语区高校联合构建。该数据集以经典的MBPP(Mostly Basic Python Programming)数据集为基础,通过系统化翻译与人工校验,将原有英文编程问题转换至法语语境,旨在弥合非英语母语者在代码生成与程序合成研究中的语言鸿沟。其核心研究问题聚焦于评估大语言模型在法语编程指令下的代码生成能力与鲁棒性,为多语言代码智能领域提供了首个法语标准化测试集。MBPP-Plus-FR的发布显著推动了代码智能在低资源语言场景下的发展,成为衡量模型跨语言泛化性能的关键参考。
当前挑战
该数据集面临的首要挑战是编程任务中法语表达的语义歧义性:法语语法结构与编程逻辑之间的天然差异可能导致模型对问题意图的错误理解,例如动词变位与介词用法可能改变代码生成方向。构建过程中,从英文到法语的翻译需兼顾技术准确性及自然语言流畅性,同时确保测试用例能完全覆盖原有功能逻辑,避免因语言转换引入新的bug或遗漏边界条件。此外,法语编程资源稀缺使得众包标注质量控制尤为困难,需设计严格的双向校验流程以维持答案一致性。最终,仅378个测试样本的规模限制了统计显著性,如何平衡样本数量与人工校验成本是后续扩展的关键瓶颈。
常用场景
经典使用场景
在程序合成与代码生成领域,MBPP-Plus-FR作为经典的MBPP数据集的增强版本,被广泛用于评估和微调大型语言模型在法语环境下的代码生成能力。研究者通常利用其包含的378个编程问题、对应的参考代码及测试用例,检验模型能否根据自然语言描述准确生成可执行代码,尤其是在多语言代码理解与生成场景中,该数据集为法语代码生成任务提供了标准化基准。
解决学术问题
该数据集有效解决了现有代码生成基准(如MBPP)缺乏多语言覆盖的学术问题,特别是针对法语编程任务的评估缺失。通过提供法语描述与代码对,它推动了跨语言代码生成模型的研究,揭示了语言多样性对模型性能的影响,并助力于构建更具文化包容性的编程辅助工具,显著提升了模型在非英语环境下的实用性和鲁棒性。
实际应用
在实际应用中,MBPP-Plus-FR可助力开发面向法语开发者的智能编程助手,如集成在IDE中的代码补全或错误修正工具。教育领域可利用它构建法语编程教学系统,帮助学生通过自然语言描述学习Python编程。此外,该数据集还支持多语言代码搜索引擎的优化,使法语用户能够更高效地检索和重用代码片段。
数据集最近研究
最新研究方向
针对法语编程语言基准测试的MBPP-Plus-FR数据集,近期研究聚焦于代码生成模型在多语言场景下的鲁棒性与泛化能力评估。当前热点在于通过该数据集探究大型语言模型在非英语编程任务中的表现偏差,尤其关注法语自然语言描述到正确代码的映射准确性。研究揭示,现有模型在法语场景下性能显著下降,驱动了跨语言微调策略与数据增强技术的迭代优化,对构建真实世界多语言软件开发工具具有先锋意义。
以上内容由遇见数据集搜集并总结生成


