
tasksource/tomi-nli
收藏官方服务:
资源简介:
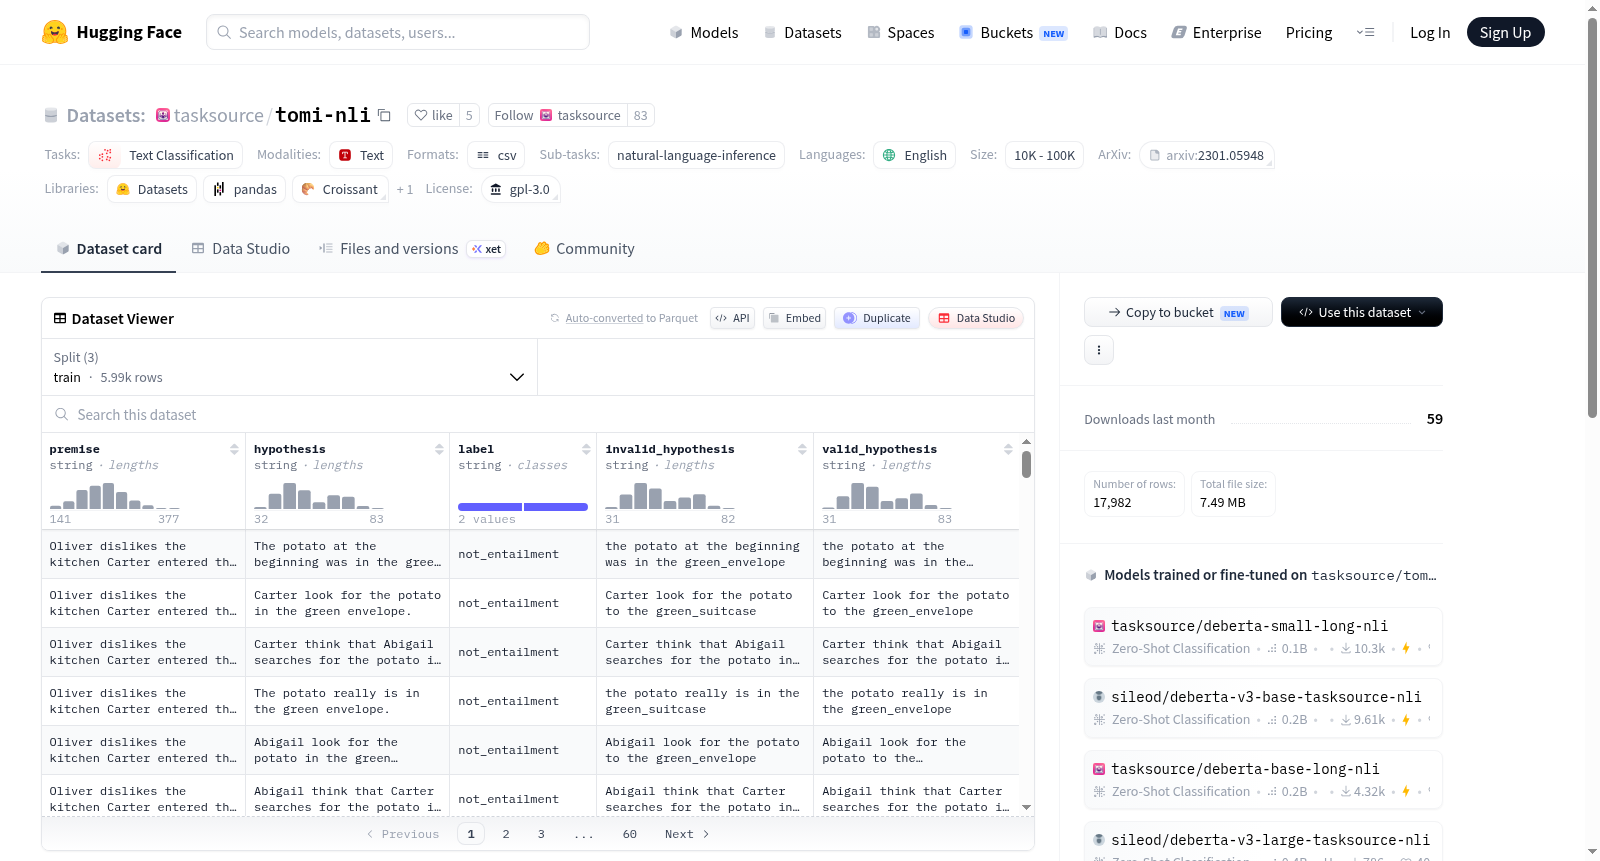
tomi数据集(心理理论问答)被重新构建为自然语言推理任务。该数据集用于文本分类任务,特别是自然语言推理,语言为英语。
The TOMI dataset (Theory of Mind Question Answering) has been reformulated as a natural language inference task. This dataset is designed for text classification tasks, particularly natural language inference, and all its texts are in English.
提供机构:
tasksource原始信息汇总
数据集概述
- 数据集名称:tomi dataset (theory of mind question answering)
- 数据集用途:重新构建为自然语言推理任务
- 任务类型:
- 任务ID:natural-language-inference
- 任务类别:text-classification
- 语言:英语 (en)
- 许可证:GPL-3.0
相关文献
-
文献一:
- 标题:Revisiting the Evaluation of Theory of Mind through Question Answering
- 作者:Le, Matthew; Boureau, Y-Lan; Nickel, Maximilian
- 出版信息:Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP)
- 出版年份:2019
- 出版地点:Hong Kong, China
- 出版机构:Association for Computational Linguistics
- DOI:10.18653/v1/D19-1598
-
文献二:
- 标题:tasksource: Structured Dataset Preprocessing Annotations for Frictionless Extreme Multi-Task Learning and Evaluation
- 作者:Sileo, Damien
- 出版信息:arXiv preprint arXiv:2301.05948
- 出版年份:2023
搜集汇总
数据集介绍
构建方式
在自然语言推理领域,心理理论(Theory of Mind)能力的评估一直是研究热点。tomi-nli数据集基于tomi问答数据集进行重构,将其转化为自然语言推理任务格式。具体而言,原始tomi数据集中关于信念、知识等心理状态的问题被重新表述为蕴含、矛盾或中立的陈述对,从而构建出符合NLI任务规范的高质量样本。这一转换过程保留了原数据集在心理推理方面的核心挑战,同时赋予了模型在更广泛NLI框架下进行推理的能力。
使用方法
tomi-nli数据集可直接用于训练和评估自然语言推理模型。使用者可通过HuggingFace Datasets库加载该数据集,将其划分为训练集、验证集和测试集,并应用于标准的NLI分类流程。模型需对每个样本输出蕴含、矛盾或中立三类标签之一。为便于快速上手,官方提供了Colab Notebook示例,展示了数据加载、预处理及模型微调的全过程。研究者亦可将其作为多任务学习中的子任务,提升模型在社交推理方面的泛化能力。
背景与挑战
背景概述
在自然语言处理领域,心理理论(Theory of Mind)能力被视为衡量机器智能理解人类认知状态的重要标尺,它要求模型能够推断他人的信念、意图和情感。基于此,tasksource/tomi-nli数据集应运而生,该数据集由Damien Sileo等人于2023年创建,将Le等人2019年提出的心理理论问答数据集(tomi)重新构架为自然语言推理任务。其核心研究问题在于探究语言模型是否具备从文本中隐式推理他人信念的能力,而非仅依赖表面模式匹配。通过将原始问答形式转化为蕴含关系判断,该数据集为评估模型在社交认知维度的推理能力提供了更精细的测试基准,对推动常识推理与多任务学习研究具有深远影响。
当前挑战
当前tasksource/tomi-nli数据集面临多重挑战。首先,在领域问题层面,心理理论推理涉及对错误信念、递归思维等复杂认知结构的建模,现有预训练语言模型常因过度依赖统计捷径而难以捕捉此类深层语义关系,导致在需要区分事实与信念的样本上表现欠佳。其次,在构建过程中,将原始问答数据转化为自然语言推理格式需精心设计正负样本,以避免引入标注偏差——例如错误信念场景中信念状态与真实状态的对立需通过严格逻辑约束来确保标签一致性。此外,数据集规模有限且领域高度特化,可能限制模型在泛化到真实社交互动场景时的鲁棒性,需结合更大规模多源数据进行联合训练以缓解过拟合风险。
常用场景
经典使用场景
ToMi-NLI数据集将经典的心理理论(Theory of Mind, ToM)问答任务重构为自然语言推理(NLI)形式,旨在评估模型对他人信念、意图和知识状态的理解能力。该数据集最经典的使用场景是作为心智推理能力的基准测试,通过判断前提与假设之间的蕴含、矛盾或中立关系,检验语言模型是否具备推断他人心理状态的高级认知能力。研究者通常利用该数据集训练和评估模型在社交认知任务上的表现,从而深入探究神经语言模型在模拟人类心智理论方面的局限性。
解决学术问题
该数据集解决了自然语言处理领域中一个核心学术问题:如何系统性地评估模型对心理状态的推理能力。传统问答形式难以区分模型是基于语言统计规律还是真正理解他人信念,而NLI格式通过严格的逻辑关系判断,迫使模型进行深层次的语义推理。ToMi-NLI的出现填补了心智理论评估标准化的空白,为研究模型的社会智能提供了可靠工具,推动了认知科学与人工智能交叉领域的进展,其意义在于揭示了当前模型在处理虚假信念、视角转换等复杂社会认知任务时的根本缺陷。
实际应用
在实际应用中,ToMi-NLI数据集可助力开发更具社交智能的对话系统和虚拟助手。例如,在客服场景中,具备心智推理能力的模型能更准确地理解用户未明说的需求或隐含意图;在教育机器人领域,模型可感知学习者的困惑状态并调整教学策略。此外,该数据集还可用于训练社交辅助机器人,使其在养老或医疗场景中更自然地与人类互动,通过推断他人的情绪和信念来做出适应性响应,从而提升人机协作的流畅性与信任度。
数据集最近研究
最新研究方向
在自然语言处理(NLP)领域,心智理论(Theory of Mind, ToM)的建模正成为前沿研究热点,它关乎机器对社会认知与意图推断能力的模拟。tasksource/tomi-nli数据集将经典的ToM问答任务重构为自然语言推理(NLI)格式,这一创新设计不仅降低了任务门槛,还使得预训练语言模型能够在更广泛的推理框架下接受评估与微调。当前,围绕该数据集的研究聚焦于探究大型语言模型(如GPT-4、LLaMA系列)在复杂社会情境下的信念归因与假信念理解能力,尤其结合了AI伦理与安全议题,例如检测模型是否具备识别错误信念或欺骗性信息的潜力。该数据集的发布推动了NLI任务从单纯的事实逻辑向社会认知深度拓展,为评估机器在人类社交互动中的可靠性提供了关键基准,其影响力已延伸至认知科学与人机交互的跨学科验证,成为理解AI心智盲点的重要工具。
以上内容由遇见数据集搜集并总结生成


