
Alwaly/Oral_Cancer-cancer
收藏官方服务:
资源简介:
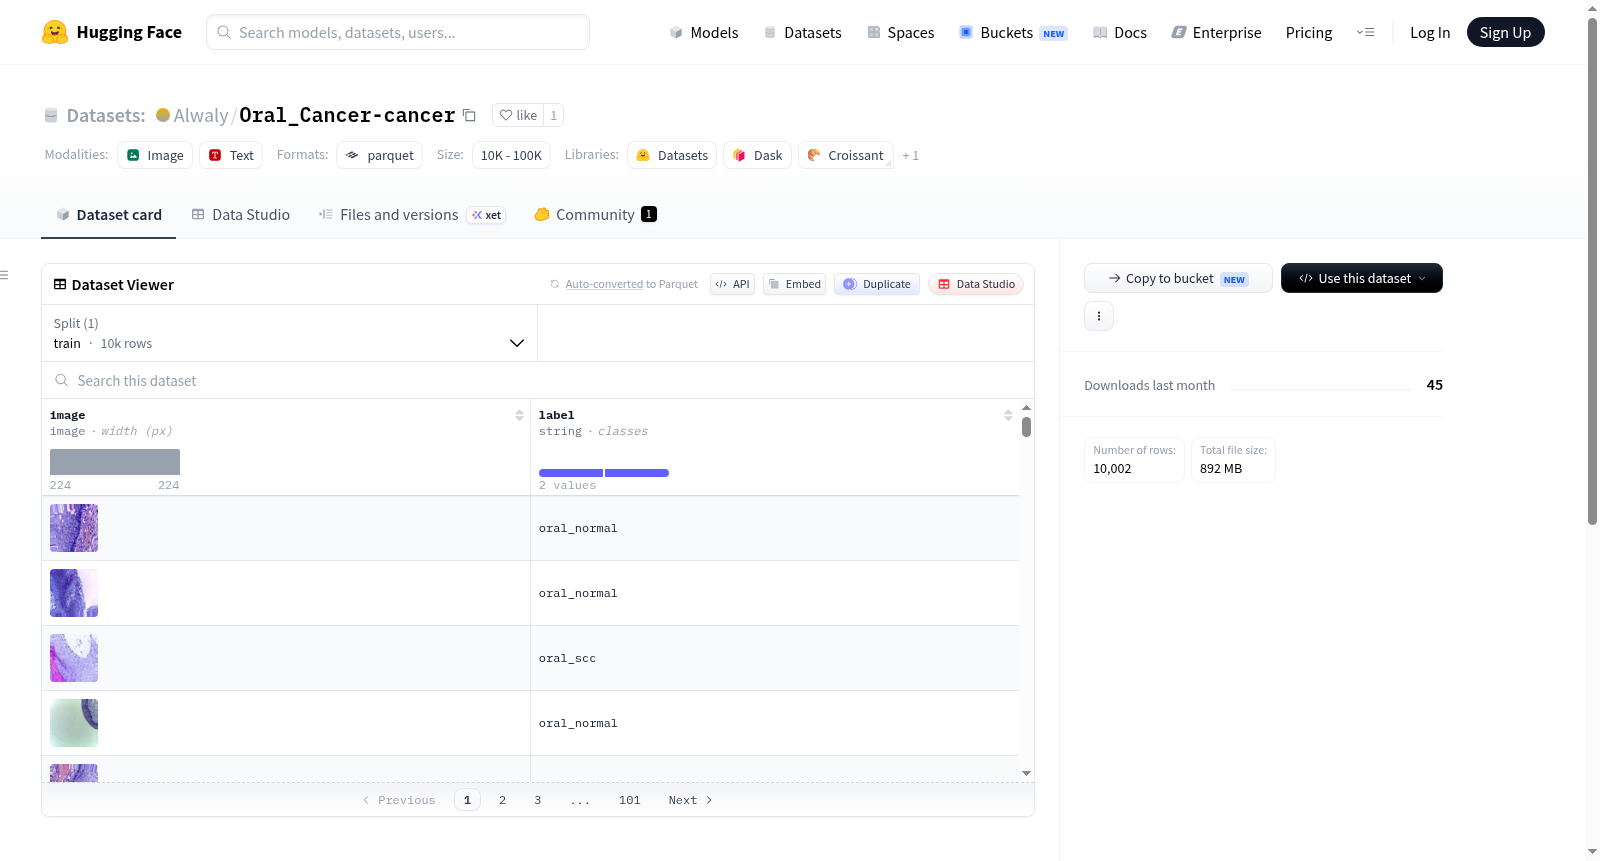
这是一个包含10000张正常和癌变口腔组织图片的数据集。数据集中的图片分为两类:正常口腔组织和口腔鳞状细胞癌组织。
This dataset contains 10,000 images of normal and cancerous oral tissues. The images are categorized into two classes: normal oral tissues and oral squamous cell carcinoma tissues.
提供机构:
Alwaly搜集汇总
数据集介绍
构建方式
口腔癌作为全球高发的恶性肿瘤之一,其早期诊断对提升患者生存率至关重要。Alwaly/Oral_Cancer-cancer数据集基于临床病理学分类,通过系统采集正常口腔组织与口腔鳞状细胞癌组织的图像样本构建而成。数据集包含10,002张高质量图像,按照组织类别划分为正常口腔组织(oral_normal)与口腔鳞状细胞癌组织(oral_scc)两个子类,每张图像均配备明确的字符串标签,确保数据标注的准确性与一致性。所有图像数据经过标准化处理,以Image格式存储,并通过HuggingFace Datasets框架以单一训练集(train)分片形式发布,便于研究者直接加载使用。
特点
该数据集的核心特点在于其规模与专业针对性。10,000余张图像覆盖正常与癌变口腔组织,为深度学习模型提供了充足的训练样本,有效缓解医学图像分析中数据稀缺的难题。类别平衡性设计兼顾了正常与癌变样本的分布,有助于模型学习判别性特征。图像数据以原生高分辨率格式保存,保留了组织纹理、细胞形态等关键病理细节,适用于迁移学习与细粒度分类任务。此外,数据集采用统一的标签体系与标准化的存储结构,降低了预处理复杂度,可直接用于二分类模型的端到端训练。
使用方法
研究者可通过HuggingFace Datasets库的load_dataset函数直接加载该数据集,指定配置名称为'default'即可获取训练集。加载后的数据以字典形式返回,包含'image'字段(PIL图像对象)与'label'字段(字符串类别标签)。建议在训练前对图像进行尺寸归一化与数据增强,如随机裁剪、旋转与颜色抖动,以适应不同模型输入要求。对于分类任务,可将标签映射为数值编码,并采用交叉熵损失函数进行优化。该数据集特别适用于口腔癌早期筛查模型的开发,也可作为医学图像分类基准测试的组成部分。
背景与挑战
背景概述
口腔癌作为全球第六大常见恶性肿瘤,其早期诊断对提升患者生存率至关重要。Alwaly/Oral_Cancer-cancer数据集由研究团队于近年构建,旨在推动基于深度学习技术的口腔癌自动筛查研究。该数据集包含10,002张口腔组织图像,涵盖正常组织与口腔鳞状细胞癌两大类,为医学影像分析领域提供了标准化、规模化的训练资源。其核心研究问题聚焦于利用卷积神经网络等模型实现口腔病变的精准分类,以辅助临床诊断。该数据集的发布显著降低了口腔癌研究的数据获取门槛,为跨学科合作与算法迭代奠定了坚实基础,对推动计算机辅助诊断在口腔医学中的应用具有里程碑意义。
当前挑战
该数据集面临的核心挑战在于解决口腔癌图像分类的领域难题:正常组织与癌变组织间形态差异细微,且受光照、拍摄角度等因素干扰,导致模型易产生误判。构建过程中,数据采集需在多家医疗机构进行,面临伦理审批、患者隐私保护及病理标注一致性等困难,高质量标注依赖多位病理学家的协同工作,耗时且成本高昂。此外,数据集仅包含两类样本,缺乏对癌前病变、不同分化程度等亚类的区分,限制了模型在临床细粒度诊断中的应用潜力。数据不平衡问题亦需关注,以确保模型对少类别的泛化能力。
常用场景
经典使用场景
在口腔癌的医学影像分析领域,Alwaly/Oral_Cancer-cancer数据集凭借其包含一万张正常与癌变口腔组织图像的大规模样本,成为训练深度学习模型进行口腔鳞状细胞癌(OSCC)自动检测的经典基准。该数据集以高分辨率图像为依托,广泛应用于构建卷积神经网络(CNN)或视觉Transformer(ViT)架构,用于区分正常口腔黏膜与恶性病变区域,为计算机辅助诊断系统提供了标准化的训练与评估平台。
衍生相关工作
基于该数据集,衍生出一系列经典工作,包括针对OSCC的弱监督语义分割模型以定位病变边缘、生成对抗网络(GAN)用于数据增强以缓解类别不平衡,以及多模态融合方法结合临床文本数据提升诊断解释性。此外,迁移学习策略在此数据集上验证了跨组织癌种诊断的可行性,催生了口腔癌风险分层预测等后续研究。
数据集最近研究
最新研究方向
口腔癌作为全球高发的恶性肿瘤之一,其早期筛查与精准诊断一直是临床医学的痛点。Alwaly/Oral_Cancer-cancer数据集包含10002张口腔正常组织与鳞状细胞癌的高清图像,为深度学习驱动的计算机辅助诊断提供了高质量训练资源。当前前沿研究方向聚焦于利用Vision Transformer与多尺度特征融合网络提升口腔病灶分割精度,同时探索自监督预训练策略以缓解医学图像标注稀缺问题。该数据集的发布不仅推动了口腔癌智能筛查从实验室走向临床辅助决策,更在低资源医疗场景中展现出显著的社会价值,为全球口腔健康公平性改善注入技术动能。
以上内容由遇见数据集搜集并总结生成


