
遇见数据集

Georgian Language AI Modeling Dataset v1.1

收藏
github2026-07-10 更新2026-07-13 收录
官方服务:

资源简介:

该仓库提供了一个开放、结构化、多层次的AI可读数据集,用于格鲁吉亚语AI建模、基准测试开发和格鲁吉亚数字语言主权。v1.1版本包含约1200万个LLM令牌的格鲁吉亚语材料,以衍生语言单元形式准备,不包含完整书籍、文章或长篇段落,而是由短衍生语言单元和简短文本摘录组成。数据以JSONL格式存储,涵盖十二个公共层次,如词形、动词、句子、格矩阵等,适用于AI和NLP管道、基准任务和数据集索引。

This repository provides an open, structured, multi-level AI-readable dataset for Georgian AI modeling, benchmark development, and Georgian digital language sovereignty. Version 1.1 contains approximately 12 million LLM tokens of Georgian language materials, prepared in the form of derived linguistic units. It does not include full books, articles or long paragraphs, and instead consists of short derived linguistic units and brief text excerpts. The data is stored in JSONL format, covering twelve public layers such as lexical forms, verbs, sentences, case matrices and more, and is suitable for AI and NLP pipelines, benchmark tasks and dataset indexing.

创建时间:
2026-07-10
原始信息汇总

数据集概述

  • 名称: Georgian Language AI Modeling Dataset v1.1
  • 提供方: 格鲁吉亚商业与技术大学 (Business and Technology University, BTU),第比利斯,格鲁吉亚
  • 规模: 约 1200 万 LLM tokens 的格鲁吉亚语言材料
  • 内容形式: 不包含完整的书籍、文章、章节、页面或长段落;由短派生语言单元和简短文本摘录组成
  • 数据格式: JSONL 格式(每行一个独立 JSON 对象),适合 AI 和 NLP 管道、基准任务及数据集索引

内部结构

数据集由 十二个公开层 的派生语言单元构成,包括:

  • wordforms(词形)
  • verbs(动词)
  • sentences(句子)
  • case matrix(格矩阵)
  • idiom and value units(习语与价值单元)
  • domain terms(领域术语)
  • measurement and quantity units(测量与数量单元)
  • quote and speech units(引用与言语单元)
  • AI error candidates(AI 错误候选)
  • article titles(文章标题)
  • core concepts(核心概念)
  • official data units(官方数据单元)

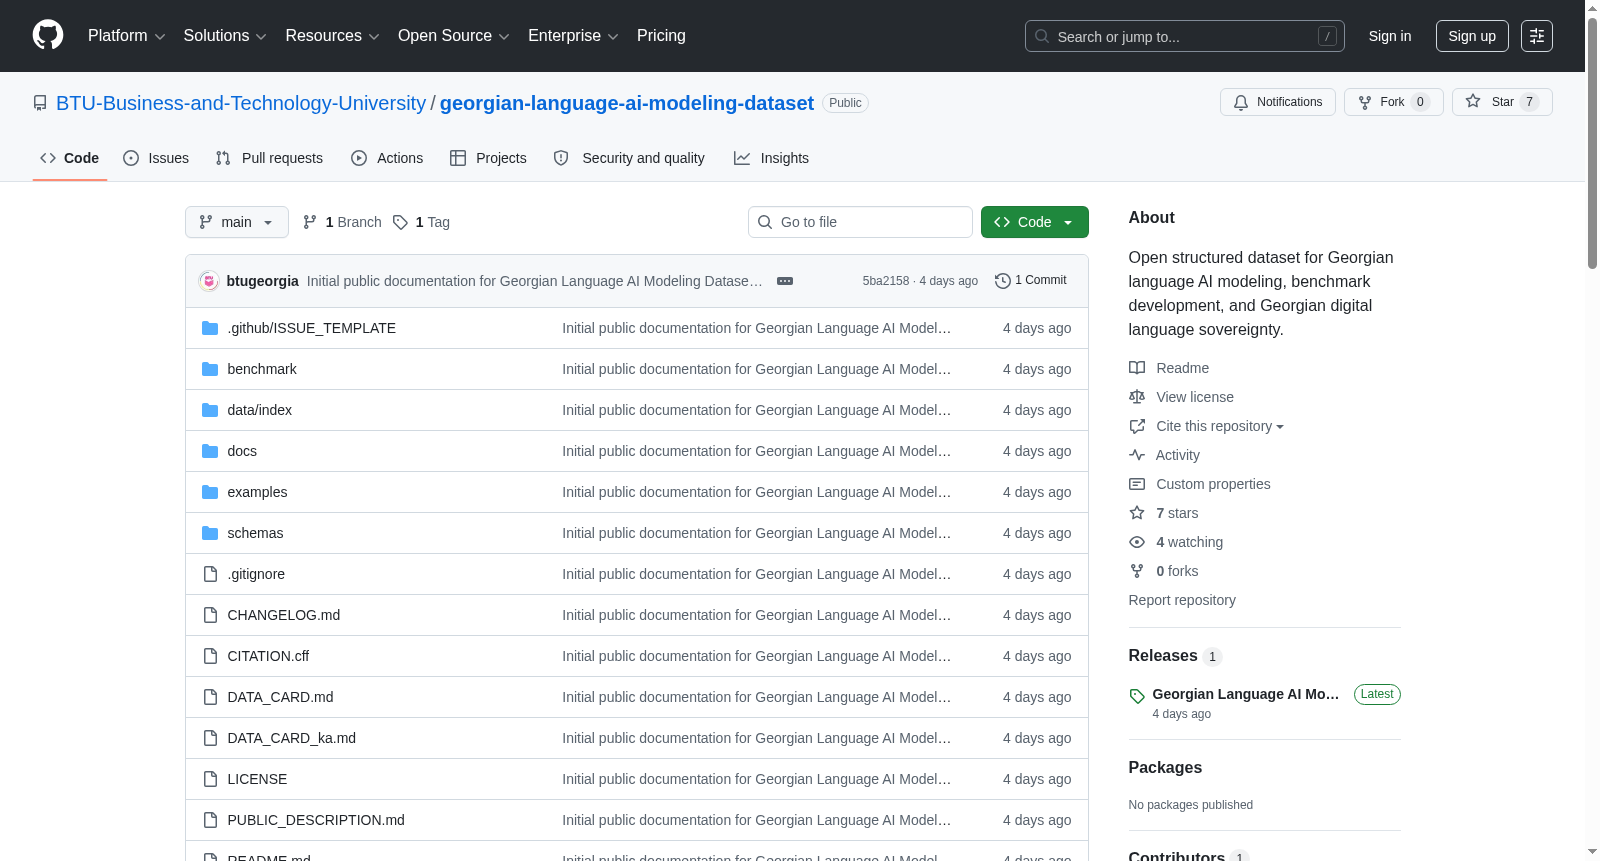
存储目录结构:

目录/文件 说明
examples/ 示例记录,用于快速查看格式
schemas/ 机器可读的模式、字段描述和验证规则
data/index/ 源清单和数据集结构
data/index/dataset_manifest.csv 每层的记录计数和路径
quality_report.json 审计与质量指标
Release asset 包含全部十二个公开层的完整数据集 ZIP

科学状态

该数据集为 候选研究数据集,非黄金基准或最终国家语言模型。下一阶段计划进行专家验证和多模型 AI 测试。

目的

帮助 AI 系统不仅将格鲁吉亚语理解为表层文本,而且理解其作为多层语法、语义、语境和文化系统的特性。

下载

完整数据集 ZIP 可从 GitHub 最新 Release 获取:

  • 直接下载 ZIP:
    https://github.com/BTU-Business-and-Technology-University/georgian-language-ai-modeling-dataset/releases/latest/download/georgian_language_ai_modeling_dataset_v1_1.zip

许可证

发布在 Creative Commons Attribution-NonCommercial 4.0 International (CC BY-NC 4.0) 下。非商业研究、教育和评估用途免费,需注明来源为商业与技术大学 (BTU)。商业用途需获得 BTU 单独许可。

引用

使用该数据集时,请引用对应的 CITATION.cff 文件。
搜集汇总
数据集介绍
Georgian Language AI Modeling Dataset v1.1 数据集图片
构建方式
该数据集由格鲁吉亚商业与技术大学(BTU)精心构建,聚焦于格鲁吉亚语言的AI建模与基准开发,旨在维护该国数字语言主权。v1.1版本包含约1200万LLM令牌的格鲁吉亚语材料,这些材料并非完整的书籍或长篇文章,而是由短小的衍生语言单元和简要文本片段构成。数据以JSONL格式存储,每一行均为独立的JSON对象,便于AI与NLP管线的处理。数据集拆分为十二个公共层,涵盖词形、动词、句子、格矩阵、习语与价值单元、领域术语、测量与数量单元、引用与语音单元、AI错误候选、文章标题、核心概念以及官方数据单元。此外,还附带了示例样本、机器可读模式、字段描述、验证规则以及源清单和数据集结构索引,确保构建过程严谨且层次分明。
特点
该数据集的一大特色在于其多层结构化设计,将格鲁吉亚语视为一个集语法、语义、语境与文化于一体的复杂系统,而非单纯的表面文本。它不追求成为最终的国家语言模型金标准,而是作为干净的研究候选数据集,旨在为多模型AI测试和专家验证提供坚实基础。每个衍生语言单元均经过精心提取,避免了冗长段落,使得数据高效紧凑。此外,数据集包含了质量报告(quality_report.json),提供审计与质量指标,增强了科学透明度。其开放性和非商业许可(CC BY-NC 4.0)鼓励学术与教育界的广泛使用,同时通过引用要求保护原创贡献,体现了对知识产权和区域语言资源发展的重视。
使用方法
用户可通过GitHub发布页面直接下载完整的ZIP压缩包,解压后获得包含所有十二个公共层的数据文件。建议首先浏览examples目录下的样本记录,以快速熟悉JSONL格式的结构;随后参考schemas目录中的模式文件和字段描述,明确各数据层的具体内容与验证规则。为高效集成,可将数据加载至AI或NLP管道中,用于训练语言模型、构建基准测试或进行个性化评估任务。对于非商业研究、教育和评估用途,遵循CC BY-NC 4.0许可协议,使用时应注明出处(Business and Technology University)。若涉及商业应用,则需单独获得BTU的许可。该数据集特别适用于探索格鲁吉亚语的多层次语言特性,推动该语言在人工智能领域的深入应用。
背景与挑战
背景概述
格鲁吉亚语作为一种高加索语系中的独特语言,其复杂的语法结构、丰富的形态变化以及独特的文字系统,使得面向该语言的人工智能建模充满挑战。为填补这一领域的空白,格鲁吉亚商业技术大学(BTU)于近期发布了Georgian Language AI Modeling Dataset v1.1,该数据集由该校研究团队精心构建,旨在为人工智能系统提供多层次的格鲁吉亚语言理解基础。数据集包含约1200万LLM令牌,以派生的语言单元形式组织,涵盖词形、动词、句子、格矩阵、习语、领域术语等十二个公开层,不仅服务于AI建模与基准测试,更致力于推动格鲁吉亚数字语言主权的实现。该数据集的发布,为低资源语言的自然语言处理研究树立了重要典范,显著提升了格鲁吉亚语在全球AI研究中的可见度与可用性。
当前挑战
该数据集所解决的领域问题核心在于格鲁吉亚语在AI建模中的低资源困境。具体挑战包括:1)格鲁吉亚语复杂的形态句法系统,如丰富的格变化与动词变位,对序列建模与语义解析构成巨大障碍;2)现有NLP资源极度匮乏,缺乏大规模、结构化、多层次的标注语料,导致模型难以捕捉该语言的深层文化语境与语法规律。在数据集构建过程中,团队面临诸多困难:数据来源的多样性与版权许可的协调,需要从公开文本中提取短派生的语言单元,避开完整篇章以符合非商业使用限制;多层级数据结构的定义与质量保障,确保每层(如格矩阵、习语值单元)的语义准确性与机器可读性;以及面向低资源语言的标注规范制定,需兼顾语言学专家知识与自动化流水线的效率。这些挑战的共同攻克,使得v1.1版本成为格鲁吉亚语AI研究的重要基石。
常用场景
经典使用场景
在低资源语言的自然语言处理研究中,格鲁吉亚语因其独特的书写系统与复杂的形态句法结构,长期缺乏高质量的结构化语料资源。该数据集专为格鲁吉亚语的AI建模与基准测试设计,其经典使用场景涵盖词形分析、动词语法分类、句法树构建、格位矩阵推理以及习语与价值观单位的语义解析。研究者在构建多任务评估体系时,可基于其十二个公开层级的派生语言单元,训练能够理解深层语法—语义—语境—文化系统的语言模型,从而突破传统表面文本建模的局限。
解决学术问题
该数据集系统性地回应了低资源语言在AI可读性与数据集标准化方面的核心困境。它解决了格鲁吉亚语缺乏公开分层语料库的学术空白,为研究者提供了从词法到语用层的结构化素材,支持对比跨语言的形态复杂性与语义对齐实验。通过包含AI错误候选单元与质量审计报告,数据集的发布催生了关于数据质量评估、层级基准设计与语言学验证方法的讨论,其影响在于推动了小语种数字主权从资源被动使用向主动构建的范式转移。
衍生相关工作
围绕该数据集已衍生出一系列方法论与工程创新。其中,基于其多层派生单元设计的形态句法联合解析模型成为格鲁吉亚语NLP的标杆方案;针对AI错误候选层开发的对抗性训练策略,显著提升了低资源场景下的鲁棒性。此外,研究者利用其案例矩阵与价值观单元构建了跨文化情感分析基准,相关成果常出现在ACL、LREC等顶级会议的低资源语言专题讨论中。该数据集亦催生了格鲁吉亚语专用词向量与多任务预训练框架,为后续的格鲁吉亚语大语言模型奠定了训练与评估的双重基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

