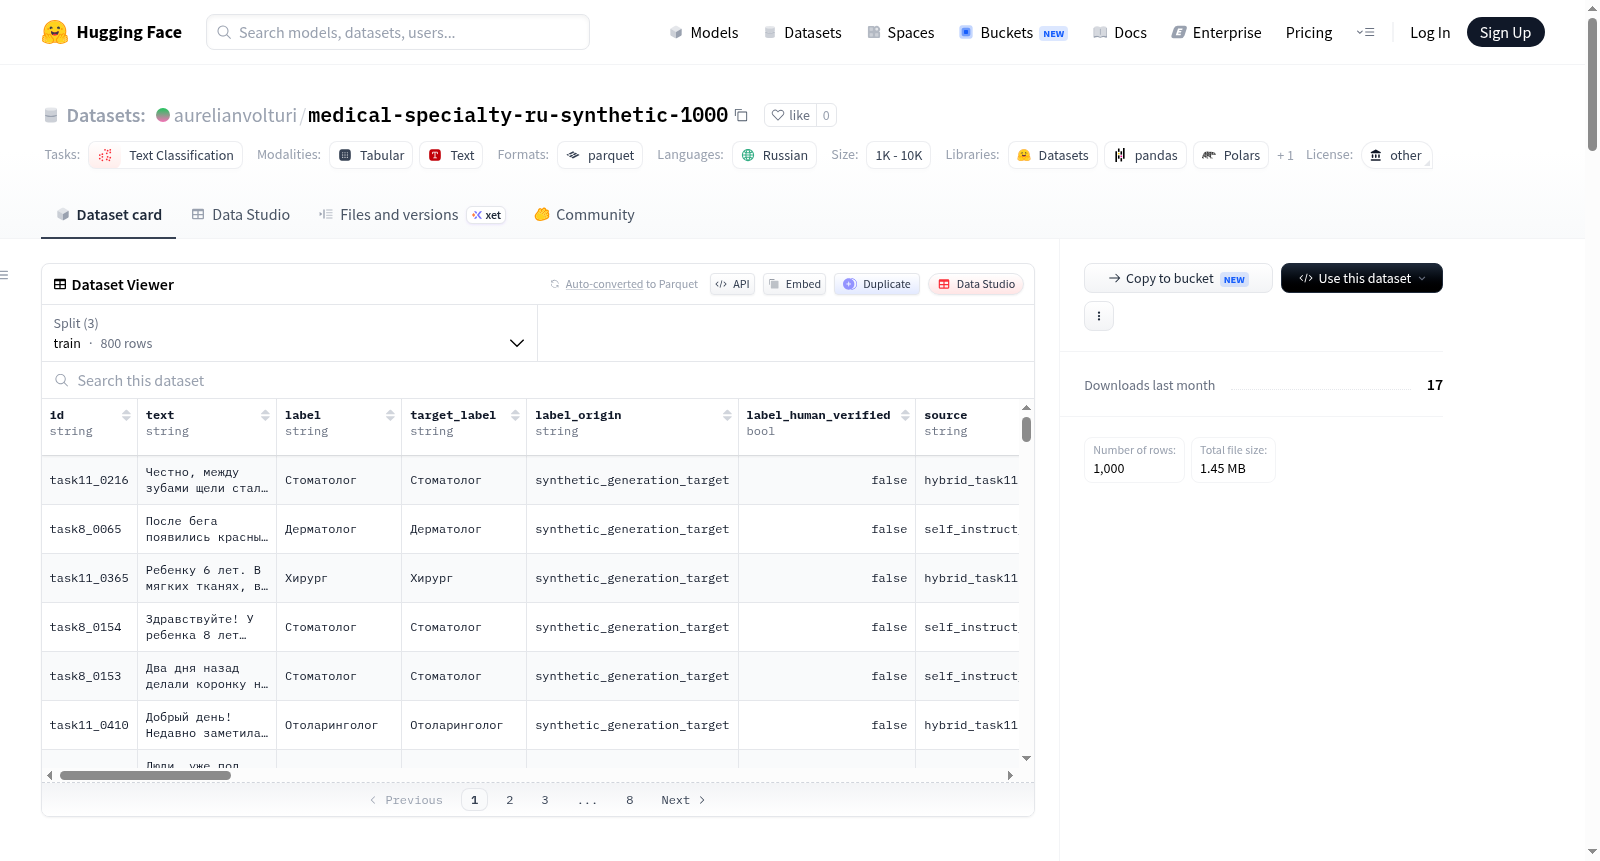
medical-specialty-ru-synthetic-1000
收藏资源简介:
Medical Specialty RU Synthetic 1000 是一个用于医疗专科路由任务的俄语合成文本分类数据集,专为根据患者主诉文本将其分配至特定医疗专科(共10类:胃肠科、妇科、皮肤科、神经科、耳鼻喉科、牙科、内科、创伤科、泌尿科和外科)的研究而设计,仅用于教育研究,不可用于实际医疗诊断。数据集包含1000条由大语言模型生成的俄语患者主诉文本,划分为训练集(800条)、验证集(100条)和测试集(100条),各类别样本均衡各100条。数据来源于三个不同的合成生成协议,原始真实文本未包含。每条记录包含33个字段,如文本内容、目标标签等,并经过自动化质量控制。数据集在零样本分类任务上表现较高,但存在合成文本与真实文本的差异、风格重复、标签泄露等限制,采用other许可。
Medical Specialty RU Synthetic 1000 is a Russian synthetic text classification dataset for medical specialty routing tasks, designed to study how to accurately assign patient complaint texts to specific medical specialties (10 classes: Gastroenterology, Gynecology, Dermatology, Neurology, ENT, Dentistry, Internal Medicine, Traumatology, Urology, and Surgery) for educational research purposes only, not for actual medical diagnosis. The dataset contains 1000 Russian patient complaint texts generated entirely by large language models, divided into a training set (800 samples), validation set (100 samples), and test set (100 samples), with balanced samples of 100 per class. It originates from three different synthetic generation protocols, and original real patient texts are not included. Each record includes 33 fields, such as text content and target labels, and has undergone automated quality control. The dataset shows higher performance in zero-shot classification tasks but has limitations including differences from real text, style repetition, and label leakage, and is licensed under other.
Medical Specialty RU Synthetic 1000
概述
此数据集包含 1,000 条合成的俄语医疗主诉文本,用于研究将患者主诉路由至 10 种医疗专科的分类任务。该数据集为教学/研究用途,不可用于临床诊断或治疗决策。
数据集规模与划分
- 总记录数:1,000 条
- 训练集:800 条
- 验证集:100 条
- 测试集:100 条
类别与标签
数据集包含 10 个专科类别,每个类别 100 条记录:
["Гастроэнтеролог", "Гинеколог", "Дерматолог", "Невролог", "Отоларинголог", "Стоматолог", "Терапевт", "Травматолог", "Уролог", "Хирург"]
标签语义说明:label 字段等于 target_label,表示合成生成时指定的目标专科,并非分类器预测结果,也非经专家验证的医学标注。所有记录的 label_origin 均为 "synthetic_generation_target",label_human_verified 均为 false。
数据来源
hybrid_task11:400 条self_instruct_task8:300 条confidence_task10:300 条 所有记录均为合成数据(is_synthetic=true),原始论坛文本未公开发布。
数据字段(完整 Schema)
id, text, label, target_label, label_origin, label_human_verified, source, style, language, length_chars, length_tokens, semantic_concepts, semantic_concept_count, semantic_margin, style_validation_status, quality_validation_status, quality_validation_reasons, quality_validator_version, generation_source_protocol, generation_protocol, generation_model, generation_service, annotation_model, annotation_service, llm_label, confidence, votes, tie, simulated_human_label, hybrid_label, annotation_output_label, annotation_method, is_synthetic, created_at
生成与标注
- 生成模型:
Qwen/Qwen2.5-3B-Instruct - 标注模型:
Qwen/Qwen2.5-3B-Instruct - 生成/标注服务:
local_transformers - 生成日期:2026-07-21,全局 seed=42
- 生成过程使用严格 JSON 包格式,本地解码;标注采用 zero-shot/few-shot 模式,confidence 为 5 次独立调用中的多数一致比例
- 混合标注策略:当 confidence 高于阈值时采用 LLM 结果,否则采用模拟的 95% 精度人工标注器结果
质量控制
每条记录均通过 russian_style_concept_qa_v5 验证器,检查内容包括:
- 所有字母属俄语西里尔字母
- 至少包含两个独立临床概念组及目标专科的特定锚点
- 语义边际(semantic margin)不低于 1
- 额外检查:语法 red flags、元文本、句子重复、词汇多样性、完整性、PII、标签泄露及风格符合性 未通过验证的记录自动重新生成直至满足配额。
多样性评估
合成数据的多样性低于真实数据:
- distinct-3:0.9014(合成) vs 0.9687(真实)
- 平均类内 NN char-5gram Jaccard:0.137(合成) vs 0.072(真实)
- 在 100% 的合成文本中目标类别标记显式出现,而真实文本中仅为 60.7%
许可
许可证标注为 other,商业使用前需检查所使用模型、OpenRouter 提供商及当地法律要求。
示例数据
json { "id": "task8_0001", "text": "Здравствуйте. Около недели тошнит и хотелось часто в туалет. Голодал, а аппетита никакого. Частенько чувствовался холод, хотя обычно жара. Давно так не было.", "label": "Гастроэнтеролог", "source": "self_instruct_task8" }
加载方式
python from datasets import load_dataset dataset = load_dataset("aurelianvolturi/medical-specialty-ru-synthetic-1000")