遇见数据集

crop-disease-tlm-data

收藏
Hugging Face2026-06-12 更新2026-06-13 收录
官方服务:

资源简介:

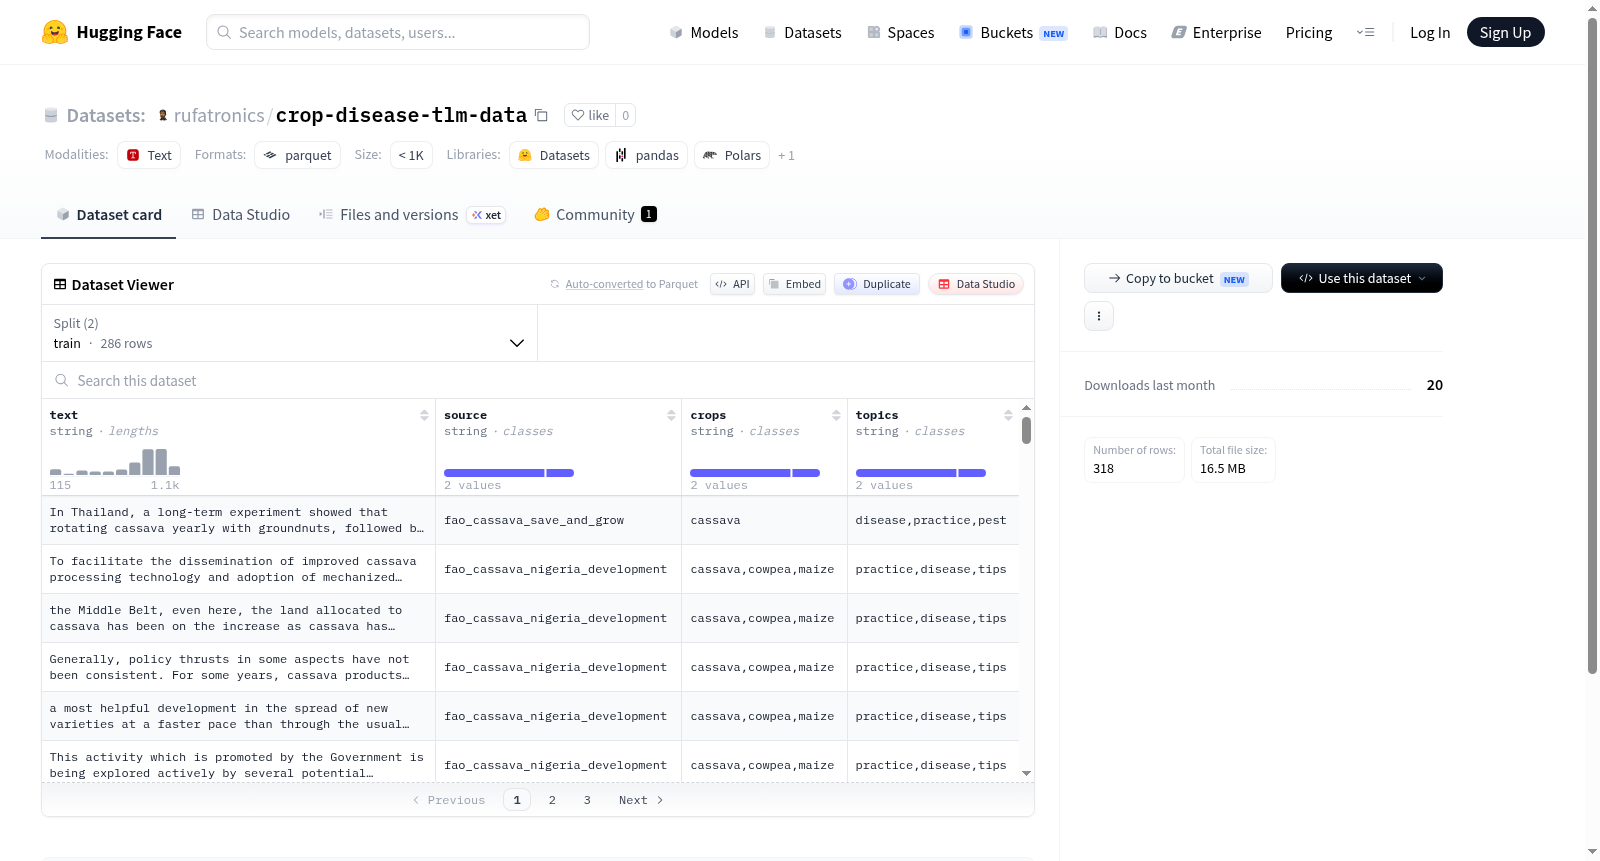
该数据集是一个小型文本数据集,包含318个样本,分为训练集(286个样本)和验证集(32个样本)。每个样本包含四个字段:text(文本内容)、source(文本来源)、crops(涉及的作物类型)和topics(文本主题)。从字段命名推断,数据集内容可能与农业、作物种植或相关主题相关,适用于文本分类、主题建模、信息提取或农业领域自然语言处理任务。数据以纯文本形式存储,总大小约为276KB。

This dataset is a small text dataset containing 318 samples, divided into a training set (286 samples) and a validation set (32 samples). Each sample includes four fields: text (text content), source (text source), crops (involved crop types), and topics (text topics). Based on the field names, the dataset content is likely related to agriculture, crop cultivation, or similar themes, and is suitable for text classification, topic modeling, information extraction, or natural language processing tasks in the agricultural domain. The data is stored in plain text format, with a total size of approximately 276KB.

创建时间:
2026-06-10
原始信息汇总

数据集概述

该数据集名为 crop-disease-tlm-data,由 rufatronics 提供,旨在用于农作物病虫害相关的文本语言模型训练或分析任务。

数据特征

数据集包含以下四个字段:

  • text:文本内容(字符串类型)
  • source:数据来源(字符串类型)
  • crops:相关农作物(字符串类型)
  • topics:主题分类(字符串类型)

数据划分

数据集分为训练集和验证集两个部分:

  • 训练集:286 条样本,占用约 247 KB
  • 验证集:32 条样本,占用约 29 KB

数据规模

  • 总下载大小:约 155 KB
  • 总数据集大小:约 276 KB

配置文件

数据集提供默认配置(default),数据文件路径如下:

  • 训练集:data/train-*
  • 验证集:data/validation-*
搜集汇总
数据集介绍
crop-disease-tlm-data 数据集图片
构建方式
面向农作物病虫害的文本数据集crop-disease-tlm-data,以多源农业信息为基础,通过结构化方式构建而成。每条数据包含文本内容、来源、作物类型及主题标签四个字段,共计286条训练样本与32条验证样本。数据采集自公开农业文献与知识库,经清洗与标注后形成统一的文本-标签映射关系,为农作物病虫害领域的自然语言处理任务提供了精准的语料基础。
特点
该数据集的核心优势在于其精细的作物与主题标签体系。crops字段明确标识作物种类(如水稻、小麦),topics字段则涵盖病虫害名称、防治措施等语义类别。这种双重标签设计使得模型可同时学习作物特异性与病害通用性特征。此外,数据来源的多样性(source字段)确保了文本风格与知识广度的平衡,避免了单一语料的偏置问题。
使用方法
数据集以HuggingFace Datasets库标准格式存储,支持直接加载与分割调用。用户可通过load_dataset函数按默认配置读取训练集与验证集,亦可基于text字段进行文本分类任务,或以crops和topics字段为标签构建多标签分类模型。建议在微调预训练语言模型时,将'识别[作物]的[主题]'作为任务模板,充分挖掘标签语义关联性。
背景与挑战
背景概述
作物病害是全球粮食安全面临的重大威胁之一,精准识别病害类型对于及时防治、减少农业损失至关重要。近年来,预训练语言模型在文本分类任务中展现出卓越性能,然而在农业领域,尤其是作物病害相关的文本数据资源极为稀缺。为此,研究人员构建了crop-disease-tlm-data数据集,旨在为作物病害文本语言模型(TLM)提供训练与验证基础。该数据集由特定研究机构或团队创建,涉及文本、来源、作物及主题四个字段,涵盖286条训练样本与32条验证样本,样本规模较小但聚焦性强。其核心研究问题在于利用小样本数据训练稳健的病害分类模型,推动自然语言处理技术在农业病害监测中的应用,对智慧农业与精准植保领域具有显著的参考价值。
当前挑战
作物病害文本分类面临的首要挑战是领域数据的极度稀缺性,传统深度学习模型依赖海量标注数据,而农业病害文本的标注成本高、专业性强,难以大规模获取。crop-disease-tlm-data数据集仅包含318条样本,远低于常规预训练语言模型所需的数据量,这导致模型易发生过拟合,泛化能力受限。此外,病害名称、症状描述及防治措施等文本表述多样,存在同义异形、跨地域术语差异等问题,增加了语义理解的复杂性。在构建过程中,数据采集与清洗需依赖农业专家知识,确保标签准确性与一致性,同时还需平衡不同病害类别的样本分布,避免类别失衡影响模型训练效果。
常用场景
经典使用场景
在智慧农业与自然语言处理交叉领域的研究中,crop-disease-tlm-data数据集常被用于构建面向农作物病害文本的预训练语言模型。该数据集汇聚了涵盖多种作物、病害主题及来源的专家撰写文本,为模型学习领域特定语境下的语义关联提供了坚实的基础。研究者利用其进行领域自适应预训练,通过掩码语言建模等经典范式,使模型精准捕获作物病害相关的术语、症状描述及防治方法等细粒度知识,从而显著提升下游任务中对农业专业文本的理解能力。
解决学术问题
该数据集核心解决了农业领域缺乏高质量、结构化文本语料以支撑深度学习模型训练的学术困境。传统通用语言模型在作物病害诊断、病虫害预警等任务中常因领域词汇稀疏和语境差异导致性能瓶颈。crop-disease-tlm-data通过提供标注了作物与主题类别的专业文本,使研究者能够针对性地攻克领域术语表示学习、少样本意图识别及跨主题知识迁移等难题,推动了农业知识图谱构建与智能问答系统的理论发展,为精准农业中的文本智能分析奠定了数据基础。
衍生相关工作
依托该数据集衍生出一系列前沿研究工作,包括面向作物病害的领域预训练语言模型(如CropBERT及其变体),以及融合多源文本的病虫害知识蒸馏框架。研究者还将其与图像病害数据集结合,开发跨模态联合学习模型,实现“看图问诊”与“以文搜图”的双向检索能力。此外,基于该数据集的少样本提示学习范式被成功迁移至低资源语种的农业病害文本分类任务中,显著拓展了其在东南亚及非洲等区域的适用性,催生了多项农业领域子任务上的基准成果。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务