
mahesh090406/tanglish-health-triage-v1
收藏官方服务:
资源简介:
Tanglish Health Triage Dataset v1 是一个泰米尔纳德邦方言的医疗分诊数据集,使用Tanglish编写,Tanglish是泰米尔语和英语的混合体,用英文字母书写。该数据集旨在用于症状理解、健康风险分类和医疗助理研究。
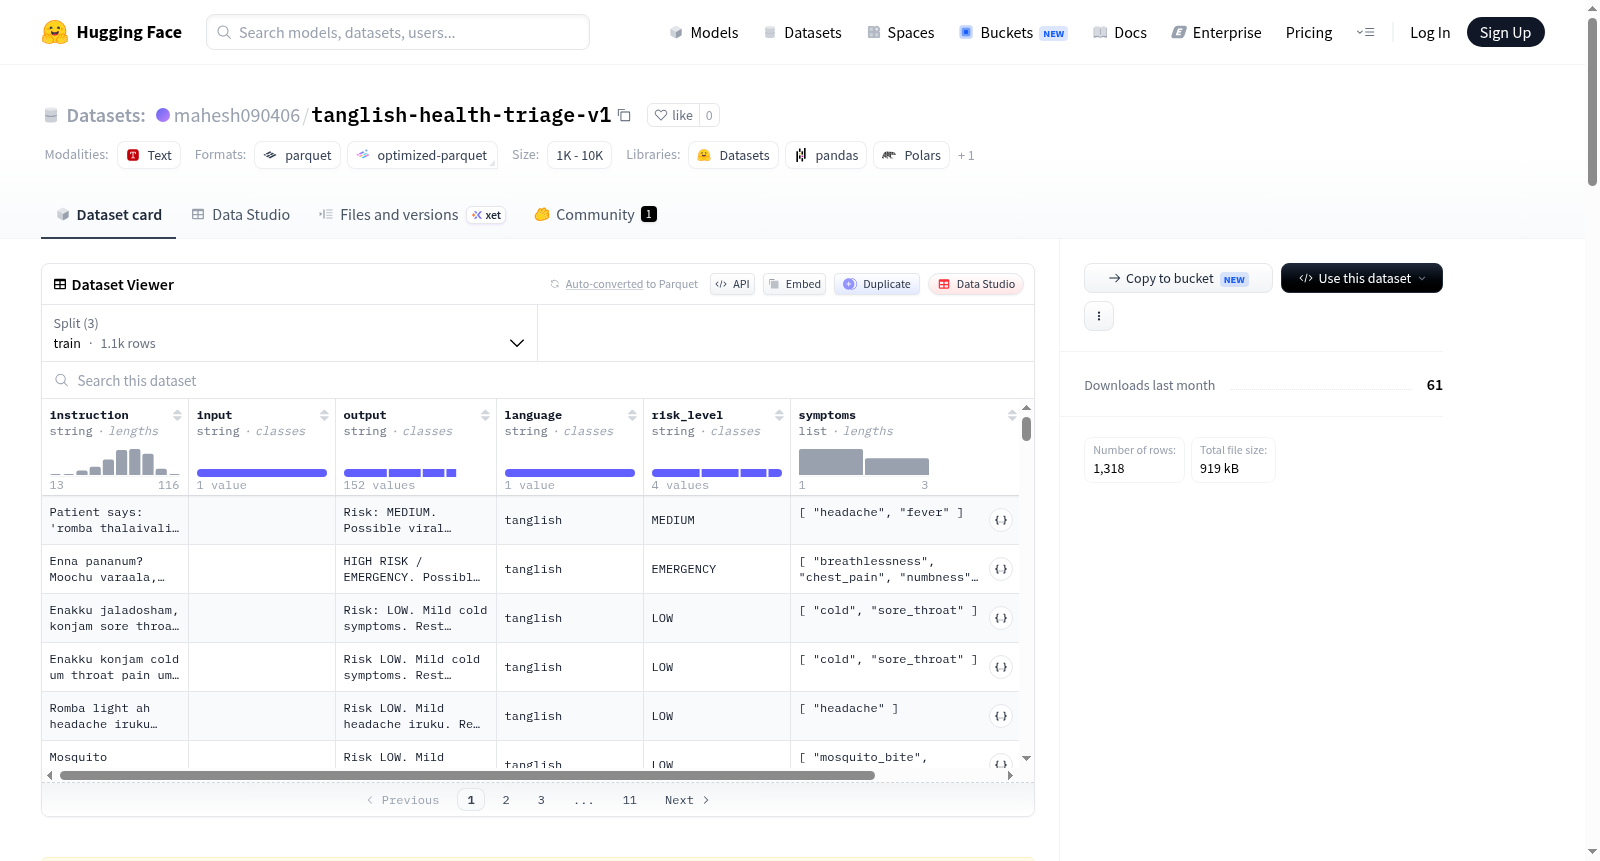
Tanglish Health Triage Dataset v1 is a Tamil Nadu dialect healthcare triage dataset written in Tanglish, a mix of Tamil and English written using English letters. The dataset is designed for symptom understanding, health risk classification, and healthcare assistant research.
提供机构:
mahesh090406搜集汇总
数据集介绍
构建方式
在医疗资源分布不均的背景下,面向印度泰米尔纳德邦农村地区的医疗分诊需求,该数据集以独特的‘Tanglish’语言为载体构建。Tanglish是泰米尔语与英语的混合语体,采用拉丁字母书写,贴合当地民众日常表达习惯。数据集的构建融合了三种途径:手工编写的真实语境健康案例、基于模板生成的合成样本,以及公开的泰米尔-英语语料库转换,以增强语言覆盖。所有样本均不涉及真实患者隐私数据,经过严格匿名化处理,确保数据合规性与可用性。最终形成包含1318条记录的数据集,并按约8:1:1的比例划分为训练集、验证集与测试集,支撑模型训练与评估。
特点
该数据集的核心特点在于其语言与任务的深度耦合。每条记录包含指令(instruction)、输入(input)、输出(output)、语言标记、风险等级、症状描述及来源字段,结构清晰且信息丰富。风险等级划分为LOW、MEDIUM、HIGH、EMERGENCY四个层级,对应从基础家庭护理到紧急医疗救助的递进式分诊决策,贴合真实医疗场景的紧迫性判断。数据来源的多样性赋予了数据集较广的语言变体适应能力,尤其适合低资源语言场景下的自然语言理解与生成任务。此外,数据集明确标注仅供研究与教育使用,避免对专业医疗诊断的替代风险,体现了负责任的构建伦理。
使用方法
该数据集可直接用于训练与评估医疗分诊相关的自然语言处理模型。使用者可利用其结构化的特征字段,对患者的Tanglish症状描述进行风险等级分类,或生成安全的分诊应答。特别适用于构建面向印度农村地区的轻量级健康助手原型,支持小语言模型的微调、低资源语言医疗NLP研究,以及医疗分诊对话机器人的实验。使用时需注意,数据集中的合成样本可能存在局限性,在投入实际部署前应经过人工审核与领域验证。模型输出不得作为临床决策依据,应始终与专业医疗诊断保持明确边界。推荐以HuggingFace Datasets库加载,并结合标准分类或生成框架进行实验。
背景与挑战
背景概述
在全球医疗资源分布不均的背景下,农村地区因语言障碍而难以获得及时、准确的健康分诊服务,这一问题在印度南部泰米尔纳德邦尤为突出。该地区广泛使用泰米尔语与英语混杂的'Tanglish'方言,现有医疗自然语言处理系统多聚焦于标准语言,忽视了此类低资源方言的迫切需求。为此,Mahesh C来自萨蒂亚巴马科技学院,在其2026年度的信息技术学士项目中创建了Tanglish Health Triage v1数据集。该数据集专注于Tanglish方言下的症状理解与健康风险分类,涵盖LOW至EMERGENCY四个风险等级,旨在推动农村健康助手及低资源语言医疗NLP研究。通过提供人工编写的Tanglish健康示例与模板化合成数据,该数据集为方言医疗分诊系统的开发奠定了重要基础,对提升农村地区健康信息可及性具有开创性意义。
当前挑战
该数据集面临的核心领域挑战在于,如何在低资源、高变异的Tanglish方言中实现准确的症状理解与风险分类。Tanglish作为非标准混合语言,缺乏成熟的语法规范和大规模标注语料,使得传统NLP模型难以直接应用。数据构建过程中的挑战尤为显著:首先,人工编写真实且多样化的Tanglish健康描述耗时费力,且需确保不涉及任何真实患者隐私数据;其次,模板化合成方法虽能扩充数据量,但生成的例句可能与实际口语表达存在差异,影响模型泛化能力;此外,风险等级的定义(如HIGH与EMERGENCY的界限)需兼顾医学严谨性与方言表达的模糊性,标注一致性难以保证。这些挑战共同制约了模型在农村部署时的稳健性与安全性。
常用场景
经典使用场景
在印度泰米尔纳德邦的农村地区,大量居民习惯使用掺杂泰米尔语和英语的Tanglish混合语言描述健康症状,但医疗资源匮乏且专业分诊人员不足。该数据集专为低资源语言场景下的医疗分诊设计,核心任务是根据患者用Tanglish表述的症状描述,自动将其分类为LOW(低风险)、MEDIUM(中风险)、HIGH(高风险)或EMERGENCY(紧急)四个严重等级。研究人员可基于此数据集训练轻量级语言模型,构建面向农村医疗的分诊对话系统,实现对常见病症的初步风险评估与就医建议生成。
衍生相关工作
该数据集衍生了一系列经典研究工作,包括基于多语言预训练模型(如mBERT、XLM-R)的Tanglish症状分类器优化,以及利用数据增强技术(回译、模板合成)缓解低资源过拟合问题的实验。部分研究探索了将分诊任务改造为生成式问答,通过指令微调小型模型(如TinyLLaMA、BLOOM)输出分诊建议。此外,有工作对比了纯英语、纯泰米尔语与Tanglish三种语言设置下的分类性能差异,揭示了混合语言对模型理解能力的独特挑战,为低资源医疗NLP的跨领域迁移学习提供了重要基线。
数据集最近研究
最新研究方向
在低资源语言与方言医疗健康领域的交叉前沿,tanglish-health-triage-v1数据集为泰米尔语与英语混合的乡村医疗分诊研究开辟了新的路径。该数据集聚焦于南印度泰米尔纳德邦特有的Tanglish方言,通过症状理解与风险等级(低、中、高、紧急)分类,支持构建面向农村地区的轻量化健康助手。当前研究热点包括利用该数据集微调小型语言模型、开发低资源环境下的医疗分诊聊天机器人,以及探索跨语言症状分类的鲁棒性。其意义不仅在于弥补印度方言医疗AI的数据缺口,更在于推动数字健康公平——让边缘化语言社区能够享受准确、及时的初步医疗风险评估,从而缓解基层医疗资源匮乏的紧迫问题。
以上内容由遇见数据集搜集并总结生成


