
FireGoWay/ToolMind_no_think
收藏搜集汇总
数据集介绍
构建方式
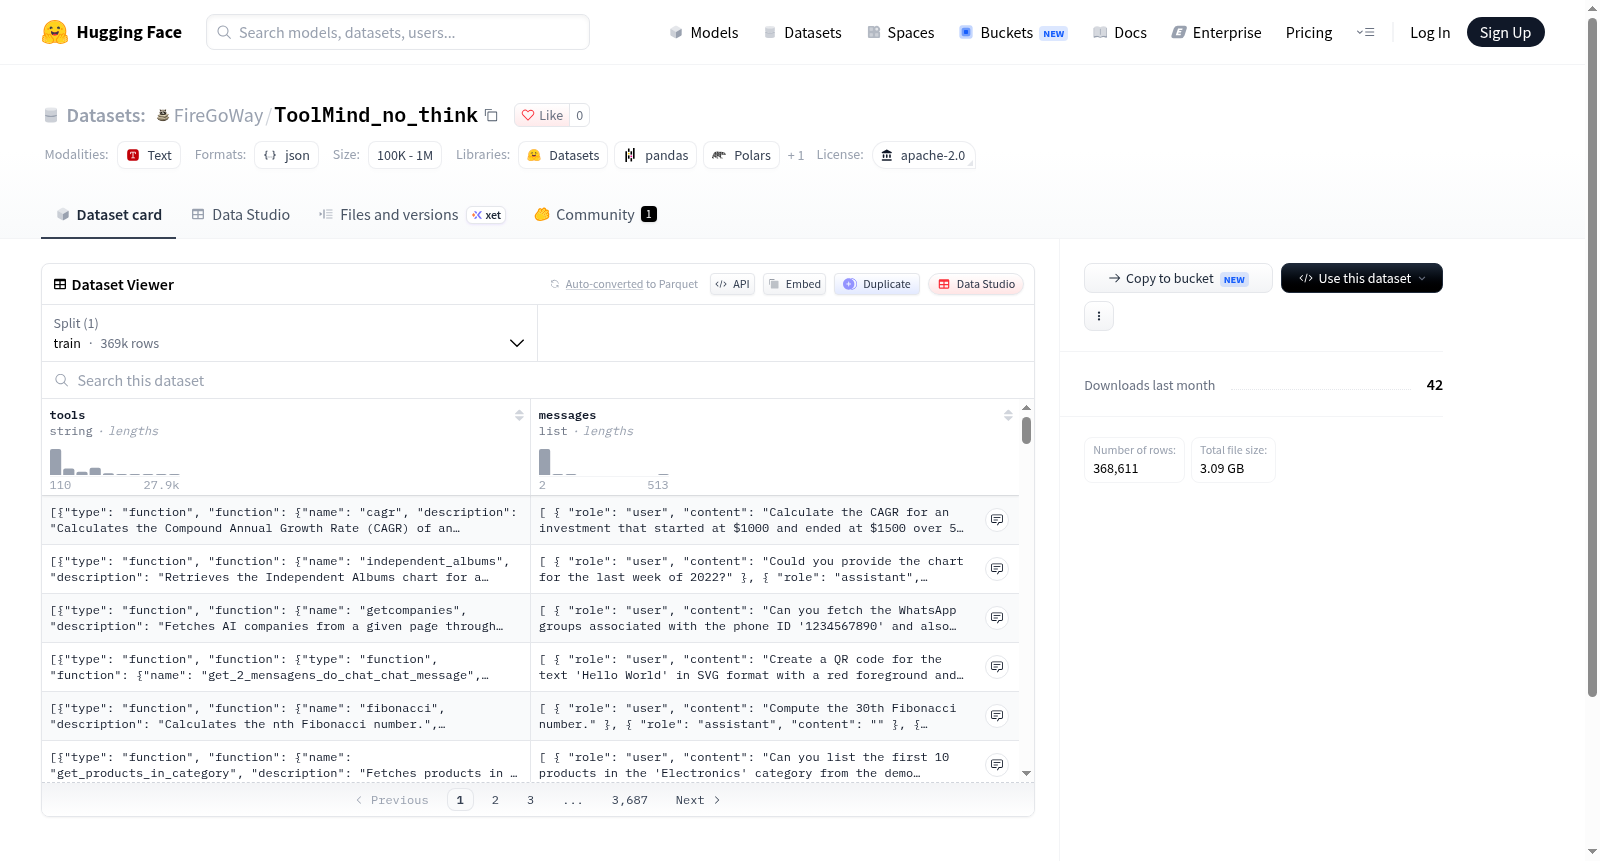
该数据集通过剥离原始ToolMind数据集中模型生成的思维链内容而构建,其源头ToolMind本身以工具调用与推理任务为核心。处理过程聚焦于移除显式推理步骤,仅保留输入指令与最终工具调用结果之间的直接映射关系,从而形成不包含中间思考过程的精简版本。此举意在降低序列长度并消除因思维链标注风格差异带来的训练噪声,使数据更适配对推理路径透明度无要求的应用场景。
特点
数据集的核心特征在于其去思维化。相较于完整版ToolMind,该版本舍弃了显式的推理链路,单条样本的标记数显著减少,有利于提升训练与推理效率。数据分布与原始ToolMind保持一致,覆盖多类工具调用任务,但不再提供模型内部决策依据。此特性使得数据集特别适合需要直接输出工具调用指令的微调任务,同时避免了因思维链格式不统一而引入的额外复杂性。
使用方法
使用时可借助Hugging Face datasets库直接加载ToolMind_no_think,将其作为监督微调的训练语料。由于数据不含思维链片段,模型输入与目标输出之间为端到端映射,训练时无需对输出格式做额外解析。建议在工具调用能力导向的微调任务中采用该数据集,以加快收敛并减少生成长度。若需保留推理过程,则应选用原始ToolMind;若追求推理效率与简洁输出,本数据集为更合适的选择。
背景与挑战
背景概述
工具调用能力已成为大语言模型与外部环境交互的核心技能,其训练数据的质量直接影响模型的泛化表现。ToolMind_no_think 是在 ToolMind 数据集基础上衍生而来的变体,由 Nanbeige 团队构建并遵循 Apache-2.0 许可协议开放。ToolMind 原生包含工具调用任务的推理链路,而本数据集通过剥离思维链内容,形成纯净的工具调用监督信号,旨在探究无推理步骤条件下的模型学习行为。该数据集为工具学习领域提供了可控的实验对照,有助于研究者分离推理生成与工具执行对模型性能的独立贡献。
当前挑战
工具调用数据集面临的核心领域挑战在于,真实场景中的工具选择、参数填充与多轮调用紧密耦合,模型需在缺乏显式推理线索时仍能准确完成调用决策。构建此类数据时,去除思维链内容要求严格保持原始输入输出对的语义完整性,避免因删减推理步骤而引入标签噪声或上下文断裂。此外,如何确保精简后的样本不丢失工具调用的关键依赖信息,并维持与原始数据集一致的任务分布,是该衍生数据集在构建过程中必须应对的技术难题。
常用场景
经典使用场景
在智能体工具调用与函数调用(Function Calling)研究领域,ToolMind_no_think数据集扮演着标准化测试床的角色。其经典使用场景在于训练与评估大语言模型在无需冗长思维链(Chain-of-Thought)的情况下,直接输出可执行工具调用指令的能力。研究人员通常将该数据集用于微调模型,以提升其在多轮对话中精准识别工具调用时机、解析工具参数并生成符合API规范的JSON结构输出。相较于包含显式思考过程的原始版本,该数据集鼓励模型以更简洁、高效的方式完成工具选择与参数填充,从而降低推理延迟,适用于对响应速度有较高要求的交互式智能体系统。
解决学术问题
该数据集有效缓解了学术研究中工具调用任务里思维链标注冗余与推理效率低下之间的张力问题。以往研究多依赖包含详细思考步骤的监督信号,导致模型在推理时产生大量非必要的中间文本,不仅增加计算开销,亦可能引入噪声。ToolMind_no_think通过剥离显式思考内容,迫使模型学习从用户意图直接映射至工具调用动作的隐式推理路径,为探究“无思考”范式下模型工具使用能力的上限提供了受控实验条件。其意义在于推动了对工具调用任务中推理效率与准确性权衡的量化理解,并为后续轻量化智能体研究奠定了基础。
衍生相关工作
ToolMind_no_think衍生了一系列围绕高效工具调用与隐式推理的经典研究工作。部分研究以此为基础,探索了无思维链监督下的工具调用蒸馏方法,将大模型的工具使用能力迁移至小规模模型;另有工作将其作为基准,对比显式思考与隐式推理在工具调用任务中的性能差异,揭示了推理长度与任务准确率之间的非线性关系。此外,该数据集还启发了面向多工具组合场景的强化学习奖励设计,以及针对工具调用输出格式约束的解码策略优化。这些衍生工作共同丰富了工具增强型语言模型的研究生态。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


