
slnkvdns/AlphaDent
收藏官方服务:
资源简介:
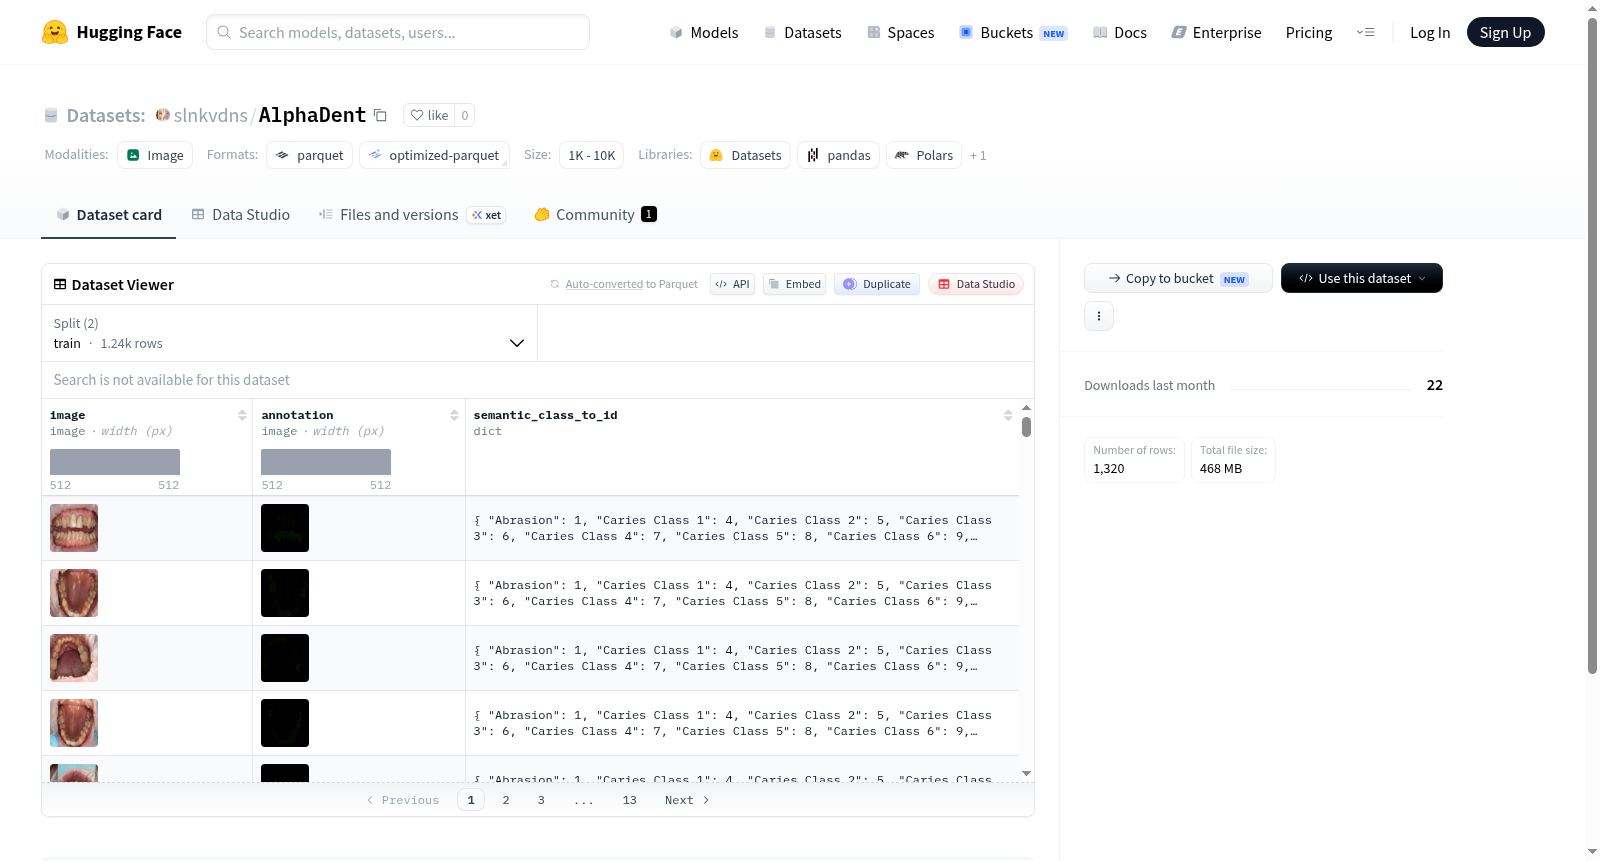
这是一个牙科图像语义分割数据集,包含牙齿图像及其对应的注释图像,用于识别和分类牙齿状况,如龋齿(分为6个类别)、磨损、牙冠和填充等。数据集分为训练集(1237个示例)和验证集(83个示例),总大小约为468MB。
This is a dental image semantic segmentation dataset containing tooth images and corresponding annotation images for identifying and classifying dental conditions such as caries (divided into 6 classes), abrasion, crown, and filling. The dataset is split into train (1237 examples) and validation (83 examples) sets, with a total size of approximately 468MB.
提供机构:
slnkvdns搜集汇总
数据集介绍
构建方式
AlphaDent数据集致力于推动口腔医学影像智能分析技术的发展,其构建围绕牙齿疾病语义分割任务精心设计。该数据集包含高分辨率的口腔内窥镜图像,每张图像均配备对应的精确像素级标注图,覆盖了磨耗、六大类龋齿、牙冠、充填体及背景共十类语义类别。数据集划分为训练集1237例与验证集83例,确保模型训练的充分性与评估的可靠性,为牙齿疾病的自动化诊断提供了坚实的数据基础。
特点
AlphaDent数据集的核心特色在于其精细的语义类别体系与专业的临床相关性。它不仅涵盖了从浅表到深层的全级别龋齿分类(Caries Class 1至6),还纳入了磨耗、牙冠和充填体等常见修复体与病理状态,使得模型能够应对复杂的临床场景。此外,数据集采用图像与标注图一一对应的结构,简化了加载与预处理流程,为研发高精度口腔疾病分割模型提供了标准化、高质量的基准数据。
使用方法
AlphaDent数据集可通过Hugging Face Datasets库便捷加载,用户只需指定'AlphaDent'名称即可获取默认配置下的训练和验证分片。数据集中每一条样本包含原始口腔图像'image'和对应的分割标注图'annotation',后者可直接用于监督学习。研究人员可利用该数据集训练语义分割模型,并通过预定义的十类类别映射(semantic_class_to_id)对预测结果进行解码与评估,适用于口腔疾病诊断、治疗规划等医学影像分析任务。
背景与挑战
背景概述
口腔健康作为全身健康的重要窗口,其疾病诊断的智能化进程正日益受到关注。AlphaDent数据集由相关研究机构于近期创建,旨在推动深度学习在牙科影像分析领域的应用。该数据集聚焦于牙科疾病的语义分割任务,涵盖磨耗、六类龋齿(Class 1至Class 6)、牙冠、填充物及背景等共10个语义类别,为牙科影像的精细分类与分割提供了宝贵的标注资源。通过对1237张训练图像和83张验证图像的高质量像素级标注,AlphaDent为构建自动化牙科诊断系统奠定了坚实的数据基础,有望显著提升牙科疾病筛查的准确性与效率,对该领域的研究与发展具有重要推动力。
当前挑战
AlphaDent数据集所解决的核心领域挑战在于牙科影像中病变区域的精准语义分割,这要求模型能够区分形态相似、边界模糊的多种牙齿疾病(如不同级别的龋齿)以及人工修复体(如牙冠、填充物),对视觉特征的捕获能力提出了极高要求。在数据集构建过程中,挑战同样显著:牙科X线或口腔内窥镜图像往往存在光照不均、设备差异等问题,使得标注工作高度依赖专业牙科医生,且不同医生对病灶边界的判断可能存在主观差异,这给标注一致性与质量控制带来了巨大困难。此外,罕见或早期病变样本的获取与标注也增加了数据集的构建难度与成本。
常用场景
经典使用场景
AlphaDent数据集是口腔影像分析领域的一颗璀璨明珠,专为牙齿语义分割任务而生。该数据集涵盖了1237张训练图像与83张验证图像,每张图像均配备精细的像素级标注,精准勾勒出牙齿磨损、六类龋齿、牙冠、填充物及背景等九种语义类别。在经典使用场景中,研究者常以AlphaDent为基石,构建深度学习模型,如U-Net或Transformer架构,对口腔全景X光片或内窥镜图像进行逐像素分类,从而实现牙齿结构与病变区域的自动化识别。这一过程不仅考验模型的语义理解能力,更推动着口腔医学影像分析从人工判读迈向智能化诊断的革命性跨越。
衍生相关工作
AlphaDent数据集的诞生,犹如投入学术湖面的一颗石子,激起层层涟漪,催生了一系列衍生研究工作。许多学者以其为数据基底,探索了不同的深度学习范式的优化路径,例如引入注意力机制增强对细小龋损的捕捉能力,或采用半监督与自监督学习方法缓解标注数据稀缺的问题。同时,该数据集也推动了跨领域迁移学习的研究,如将医学影像分割中成熟的Mask R-CNN或nnU-Net框架适配至口腔场景,并验证其泛化性能。更令人振奋的是,AlphaDent已成为口腔影像大模型(如MedSAM)微调与评估的关键测试床,为构建通用医学影像分割模型提供了宝贵的专项数据支撑,深刻影响着口腔智能诊疗的前沿方向。
数据集最近研究
最新研究方向
AlphaDent数据集作为口腔医学影像智能分析的前沿资源,聚焦于牙科疾病的细粒度语义分割任务。该数据集涵盖了磨损、六类龋齿、牙冠及填充物等关键病理类别,与当前人工智能辅助口腔健康诊断的热点紧密契合。其精细的标注体系为深度学习模型在牙科X线片或口腔内镜图像上的精准病变识别提供了重要基准,推动了从传统人工判读到自动化定量评估的范式转变。该数据集的发布显著促进了口腔影像学与计算机视觉的交叉创新,为临床早期龋齿检测、修复体状态监测及治疗规划优化奠定了数据基础,对提升口腔疾病筛查效率和标准化水平具有深远意义。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


