
mteb/fleurs
收藏官方服务:
资源简介:
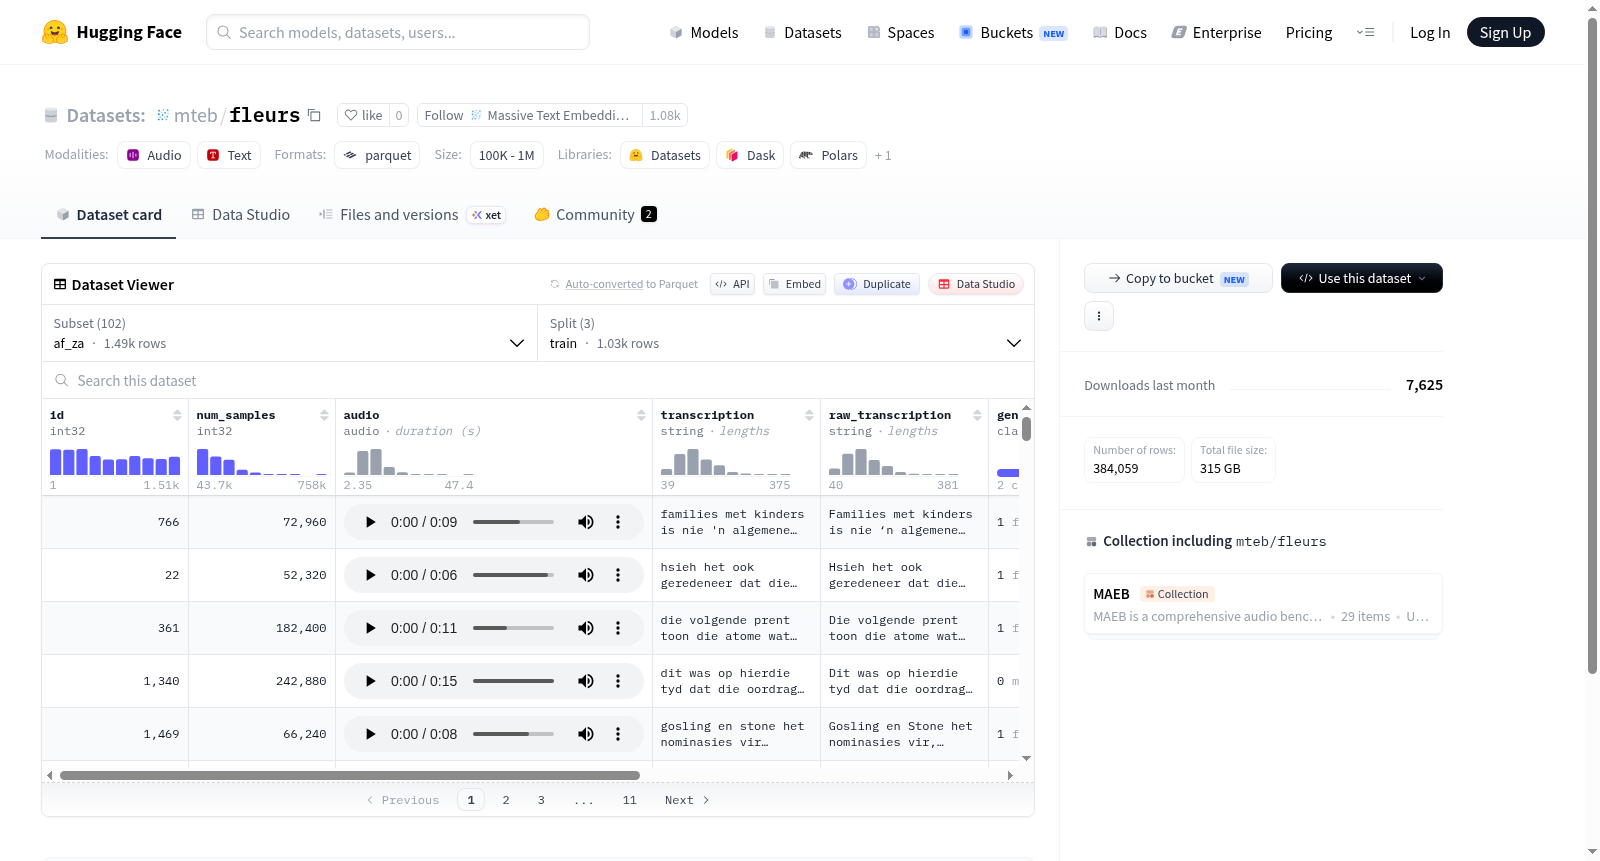
该数据集是一个多语言语音识别数据集,包含103种语言的音频样本,采样率为16kHz。每个样本包含音频数据、转录文本(原始和处理后版本)、说话者性别信息、语言标识和语言组别分类。数据集按语言配置(如af_za、am_et等)组织,每个配置分为训练集、验证集和测试集,用于支持语音处理和自然语言理解任务。
This dataset is a multilingual speech recognition dataset containing audio samples in 103 languages with a sampling rate of 16kHz. Each sample includes audio data, transcription text (both raw and processed versions), speaker gender information, language identifiers, and language group classifications. The dataset is organized by language configurations (e.g., af_za, am_et, etc.), with each configuration split into training, validation, and test sets, designed to support speech processing and natural language understanding tasks.
提供机构:
mteb搜集汇总
数据集介绍
构建方式
FLEURS数据集是Google基于Fleurs Benchmark项目构建的多语种语音识别基准数据集,其构建过程遵循严格的语音语料采集与标注规范。该数据集覆盖102种语言,每种语言均包含独立的配置项,例如af_za、am_et等,每个配置项内设有训练集、验证集和测试集。每条语音样本配有16kHz采样率的音频数据、人工标注的转录文本(transcription)和原始转录文本(raw_transcription),同时附加说话人性别标签与语言标识符。数据集的划分依据语言家族和地区(如西欧、东欧、中亚等)进行归组,确保了语言多样性的系统覆盖。
使用方法
在HuggingFace平台上,FLEURS数据集可通过Datasets库便捷加载。用户根据研究需要选择特定语言配置,例如使用`load_dataset('fleurs', 'af_za')`即可获取该语言的音频与文本数据。数据集的音频特征已集成解码功能,可直接获取数组形式的波形。典型应用场景包括多语种语音识别模型的训练与评估,研究者可以利用训练集(如af_za的1032条样本)进行模型微调,并在验证集和测试集上验证性能,同时借助lang_group_id进行跨语言组的泛化分析。
背景与挑战
背景概述
FLEURS(Few-shot Learning Evaluation of Universal Representations of Speech)数据集诞生于2022年,由Google Research团队主导构建,旨在填补多语言语音识别领域低资源语言数据匮乏的空白。该数据集覆盖102种语言,涵盖六大语系区域,每个语种均包含音頻、转写文本及说话者性别等元数据,为跨语言语音表征学习提供了标准化评测基准。其核心研究问题聚焦于如何在有限标注数据下,提升多语言语音系统的泛化能力,尤其关注那些在传统语音数据集中长期被忽视的非洲、南亚及东南亚语种。FLEURS的发布显著推动了多语言语音识别与迁移学习的发展,成为衡量通用语音模型性能的重要标杆,在语音领域内具有广泛影响力。
当前挑战
该数据集所解决的领域核心挑战在于多语言自动语音识别(ASR)中低资源语言的严重数据不足问题。传统数据集常呈现英语中心化倾向,导致模型对非英语语种的识别能力孱弱,而FLEURS通过覆盖102种语言为均衡训练提供了可能。构建过程中遭遇的另一重大挑战是数据采集的多样性与一致性平衡——需确保每语种音頻在嘈杂环境、口音差异及录音设备异性上均具代表性,同时标注准确性与规模化并行推进。从数据集结构可见,每种语言均单独配置训练、验证及测试集,各集样本量差异显著,反映了获取低资源语言高质量标注数据的艰巨性,这对数据采集团队的多地协同能力提出了极高要求。
常用场景
经典使用场景
在语音与语言技术研究领域,FLEURS数据集因其覆盖102种语言、涵盖多个语系和地域的庞大规模,成为评估多语种语音识别模型性能的黄金标准。该数据集最经典的使用场景是作为跨语种语音识别(ASR)的基准测试平台,研究者利用其精心划分的训练、验证与测试集,系统性地衡量模型在从高资源语言(如英语、西班牙语)到低资源语言(如沃洛夫语、卢干达语)上的转录精度,以此推动多语种泛化能力的提升。
解决学术问题
FLEURS数据集的核心价值在于破解了低资源语言语音识别研究中的数据荒漠困境。学术界长期受限于语料库极度不均衡,导致多数全球南方语言在语音技术中备受忽视。该数据集通过大规模、高质量的多语种语音与文本对齐语料,为探究跨语言表征学习、迁移学习与泛化误差分析提供了关键支撑。其存在不仅助力揭示语音模型在不同语系与音系结构下的行为差异,更显著加速了通用语音基础模型的构建进程,对推动普惠性语音技术具有里程碑式的意义。
实际应用
在实际应用中,FLEURS数据集成为科技公司构建包容性语音产品的数据基石。例如,国际组织与多语种平台利用它训练能够识别非洲祖鲁语、南亚阿萨姆语等冷门语言的语音助手,从而打破语言障碍,服务更广泛的人群。在内容安全审核领域,模型借助该数据集学习对多语种音频进行关键词检测,实现对不同语言环境中的有害信息筛查。此外,教育科技企业也依托该语料库开发面向母语为少数语言的儿童听说学习应用,切实缩小数字鸿沟。
数据集最近研究
最新研究方向
在语音识别领域,fleurs数据集凭借其覆盖102种语言与方言的广袤疆域,成为推动多语言自动语音识别(ASR)前沿研究的基石。当前热点聚焦于低资源语言的鲁棒性建模,特别是在撒哈拉以南非洲、南亚及东南亚等语言多样性丰富的区域,fleurs为打破资源壁垒、促进语言技术的普惠发展提供了关键支撑。其精细标注的语种、性别及地域分组信息,助力研究者探索语料偏差对模型泛化的影响,并催生了针对跨语言迁移学习与zero-shot场景的革新方法,对构建包容性语音生态具有深远意义。
以上内容由遇见数据集搜集并总结生成


