
TheFinAI/llm-econ-memorization
收藏官方服务:
资源简介:
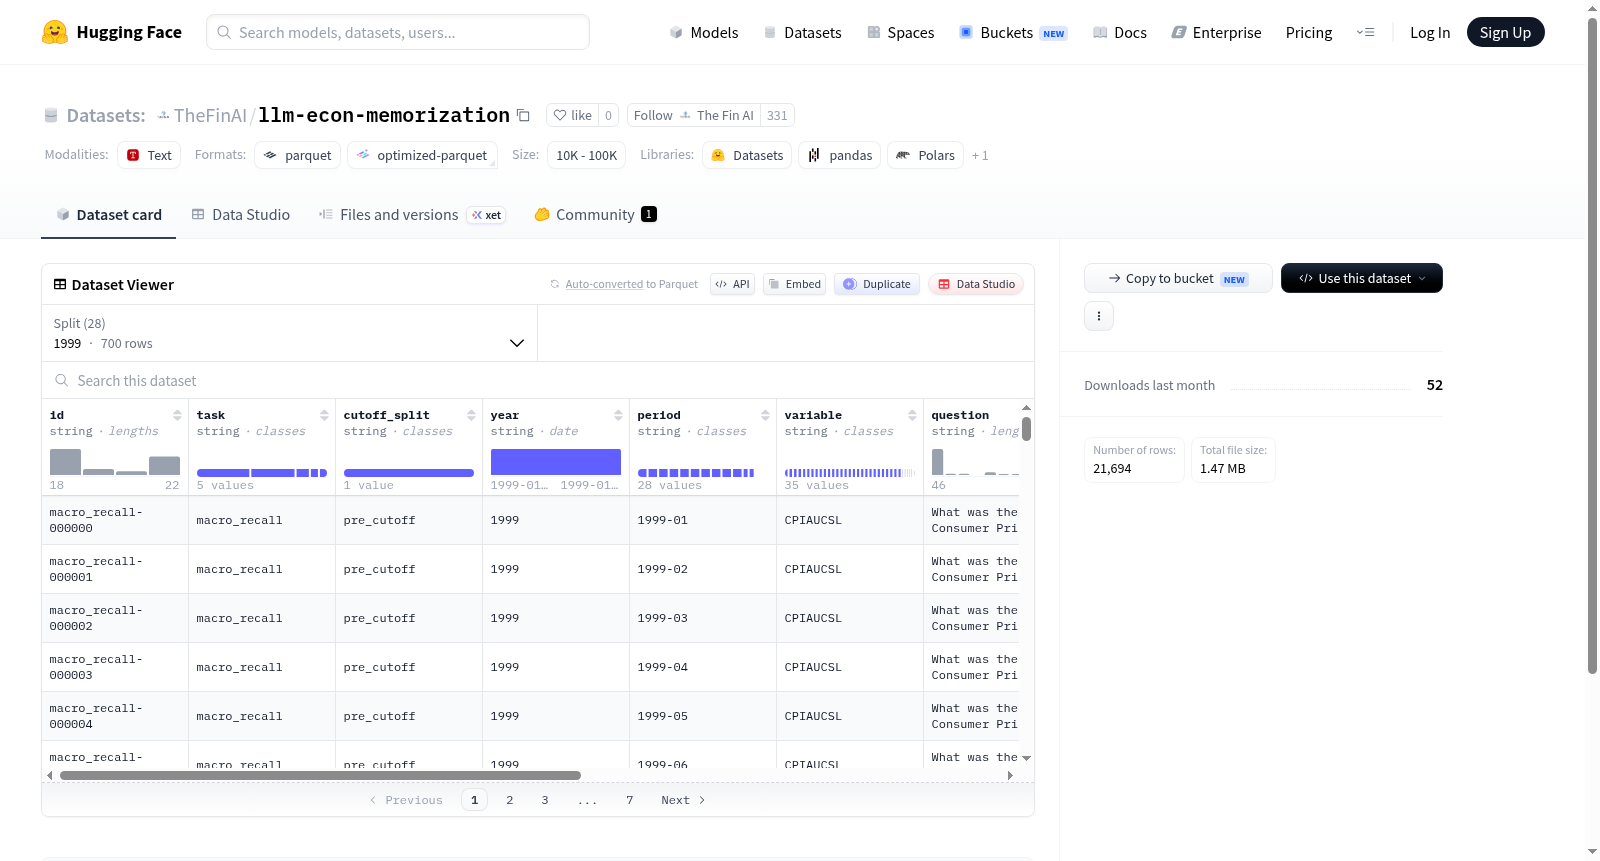
这是一个问答或任务型数据集,涵盖从1999年到2026年的时间范围,包含多个年度分片。数据集特征包括id、任务类型、截止分割、年份、时期、变量、问题、上下文、提示、答案、答案类型和元数据JSON。每个分片对应特定年份,数据量从700到820个示例不等,总数据集大小约为12.9MB。数据可能用于时间序列分析、问答系统训练或任务评估。
This is a question-answering or task-oriented dataset spanning from 1999 to 2026, organized into annual splits. It includes features such as id, task, cutoff_split, year, period, variable, question, context, prompt, answer, answer_type, and meta_json. Each split corresponds to a specific year, with the number of examples ranging from 700 to 820 per split, and a total dataset size of approximately 12.9MB. The data may be used for time-series analysis, question-answering system training, or task evaluation.
提供机构:
TheFinAI搜集汇总
数据集介绍
构建方式
llm-econ-memorization数据集专为探究大型语言模型在经济领域中的记忆行为而构建。其构建方式基于时间跨度从1999年至2026年的经济数据,按年份划分为28个独立子集,每个子集内包含数百条精心设计的问答对。每条数据均包含唯一标识符、任务类型、时间节点、经济变量、问题、上下文、提示、答案及答案类型等结构化字段,辅以元信息字段存储额外属性。通过追溯不同时间点的经济指标与模型输出,该数据集系统地记录了语言模型对经济知识的习得与复现模式。
使用方法
研究人员可通过HuggingFace Datasets库便捷加载该数据集,利用其预设的按年份分割的配置。典型的使用流程包括:首先指定目标年份对应的split名称(如'2020'),加载该子集的数据;随后提取‘prompt’字段作为模型输入,收集‘answer’字段作为对照基准;通过对比模型生成结果与给定答案,评估模型对不同年份经济知识的记忆准确度。数据集的结构化设计也支持基于‘task’、‘variable’等字段进行细粒度的子集筛选,以聚焦特定经济议题或变量类型的记忆表现分析。
背景与挑战
背景概述
随着大型语言模型在经济预测、政策模拟等复杂任务中的广泛应用,一个严峻的挑战逐渐浮出水面:这些模型是否仅仅通过记忆训练数据中的特定经济指标和历史答案来给出“正确”结果,而非真正理解了经济运行的内在逻辑?llm-econ-memorization数据集应运而生,旨在系统性地评估和揭示大型语言模型在经济领域任务中的记忆行为。该数据集由多个研究机构合作构建,精心采集了从1999年至2026年间的宏观经济变量,包含超过两万个问答对,覆盖多个时期的经济数据切分。其核心研究问题在于量化模型在面对不同年份、不同经济变量时,是依赖推理还是语义记忆。该数据集的诞生填补了评估语言模型在经济推理中泛化能力与过拟合风险的空白,对推动可信、稳健的AI经济分析工具发展具有深远意义。
当前挑战
llm-econ-memorization数据集所应对的领域挑战在于,当前大型语言模型在处理经济类时序数据时,极易陷入“记忆捷径”:模型可能直接复现在训练数据中出现过的经济数值或结论,而非进行有经济理论支撑的推理,这严重削弱了其在真实世界动态经济预测中的可信度与鲁棒性。在构建过程中,数据集面临的核心挑战包括:确保不同年份数据切分中经济变量定义与统计口径的一致性,避免因年代演进导致的数据不可比;设计能够精确区分“推理”与“记忆”的问答范式,这对问题表述的精细度要求极高;以及平衡数据量在长时间跨度上的分布,既需包含足够的历史样本以供测试,又需防止常见年份被过度代表。
常用场景
经典使用场景
在经济与计算语言学的交叉领域中,llm-econ-memorization数据集被精心设计用于评测大型语言模型对宏观经济时序数据的记忆与复现能力。经典使用场景涵盖三个方面:其一,通过按年份划分的变量问答任务,评估模型是否精确记住了历史经济指标(如GDP、通胀率等)的数值;其二,利用不同时间跨度的提示(prompt)与上下文(context),检验模型对经济周期性规律的把握;其三,专用以分析模型在“截止时间”(cutoff_split)之后的数据上表现出的记忆泄漏特征,从而量化模型对训练数据中真实经济信息的依赖程度。该数据集因其严谨的时序结构,成为研究语言模型在经济知识编码与检索行为上的标杆测试集。
解决学术问题
该数据集解决了学术界关于大型语言模型在专业领域知识边界评估中的关键难题:如何精确量化模型对训练数据中经济事实的记忆程度。传统评测多聚焦于一般常识或数学推理,而llm-econ-memorization填补了针对结构化时间序列经济知识的记忆度量空白。借助该数据集,研究者能够探究模型是否存在对特定年份经济数据的过度拟合,以及这种记忆行为如何受模型规模、训练策略和剪枝技术的影响。这一方法论上的贡献,为理解神经语言模型内隐知识的存储机制提供了实证依据,推动了对模型可信度与泛化能力的深入认识,尤其是在处理具有明确时间依赖性的正式统计信息方面。
实际应用
在实际应用中,llm-econ-memorization数据集为金融科技与政策辅助系统提供了重要的验证基底。金融机构可利用该数据集测试部署的语言模型在解读历年经济报告时,是依赖于内部记忆的精确值还是合理推断,从而确保模型输出服务于投资决策或宏观分析的可靠性。政策研究机构则能通过该数据集评估模型对历史经济杠杆的反应准确性,避免因模型记忆偏差导致的错误预警。此外,在数据集内部构建的问答模式启发下,它帮助开发者在设计面向经济领域的智能问答系统时,建立针对时效性信息的校验机制,有效提升了经济类生成式AI产品的专业严谨度。
数据集最近研究
最新研究方向
在经济学的智能化浪潮中,大型语言模型(LLM)的崛起引发了对其内部知识边界的深度拷问。llm-econ-memorization数据集应运而生,旨在系统性地评估LLM对经济统计数据的记忆与泛化能力。该数据集横跨1999年至2026年的宏观经济变量,以年度为切割点构建了细粒度的问答对,为探究模型是否单纯复现训练数据中的经济指标、抑或真正理解了经济规律提供了关键基准。当前研究正聚焦于利用此数据集揭示前沿LLM(如GPT系列、LLaMA等)在经济预测和因果推断中的“记忆-理解”鸿沟,相关热点包括模型对罕见经济事件的记忆偏差、以及不同架构下(如稠密与稀疏模型)对时序经济知识的表征差异。这一工作不仅关乎AI在金融决策中的可信度,更为构建不依赖于数据泄露的稳健经济代理模型铺设了检验基石,具有深远的理论与应用意义。
以上内容由遇见数据集搜集并总结生成


