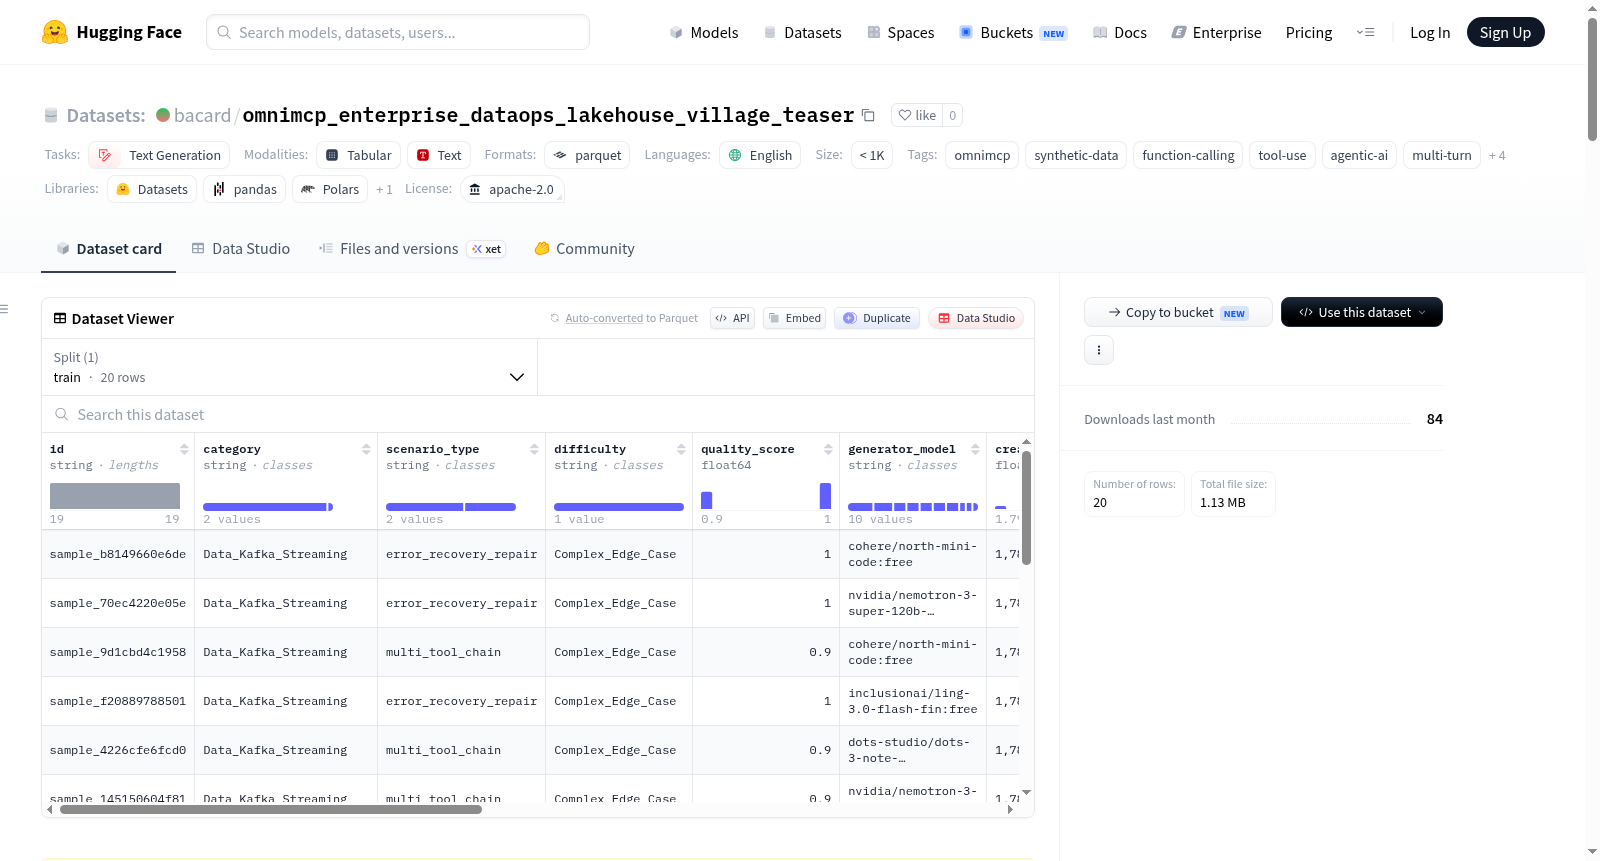
omnimcp_enterprise_dataops_lakehouse_village_teaser
收藏资源简介:
OmniMCP - 企业数据运营与Lakehouse流处理村庄:实时分析与仓库套件(评估预告版)是一个免费的评估预告数据集,包含少于1000个样本。该数据集为多轮对话格式,专门用于训练和评估代理AI进行函数调用与工具使用,场景聚焦于企业数据运营、实时分析和数据仓库套件。所有数据均为合成数据,经过严格语法验证(AST和Pydantic),确保0.0%语法错误;数据经过数学上清理,符合GDPR/DSGVO合规要求(RFC 2606);并符合EU AI Act第50和53条关于合成来源的声明。数据集可用于对话生成、文本生成以及多轮代理AI场景的训练与评估。
OmniMCP - Enterprise Data Operations & Lakehouse Stream Processing Village: Real-Time Analytics & Warehouse Suite (Evaluation Preview) is a free evaluation preview dataset containing fewer than 1,000 samples. The dataset is in multi-turn dialogue format, specifically designed for training and evaluating agent AI in function calling and tool usage, with scenarios focused on enterprise data operations, real-time analytics, and data warehouse suites. All data is synthetic, has undergone rigorous syntax validation (AST and Pydantic), ensuring 0.0% syntax errors; data is mathematically cleaned, compliant with GDPR/DSGVO requirements (RFC 2606); and complies with EU AI Act Articles 50 and 53 regarding synthetic origin declarations. The dataset can be used for training and evaluation in dialogue generation, text generation, and multi-turn agent AI scenarios.
OmniMCP - Enterprise DataOps & Lakehouse Streaming Village - Real-Time Analytics & Warehouse Suite (Evaluation Teaser)
数据集概述
- 名称: OmniMCP: Enterprise DataOps & Lakehouse Streaming Village - Real-Time Analytics & Warehouse Suite (Evaluation Teaser)
- 语言: 英语 (en)
- 许可证: Apache 2.0
- 数据集规模: n<1K(少于1000条样本)
- 任务类别: 对话 (conversational)、文本生成 (text-generation)
- 数据类型: 合成数据 (synthetic-data)
- 标签: omnimcp、synthetic-data、function-calling、tool-use、agentic-ai、multi-turn、unsloth、axolotl、vllm、enterprise_dataops_lakehouse_village
数据集核心价值
该数据集宣称专注于解决以下企业级痛点:
- 消除 Kafka 消费者组滞后
- 削减 Snowflake 计算积分消耗达 40%
- 实现零停机数据库索引迁移
数据集性质
- 该数据集为免费评估版本(Evaluation Teaser),经过验证的多轮对话智能体AI数据集
- 完整的生产级主包及商业EULA需通过Gumroad平台购买获取
质量与法律保障
- 0.0% 语法错误保证: 经过严格的 AST 和 Pydantic 验证
- 100% GDPR/DSGVO 合规: 采用数学方法净化的 RFC 2606 数据
- EU AI Act 第50及53条合规: 完整声明合成数据来源
使用示例
可通过 Hugging Face datasets 库加载数据集,具体代码如下:
python from datasets import load_dataset
加载免费评估数据集
dataset = load_dataset("bacard/omnimcp_enterprise_dataops_lakehouse_village_teaser") print(f"Loaded {len(dataset[train])} verified multi-turn training samples!") print(dataset[train][0])
所属体系
该数据集属于 OmniMCP 四层模块化体系中的第3级(VILLAGE 层级),即“企业数据运维湖仓村庄”,专注于将4个专业House组合而成的交钥匙行业解决方案,覆盖 Kafka 流处理、dbt、Snowflake 数据仓库等领域。其商业版本售价为199欧元,可于 Gumroad 平台购买。