遇见数据集

RACA-PROJECT-MANIFEST

收藏
Hugging Face2026-07-17 更新2026-07-18 收录
官方服务:

资源简介:

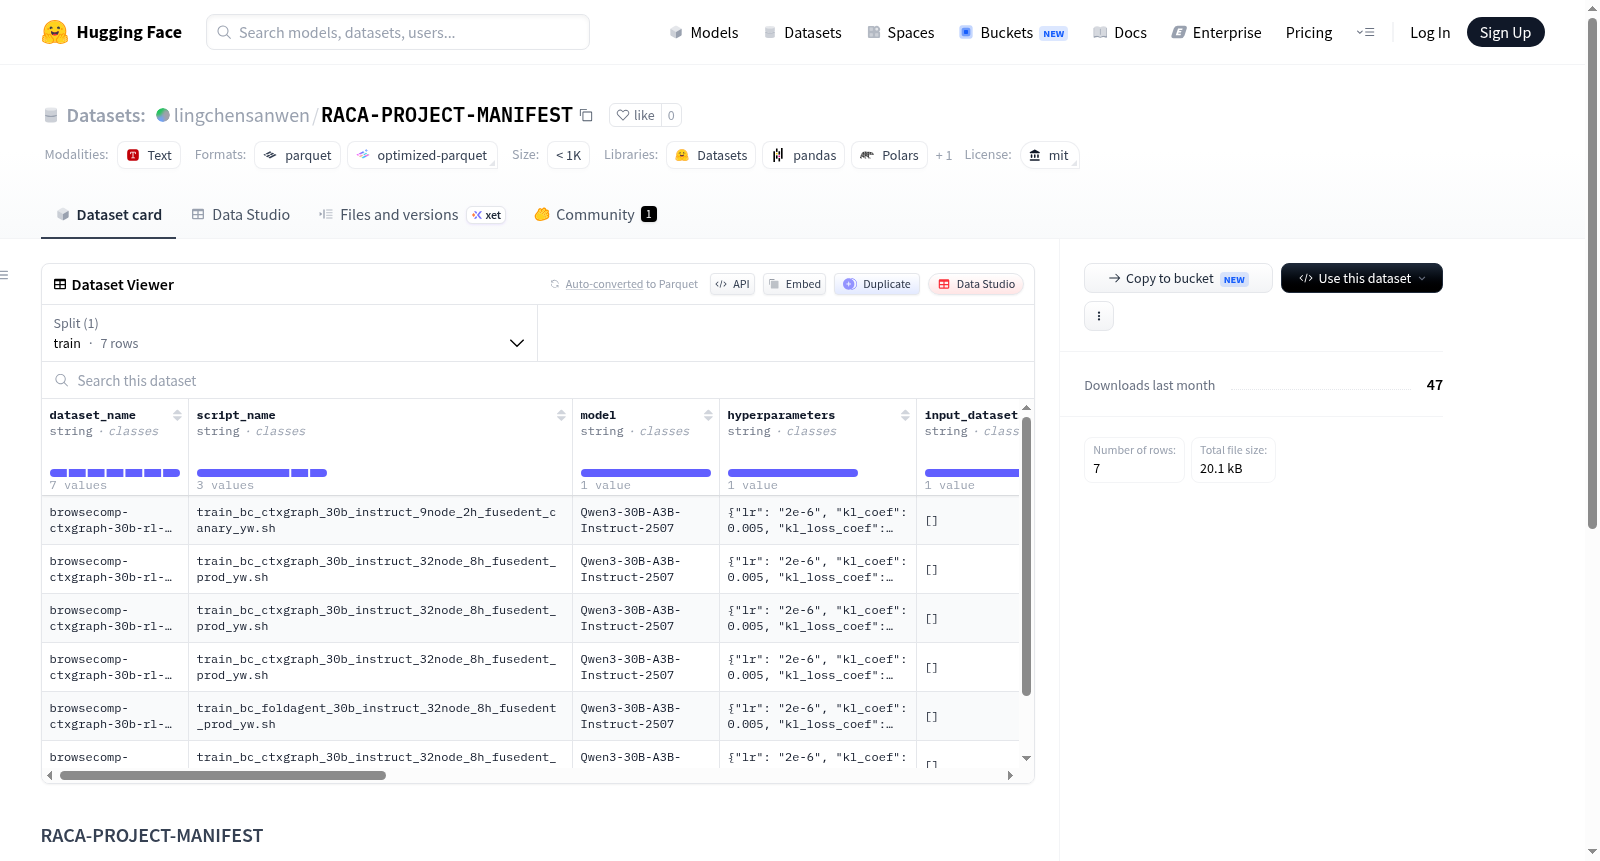
RACA-PROJECT-MANIFEST 是一个元数据数据集,作为 lingchensanwen 组织下所有数据集的中央注册表或清单。其主要功能是追踪和索引该组织内托管的数据集集合,具体记录了当前追踪的数据集总数量(7个)以及清单的最后更新时间。用户可以通过 Hugging Face 的 datasets 库加载此清单,以编程方式获取被管理数据集的概览信息。该数据集本身不包含具体的应用数据(如文本或图像),而是专门用于支持数据集发现、管理和组织工作流。

RACA-PROJECT-MANIFEST is a metadata dataset that serves as a central registry or manifest for all datasets under the lingchensanwen organization. Its primary function is to track and index the collection of datasets hosted within this organization, specifically recording the total number of currently tracked datasets (7) and the last update time of the manifest. Users can load this manifest via the Hugging Face datasets library to programmatically obtain an overview of the managed datasets. The dataset itself does not contain specific application data (such as text or images), but is dedicated to supporting dataset discovery, management, and organizational workflows.

创建时间:
2026-07-12
原始信息汇总

RACA-PROJECT-MANIFEST 数据集概述

  • 数据集名称:RACA-PROJECT-MANIFEST
  • 许可证:MIT
  • 数据集类型:项目清单/索引注册表
  • 功能描述:该数据集为 lingchensanwen 组织下所有数据集的中央注册表,用于追踪和记录组织内已发布的数据集。

关键统计信息

  • 追踪的数据集总数:7 个
  • 最近更新日期:2026-07-17T15:11:22.068531+00:00

使用方式

数据集通过 Hugging Face 的 datasets 库加载,具体操作如下:

python from datasets import load_dataset

manifest = load_dataset("lingchensanwen/RACA-PROJECT-MANIFEST", split="train") print(f"Tracking {len(manifest)} datasets")

  • 数据分割:训练集(train
  • 加载后输出示例:打印当前追踪的数据集数量。
搜集汇总
数据集介绍
RACA-PROJECT-MANIFEST 数据集图片
构建方式
RACA-PROJECT-MANIFEST 数据集作为 lingchensanwen 组织下所有数据集的中央注册表而构建,旨在实现数据资产的统一管理与追踪。其构建方式简洁而高效,通过维护一个集中式的清单,收录了当前组织内所追踪的 7 个数据集,并记录了元数据的最后更新时间,从而为数据集的版本控制与关联查询提供了坚实的基础。
使用方法
使用 RACA-PROJECT-MANIFEST 数据集极为便捷,遵循 HuggingFace Datasets 库的标准实践即可。用户只需通过 `load_dataset` 函数加载指定的标识符 'lingchensanwen/RACA-PROJECT-MANIFEST',并指定切分(split)为 'train',便能获取包含所有数据集记录的对象。随后,可以像操作普通数据集一样访问清单的长度及条目信息,为后续的自动化工作流或人工查阅提供接口。
背景与挑战
背景概述
RACA-PROJECT-MANIFEST 是由 lingchensanwen 组织创建于2026年的中央注册表数据集,旨在统一追踪该组织旗下全部7个数据集的元数据信息。该数据集的诞生源于当前多源异构数据集管理中的碎片化问题,通过构建一个轻量级、可扩展的清单式数据目录,为跨数据集检索、版本迭代与复用提供了标准化接口。其核心研究问题聚焦于如何高效整合分散数据集资产,提升数据发现的自动化程度。尽管该数据集规模有限,但作为组织级数据治理的基础设施,它在推动数据集协作开发与生命周期管理方面具有重要示范意义,尤其对中小规模研究团队的数据资产规范化管理形成了参考范式。
当前挑战
该数据集面临的首要挑战是解决领域内数据集分散管理带来的沉淀成本与协作障碍——当前多项目并行开发时,缺乏统一注册机制易导致数据重复采集或版本混淆,RACA-PROJECT-MANIFEST 通过集中式清单试图建立共识视图,但实际效果取决于各子数据集维护者的同步积极性。构建过程中,其核心挑战在于平衡清单的实时性与最小化维护负担:手动更新难以保证时效,而自动化爬取又面临不同数据集存储后端(如HuggingFace、本地文件系统)的接口异构性问题。此外,随着追踪数据集数量增长,清单自身的可扩展性和冲突解决机制仍有待优化。
常用场景
经典使用场景
RACA-PROJECT-MANIFEST 作为 lingchensanwen 组织内所有数据集的中枢注册表,其经典应用在于为研究者提供统一的数据集索引与管理入口。在自然语言处理与多模态学习领域,大规模数据集常分散于不同仓库,难以系统化追溯。该清单通过结构化记录7个数据集的元信息,使用户能够一键加载并快速获取整体概貌,为跨数据集的比较分析、联合训练以及数据治理奠定了坚实基础。
解决学术问题
该数据集核心解决了学术研究中的数据发现与版本控制难题。在开放科学浪潮下,研究者常面临数据集分散、更新滞后、引用模糊等问题,导致实验可复现性受损。RACA-PROJECT-MANIFEST 通过集中登记与标准化元数据,确保了数据来源的透明性与一致性,极大降低了学术探索中因信息不对称引发的冗余工作。其意义在于推动建立可追溯、可复现的数据生态,助力高效的科学发现循环。
实际应用
在实际应用中,该清单可作为自动化工作流的关键组件,例如在持续集成与实验管理系统中,自动检测数据集更新并触发相应数据处理流程。对于企业级AI开发团队,它帮助维护内部数据资产目录,确保模型训练、评估与部署各阶段所依赖的数据版本精准可控。此外,学术机构可将其集成至开放数据平台,方便用户一站式检索与下载多个关联数据集。
数据集最近研究
最新研究方向
RACA-PROJECT-MANIFEST作为lingchensanwen组织下的数据集中央注册表,当前追踪7个数据集,代表了自然语言处理领域中对数据集管理、溯源与标准化的前沿探索。其设计理念契合了近年来学术界对数据集透明度与可复现性的迫切需求,尤其是围绕大语言模型训练数据来源的争议,如版权合规与数据污染问题,促使研究者构建统一的元数据索引框架。该清单的持续更新机制为跨数据集关联分析、版本控制及模型性能对比提供了基础设施,有望推动NLP研究向更加系统化与可信赖的方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务