
biu-nlp/sentence_union_generation
收藏官方服务:
资源简介:
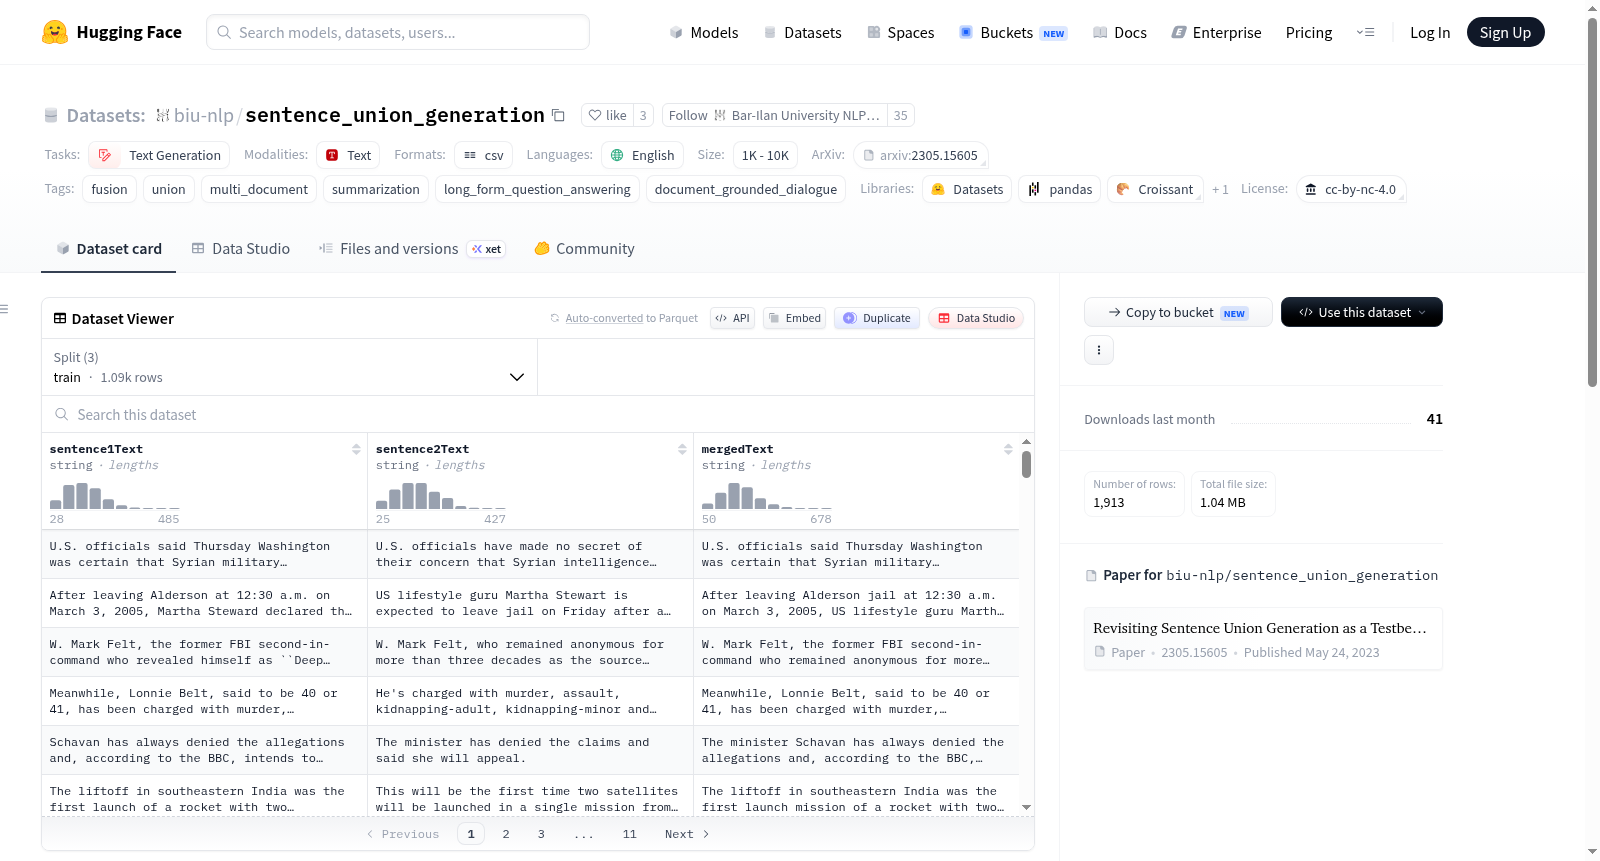
该数据集是论文《Revisiting Sentence Union Generation as a Testbed for Text Consolidation》的官方数据集,旨在通过句子联合生成任务来评估文本整合能力。数据集支持多文档摘要、长形式问答和基于文档的对话等任务,并提供了丰富的注释方法和工具,以及全面的评估协议。数据集还包含了对最先进语言模型的基线评估,分析了它们在多文本整合挑战中的能力和局限性。
该数据集是论文《Revisiting Sentence Union Generation as a Testbed for Text Consolidation》的官方数据集,旨在通过句子联合生成任务来评估文本整合能力。数据集支持多文档摘要、长形式问答和基于文档的对话等任务,并提供了丰富的注释方法和工具,以及全面的评估协议。数据集还包含了对最先进语言模型的基线评估,分析了它们在多文本整合挑战中的能力和局限性。
提供机构:
biu-nlp原始信息汇总
数据集概述
基本信息
- 许可证: cc-by-nc-4.0
- 任务类别:
- 文本到文本生成
- 文本生成
- 语言: 英语
- 标签:
- 融合
- 联合
- 多文档
- 摘要生成
- 长形式问答
- 文档基础对话
- 大小类别: 1K<n<10K
数据集描述
- 数据集名称: Revisiting Sentence Union Generation as a Testbed for Text Consolidation
- 研究机构:
- Bar-Ilan University
- One AI
- 数据集目的: 作为评估文本整合能力的测试平台,专注于句子联合生成任务,旨在分离整合挑战与主观内容选择。
数据集内容
- 注释方法: 提供精细化的注释方法和工具,用于众包句子联合。
- 数据集规模: 创建了迄今为止最大的联合数据集。
- 评估协议: 提出全面的评估协议,包括人类评估和自动评估。
- 基线模型: 评估了当前最先进的语言模型在该任务上的表现,并进行了详细的能力和限制分析。
搜集汇总
数据集介绍
构建方式
该数据集源自ACL 2023的研究工作,旨在重新审视句子联合生成任务作为文本整合的测试平台。构建过程中,研究团队提出了精细化的标注方法论与工具,通过众包方式收集了迄今为止规模最大的句子联合数据集。数据覆盖多种文本整合场景,包括多文档摘要、长文本问答及基于文档的对话,确保了对不同整合挑战的丰富覆盖。
特点
数据集的核心特点在于其将文本整合能力与主观内容选择解耦,为评估模型的多文本信息整合能力提供了清晰定义的基准。包含超过千条样本,涵盖英语环境下的多种任务类型,如文本生成与文本到文本生成。其标注数据不仅规模庞大,更注重对整合过程中部分重叠信息的处理,为模型能力的精准评测奠定了基础。
使用方法
该数据集适用于文本整合相关任务的训练与评估,如多文档摘要生成和长形式问答。用户可通过HuggingFace平台加载数据集,利用提供的代码库进行模型微调或基准测试。建议采用论文中提出的人机协同评估协议,结合自动指标与人工判断,全面衡量模型在句子联合生成中的表现,特别关注其对多文本信息整合的处理能力。
背景与挑战
背景概述
在自然语言处理领域,多文本信息整合是文本生成任务的核心挑战之一,尤其在多文档摘要、长文本问答及基于文档的对话系统中,模型需从多个部分重叠的输入中提取并融合关键信息。然而,现有任务常将内容选择与整合过程纠缠不清,主观性强且定义模糊,难以精确评估模型的整合能力。针对这一困境,巴伊兰大学的研究团队Eran Hirsch等人于2023年在ACL Findings上提出了句子联合生成任务,将其作为评估文本整合能力的标准化测试平台。该团队通过精细化的众包标注方法,构建了迄今为止规模最大的句子联合数据集,涵盖丰富的整合场景,旨在将整合挑战与主观内容选择解耦,为多文本信息融合研究提供清晰、可复现的基准。这一工作不仅推动了文本整合任务的规范化,也为后续模型性能的客观比较奠定了坚实基础。
当前挑战
句子联合生成任务面临的核心挑战在于多文本信息整合的复杂性。首先,模型需从多个部分冗余或冲突的输入句子中,准确识别并保留共同信息,同时消除重复与矛盾,这对语义理解与逻辑推理能力提出了极高要求。其次,构建过程本身充满困难:众包标注需确保不同标注者对“联合”概念理解一致,避免主观偏差;数据规模虽为目前最大,但仅涵盖数千样本,难以覆盖所有整合模式(如时序关系、因果推理等),限制了模型的泛化能力。此外,现有语言模型在基线评估中表现出整合策略单一、对细粒度语义差异敏感度不足等问题,尤其在处理长文本或多源异构信息时,易出现信息遗漏或过度融合,凸显了当前技术在处理多文档整合任务时的局限性。
常用场景
经典使用场景
句子联合生成(Sentence Union Generation)任务旨在将多段包含部分重叠信息的文本融合为一句连贯且信息完整的句子,是文本整合(Text Consolidation)领域的一项基础性测试任务。该数据集由Bar-Ilan大学团队构建,基于多文档摘要、长文本问答和文档导向对话等场景中对信息整合能力的迫切需求,提供了一个去除了主观内容选择干扰的标准化评估平台。其核心价值在于将文本整合从复杂下游任务中解耦出来,使研究者能够专注于评估模型对多源信息进行去重、合并与重组的核心能力。
解决学术问题
该数据集解决了多文本生成任务中一个长期存在的学术难题:如何在不依赖主观内容选择的前提下,客观评估模型的文本整合能力。传统多文档摘要等任务将内容选择与信息整合纠缠在一起,导致无法单独衡量模型对重叠信息的处理质量。通过提供精细的标注方法论和最大的句子联合数据集,研究者得以系统性地分析模型在信息融合、冗余消除、逻辑连贯性维持等方面的表现。该工作还提出了包含人工与自动评估的完整评测协议,为后续研究奠定了方法论基础。
衍生相关工作
该数据集衍生了一系列关于文本整合能力的经典研究工作。原文对GPT-3、T5等主流语言模型进行了系统性评测,揭示了它们在处理复杂重叠信息时的能力边界与局限。后续工作进一步探索了基于该数据集的跨语言文本整合、结构化信息融合等方向,并催生了将句子联合生成作为预训练任务的创新方法。该数据集还被用于多文档摘要模型的诊断性分析,帮助研究者识别模型在信息去重与逻辑重组方面的具体缺陷,从而驱动模型架构与训练策略的持续改进。
以上内容由遇见数据集搜集并总结生成


