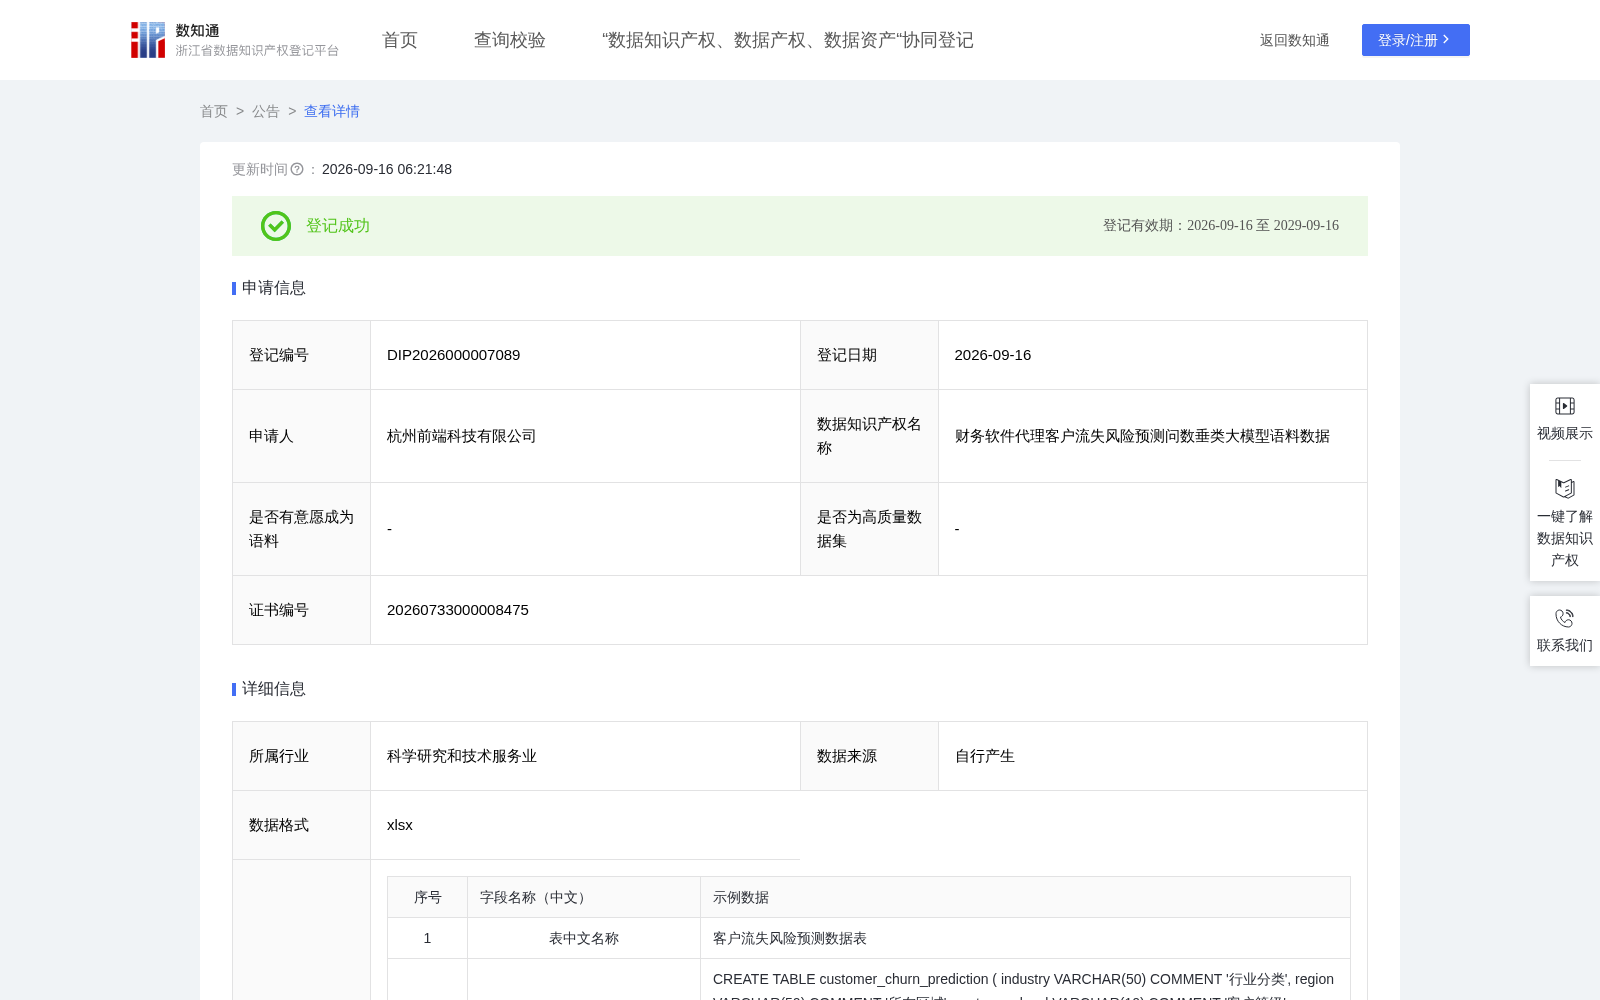
财务软件代理客户流失风险预测问数垂类大模型语料数据
收藏资源简介:
本数据来源于财务软件代理业务客户流失风险预测数据,涵盖客户行业分类、所在区域、客户等级、合作年限、流失风险评分、流失风险等级、流失概率、使用活跃度下降率、最近活跃距今天数、合同剩余月数、投诉次数、满意度趋势、风险因子数量、挽留措施标记、竞品接触标记、流失预警类型、重点客户标记、距上次续费月数等18个维度结构化数据,经清洗标准化、去标识化处理后构建问数语料库。在加工层面,将自然语言问题与标准SQL查询语句配对,覆盖风险评分统计、风险等级分布、流失概率排名、活跃度下降分析、合同到期预警、预警类型交叉、竞品接触影响、满意度趋势对比等10类查询场景,形成"问题→SQL→结果"三元组语料。当前财务软件代理行业面临流失风险识别依赖人工经验、风险等级评估标准缺失、活跃度下降趋势难以实时监控、竞品替代预警滞后、客户留存干预措施缺乏数据支撑等痛点。同时,该语料集经过标准化标注处理,可为财务软件代理领域BERT-Churn流失风险预测语义解析模型提供结构化训练样本,推动行业从"被动挽留流失客户"向"主动预警精准干预"演进。1.数据清洗与标准化:采集客户流失风险预测数据18个字段,按"客户编号+流失评估日期"去重,缺失值处理规则为:流失风险评分按同等级客户均值填充,使用活跃度下降率按行业中位数填充,满意度趋势缺失标记为"未知";异常值检测识别流失概率>100%或<0%、合同剩余月数<0、投诉次数<0等矛盾数据,矛盾数据举例:"流失风险等级为低风险但流失概率>70%"或"满意度趋势为上升但流失风险评分>80"的记录予以修正或剔除。 2.问题分类与结构化:按5大类分类:①风险统计类(COUNT/SUM/AVG聚合)、②风险分布类(GROUP BY+饼图)、③排名筛选类(ORDER BY+LIMIT/WHERE阈值)、④趋势分析类(CASE WHEN+下降率计算)、⑤交叉关联类(多维度GROUP BY+HAVING),每类生成20+条自然语言问题,覆盖风险评分、风险等级、流失概率、活跃度下降、合同到期、投诉、满意度趋势、竞品接触、预警类型等维度指标。 3.核心算法:采用开源预训练模型,(1)将表字段与问题实体对齐,(2)通过指针网络生成SQL SELECT/GROUP BY/ORDER BY/WHERE/HAVING子句,(3)复杂查询采用多条件嵌套SQL,(4)结果核验通过执行SQL并比对预期结果,结果核验正确率≥80%,人工核对正确率≥90%。 4.语料库迭代优化:构建"人工标注→错误分析→语料补充"闭环迭代机制,每周收集模型预测错误案例,分析SQL语法错误、字段映射错误、聚合逻辑错误三类问题,针对性补充薄弱查询类型的语料样本,持续提升模型的语义解析准确率。 5.语料独立性分析:本语料以客户流失的概率研判与风险预警为主体,核心在"流失可能性-风险等级-预警信号"的预判逻辑,字段围绕流失概率、风险评分、活跃度下降率、预警类型等概率性指标展开,反映模型对可能性推理与风险分级语义的专门理解,与客户价值、销售过程等以确定性经营数据、事实记录为主的语料,在指标性质、语义逻辑上存在本质差异。若合并训练,概率预判与确定性统计混同,会削弱模型对流失概率、风险等级等不确定性词的专门解析,降低各主题SQL生成准确性;分开训练可让模型专注风险预警语义,强化对概率推测与分级阈值的建模,提升解析精度,且各语料可独立扩充、独立评测,避免关联更新牵动全量重训,降低维护成本,符合垂类模型分域训练实践。