
遇见数据集

EdisonScientific/bixbench_hypothesis

收藏
Hugging Face2026-06-02 更新2026-05-10 收录
官方服务:

资源简介:

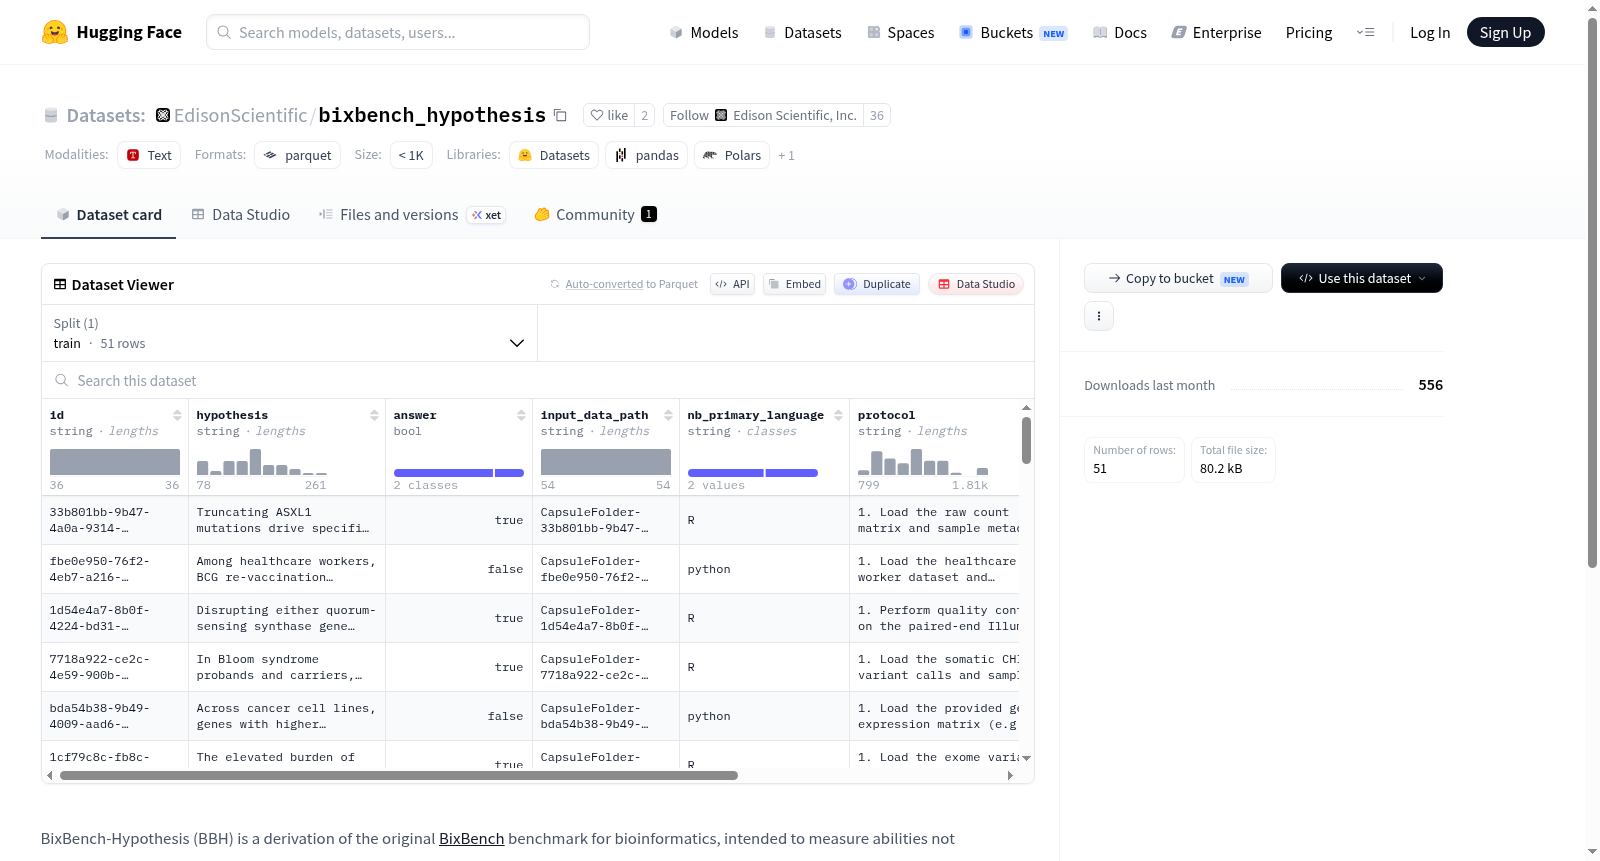
BixBench-Hypothesis (BBH) 是原始 BixBench 生物信息学基准测试的一个衍生版本,旨在衡量原始 BixBench 未捕获的能力:在模糊性下的分析判断或追求开放式目标假设的能力,这些更接近科学家的实际工作方式。BBH 适应了原始胶囊框架,将每个任务重新配置为(数据、假设、协议)元组,并配以评估标准。协议是逐步指南,用于对数据进行分析以解决假设;标准是结构化预期输出集,用于评分代理的分析,包括1或2点的子任务和与正确支持或拒绝假设相关的5点最终目标。数据集包含51个假设驱动任务,其中30个主要使用Python,21个主要使用R。

BixBench-Hypothesis (BBH) is a derivation of the original BixBench benchmark for bioinformatics, intended to measure abilities not captured by BixBench: analytical judgment under ambiguity or the ability to pursue a hypothesis with an open-ended goal, which are closer to how scientists actually work. BBH adapts the original capsule framework, reconfiguring each task as a (data, hypothesis, protocol) tuple paired with an evaluation rubric. The protocol is a step-by-step guide for carrying out an analysis on the data to address the hypothesis. The rubric is a structured set of expected outputs used to score an agents analysis, consisting of 1- or 2-point subtasks plus a 5-point final objective tied to correctly supporting or rejecting the hypothesis. There are 51 hypothesis-driven tasks comprising BixBench-Hypothesis. 30 capsules have a primary language of Python, while 21 are primarily R.

提供机构:
EdisonScientific
搜集汇总
数据集介绍
EdisonScientific/bixbench_hypothesis 数据集图片
构建方式
BixBench-Hypothesis (BBH) 数据集源自原始的生物信息学基准BixBench,旨在评估模型在模糊情境下的分析判断能力以及追求开放式目标的假设推理能力。其构建方式是基于原有的胶囊框架,将每个任务重新配置为一个由数据、假设和实验协议组成的三元组,并配以评分细则。实验协议提供了对数据进行分析以验证假设的逐步指南,而评分细则则定义了期望输出结构,包含1至2分的子任务和一个与支持或拒绝假设直接相关的5分最终目标。
特点
该数据集包含51项假设驱动型任务,其中30个胶囊的主要编程语言为Python,21个为R语言,覆盖了生物信息学中多样化的分析需求。其核心特点在于强调在模糊性下的分析判断,要求模型根据开放式的假设目标进行推理和验证,这更贴近科学家实际的工作方式。评分机制不仅关注子任务的完成,更着重于最终是否正确地支持或拒绝假设,从而全面衡量模型的高级分析能力。
使用方法
使用BixBench-Hypothesis数据集时,用户可以加载默认配置下的训练分片,其中包含51个样本。每条样本包括唯一的任务ID、假设文本、布尔型答案、输入数据路径、主要编程语言标识、实验协议、评分细则以及最高分值。研究者可通过这些结构化字段来训练或评估模型在假设驱动分析中的表现。建议结合Python或R环境运行协议中的分析步骤,并依据评分细则对模型输出进行自动化或人工评分,以评估其推理与判断能力。
背景与挑战
背景概述
BixBench-Hypothesis(BBH)数据集由FutureHouse机构于近年创建,旨在弥补生物信息学领域现有基准测试的不足。传统基准测试如BixBench主要评估模型在明确任务上的执行能力,而BBH聚焦于更贴近真实科研工作的复杂能力——在模糊情境下进行分析判断,并追求开放目标的假设验证能力。该数据集通过将每个任务重构为(数据、假设、协议)三元组并结合评估量规,要求模型不仅完成分析步骤,还需基于证据支持或反驳假设。BBH包含51个假设驱动任务,覆盖Python和R两种主流数据分析语言,为评估AI代理在生物信息学中的高级推理能力提供了标准化测试框架,对推动该领域人机协作研究具有重要影响。
当前挑战
BBH所解决的领域核心挑战在于,传统生物信息学任务通常预设明确目标(如分类或聚类),而真实科研场景中研究者常需在信息不完整或分析路径模糊时,自主提出假设并通过探索性分析验证。BBH通过设计开放式假设任务,要求模型在无明确最优解的情况下,综合协议指导与数据特征做出合理判断。构建过程中,该数据集面临如何将专家假设验证思维转化为标准化评测的难题:每个任务需精细设计步骤化协议和结构化量规,既要保留科研开放性,又要确保评分一致性。此外,51个任务涵盖不同难度层次,需平衡任务多样性与评估可行性,这对数据规模(51例)和跨语言(Python/R)的协调提出了技术挑战。
常用场景
经典使用场景
BixBench-Hypothesis(BBH)作为生物信息学领域BixBench基准的衍生版本,聚焦于评估人工智能系统在模糊情境下的分析判断能力。其经典使用场景是为大语言模型或智能体提供端到端的假设驱动型科研任务:每个任务以(数据、假设、协议)三元组形式呈现,智能体需遵循协议中的分步分析指南,对给定数据进行处理,最终依据评估量规正确支持或反驳假设。这一设计模拟了科学家实际工作中从数据探索到结论验证的完整闭环,尤其适用于测试模型在开放目标下自主规划分析路径、执行计算操作并得出严谨结论的综合能力。
衍生相关工作
围绕BixBench-Hypothesis已衍生出若干具有影响力的工作。一方面,研究者基于其三元组框架开发了更细粒度的评估体系,例如针对特定生物信息学协议(如差异表达分析、通路富集)设计专项子任务,扩展了基准在单细胞测序、空间转录组等新兴领域的适用性。另一方面,该数据集催生了新型训练策略:部分工作利用假设驱动场景下的错误模式对语言模型进行微调,显著提升了模型在开放式任务中的规划与纠错能力。此外,跨领域研究者将其与符号推理系统结合,探索了神经-符号方法在科学假设验证中的潜力,为构建可解释的AI科研伙伴提供了重要基线。
数据集最近研究
最新研究方向
BixBench-Hypothesis数据集聚焦于衡量人工智能在生物信息学领域的分析判断能力,尤其是在模糊情境下进行开放目标假设推理的科研素养。该数据集将传统基准测试升级为(数据,假设,协议)三元组结构,配合精细量化的评分准则,模拟科学家真实研究过程中的不确定性与目标导向性。当前前沿研究方向包括:评估大语言模型在多模态生物数据整合中的假设验证能力,探索AI在无预设答案场景下自主规划实验路径的鲁棒性,以及推动生物信息学自动化分析从任务执行向科学发现层次的跃迁。这一基准的提出与可重复性危机及AI驱动的自动化科学发现热点紧密相连,为构建更贴近实战的生物信息学AI评估体系奠定基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

