
遇见数据集

AIML-TUDA/COCOLogic-v2

收藏
Hugging Face2026-07-16 更新2026-07-22 收录
官方服务:

资源简介:

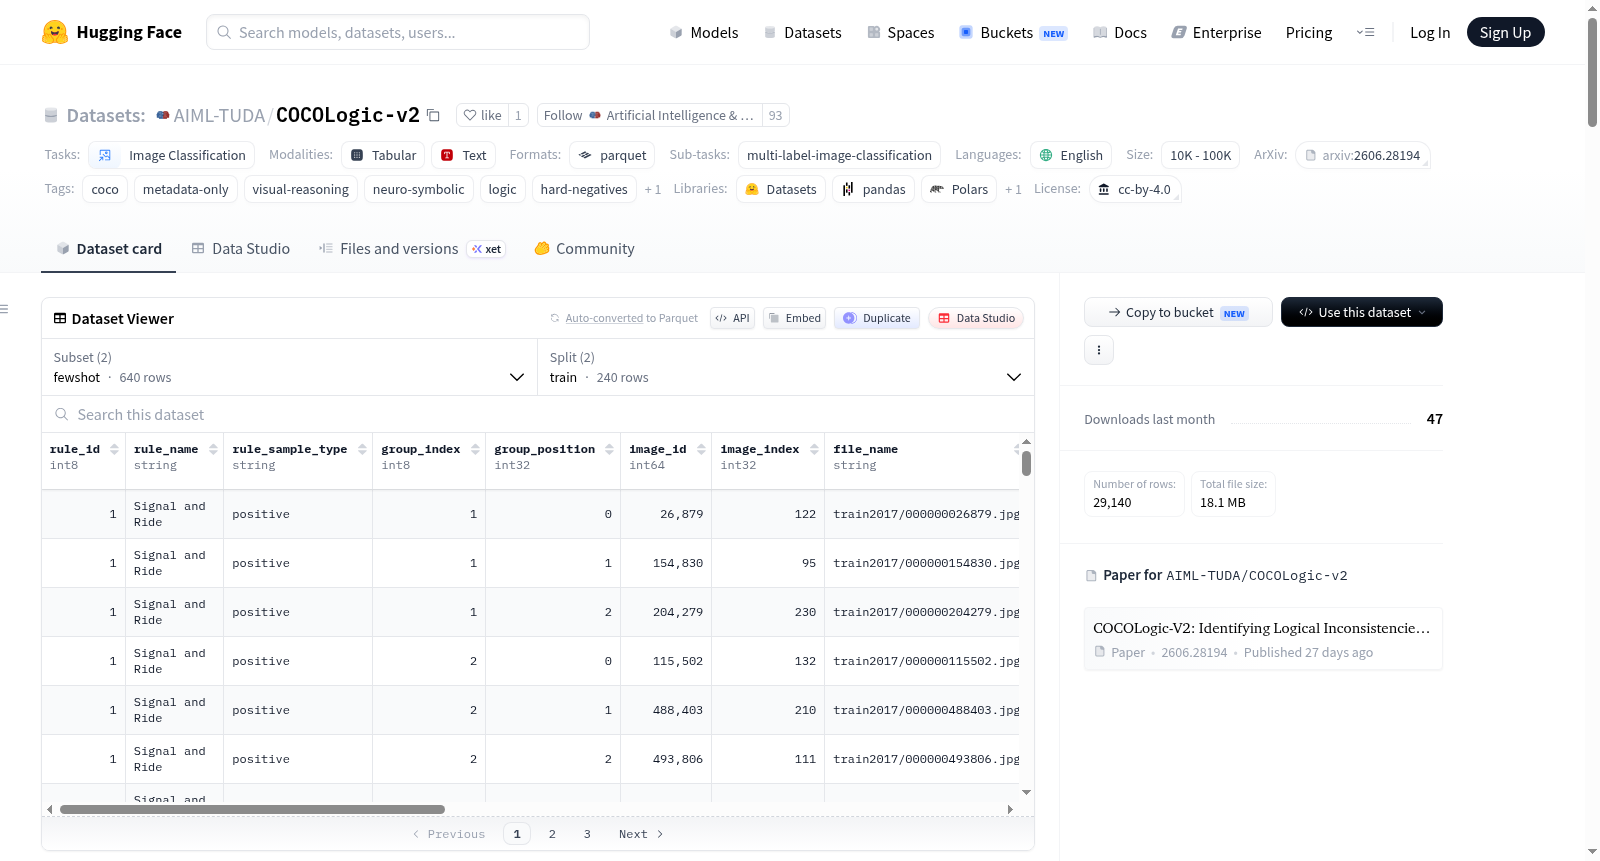
COCOLogic-V2 是一个面向对象的视觉归纳推理数据集,基于真实世界图像构建。它以MSCOCO数据集为基础,将推理任务构建为一个多标签分类问题,涉及10个组合性的一阶逻辑规则(包括对象存在/缺失、计数和计数比较)。每个规则的样本被分为不同的**正样本变体**、**近边界负样本**类型以及通常较简单的**远边界负样本**。这些注释能够为模型可解释性提供自动化洞察:揭示模型是否真正学习了逻辑规则,还是仅仅利用了粗糙的统计捷径。

COCOLogic-V2 is an object-centric dataset for visual inductive reasoning on real-world images. Built on MSCOCO, it frames reasoning as a multilabel classification task over 10 compositional first-order-logic rules (object presence/absence, counting, and count comparisons). Samples of each rule are divided into different positive variants, as well as types of near-boundary (NB) negatives, and the typically easy far-from-boundary (FB) negatives. These annotations enable automated insights for model accountability: they reveal whether a model has actually learned a logical rule or is merely exploiting coarse statistical shortcuts.
提供机构:
AIML-TUDA
搜集汇总
数据集介绍
AIML-TUDA/COCOLogic-v2 数据集图片
构建方式
COCOLogic-V2是一个基于MSCOCO真实世界图像构建的面向对象的视觉归纳推理数据集。它将推理任务形式化为一个多标签分类问题,涵盖10条一阶逻辑规则,涉及对象存在性、计数及数量比较。数据集为每条规则精心设计了不同的正例变体与近边界负例,后者通过翻转合取范式中的单个文字或调整目标计数生成,以严格测试模型是否真正理解了逻辑规则。远边界负例则从MSCOCO剩余图像中随机抽取,以保持整体数据分布与原始数据集相近。
特点
该数据集的核心特色在于其精细的样本分类体系。每张图像针对每条规则被标记为正例、近边界负例或远边界负例,其中近边界负例作为极具挑战性的困难负样本,能有效揭示模型是否只是利用了粗略的统计捷径而非真正的逻辑推理。此外,数据集还提供了完整的对象类别计数、对象名称等信息,并设计了全量和少样本两种配置,后者特别适用于上下文学习场景,每个规则均包含平衡的正负样本。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,它仅包含元数据注释,需自行下载MSCOCO 2017图像并通过file_name字段进行关联。全量配置以图像为单位,提供每张图像对10条规则的标签及样本类型;少样本配置则以规则-图像对为单位,每行包含特定规则的标签及元数据,便于直接过滤出单个规则的训练测试集。数据以parquet格式存储,用户可方便地利用PIL等库加载图像并读取对应的标注信息。
背景与挑战
背景概述
在计算机视觉领域,尽管深度神经网络在图像分类等任务上取得了显著成就,但其是否真正掌握了可泛化的逻辑规则,抑或仅仅是利用了数据集中的统计捷径,一直是研究焦点。为深入探究这一问题,来自德国达姆施塔特工业大学的研究团队于2026年发布了COCOLogic-V2数据集。该数据集以MSCOCO为基础,将视觉归纳推理形式化为一个包含10条一阶逻辑规则的多标签分类任务,涵盖对象存在性、计数及数量比较。其核心研究问题在于如何区分模型是真正习得了逻辑规则,还是仅在利用表面相关性。COCOLogic-V2通过引入基于规则的变体与近边界负样本,为模型可解释性评估提供了系统性工具,对神经符号学习与视觉推理领域产生了重要影响。
当前挑战
COCOLogic-V2所解决的领域核心挑战在于传统图像分类任务无法评估模型是否具备真正的逻辑推理能力,模型往往依赖粗粒度的统计特征而非规则理解进行预测。为此,数据集设计了三类难度递进的样本:正变体、近边界负样本与远边界负样本,其中近边界负样本通过对逻辑规则逐字翻转或改变计数条件生成,构成评估模型规则理解的关键探针。在构建过程中,研究团队面临如何从MSCOCO真实场景中系统性地挖掘符合复杂逻辑条件的样本,以及如何确保标签的精确性与一致性等挑战。此外,每个规则的变体数量不均衡(例如规则8有4种变体),且部分负样本类型在真实图像中难以自然出现,需通过精心构造的图像筛选与标注流程来保证数据集的科学性与完整性。
常用场景
经典使用场景
COCOLogic-V2数据集的核心应用场景在于视觉归纳推理能力的评估与训练,它基于MSCOCO真实图像,将逻辑推理任务精妙地转化为多标签分类问题。数据集涵盖10条一阶逻辑规则,涉及目标存在性、计数及数量比较等基础逻辑运算,通过精心设计的正样本变体、近边界负样本与远边界负样本,为研究者提供了剖析模型是否真正习得逻辑规则,而非依赖统计捷径的独特视角。这种结构化的样本分类机制,使之成为验证神经符号系统、评估视觉语言模型推理能力的标杆性基准。
解决学术问题
该数据集直击当前视觉推理研究中的核心困境——模型可解释性与逻辑一致性的双重缺失。传统视觉分类基准往往允许模型借助数据分布中的虚假相关性达成高准确率,却无法反映其对规则的真实理解。COCOLogic-V2通过引入近边界负样本这一精巧设计,能够精准识别模型是否在逻辑决策边界附近做出错误泛化,从而揭示了模型推理中的系统性缺陷。这一贡献为学术界提供了评估模型逻辑鲁棒性的可靠工具,推动了从单纯追求精度向重视推理可靠性的范式转变。
衍生相关工作
COCOLogic-V2的提出催生了一系列围绕视觉逻辑推理与神经符号系统的创新研究工作。首先,该数据集为开发硬负样本挖掘算法提供了标准化基准,推动了对比学习与逻辑约束融合方向的发展。其次,其近边界样本的设计理念被后续工作采纳,用于构建更细粒度的模型故障分析工具。此外,基于其规则化标注框架,研究者衍生出面向组合逻辑推理的元学习方法和符号-神经网络联合训练策略,这些工作共同构建了从逻辑规则到视觉感知的桥梁,拓展了可解释人工智能的边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

