
MathArena/brokenarxiv-training
收藏官方服务:
资源简介:
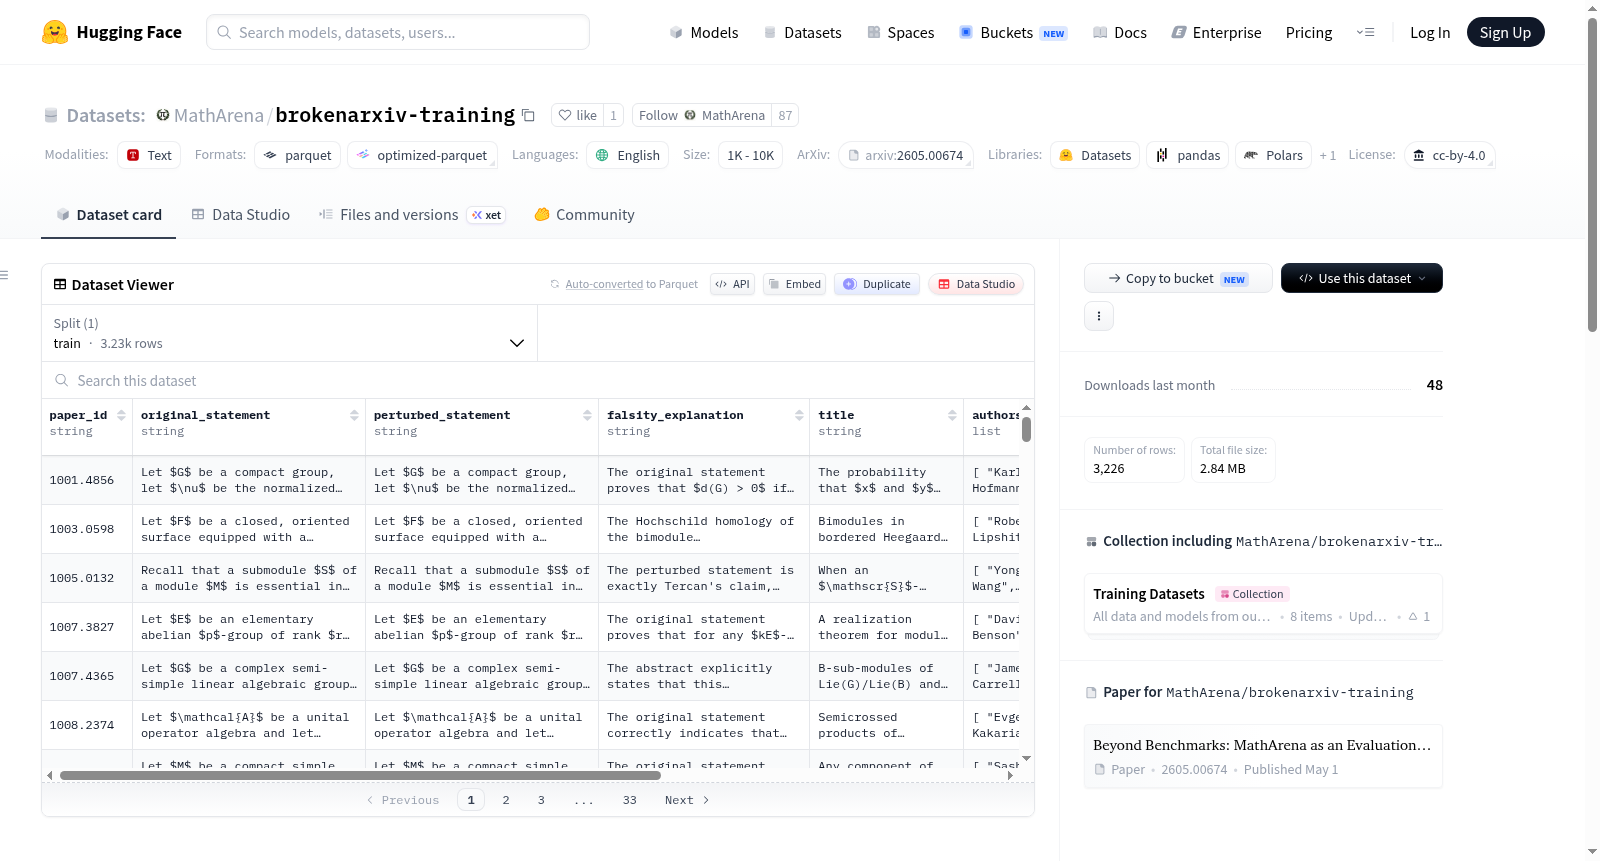
该数据集包含基于BrokenArXiv管道从过去ArXiv文章生成的训练数据,可用于训练研究级数学问题的模型。数据集的许可证为cc-by-4.0,但每行数据根据源文章可能有不同的许可证,下游用户应尊重这些许可证。
This dataset contains training data generated from past ArXiv articles, based on our BrokenArXiv pipeline. They can be used to train models on research-level mathematical problems. The license of the dataset is cc-by-4.0, but each individual row has a different license depending on the source article, which should be respected by downstream users.
提供机构:
MathArena搜集汇总
数据集介绍
构建方式
BrokenArXiv-Training数据集源自于arXiv上发表的数学研究论文,通过一套系统化的数据管道构建而成。研究团队从海量学术文献中提取原始问题陈述,随后借助大语言模型对这些陈述进行受控扰动,生成逻辑上必然为假的变体,并同步提供由模型生成的错误原因解释。每一数据条目均保留来源论文的元数据,包括论文ID、标题、作者、类别及原始许可协议,确保数据溯源清晰且合规。
特点
该数据集的核心特色在于其聚焦于研究级数学问题的真值对立性构建,即每个扰动语句均为原始正确命题的明确反例。这种设计使模型能够同时学习问题表达及其逻辑谬误,从而提升对数学命题真值判断的敏感度。此外,数据集高度尊重学术作品的原始许可,每一条目均附独立许可信息,要求下游用户在使用时严格遵循各自的版权条款,体现了对学术伦理的郑重考量。
使用方法
使用者可通过HuggingFace Datasets库轻松加载该数据集,仅需指定配置名称'default'与训练集划分即可获取完整数据。每一行包含原始语句、扰动语句及谬误解释,可广泛应用于大语言模型的数学推理训练、对抗性样本生成或真值判别能力的微调。使用时务必注意逐条检查数据来源论文的许可条款,特别在商业或再分发场景中,需遵照CC-BY 4.0框架内各原始版权的具体限制。
背景与挑战
背景概述
在数学推理与自然语言处理的交叉领域,大语言模型(LLM)在解决复杂数学问题上的能力评估一直是研究热点。为突破传统静态基准的局限,苏黎世联邦理工学院(ETH Zurich)的研究团队于2026年发布了BrokenArXiv-Training数据集,作为MathArena评估平台的核心组件。该数据集由Jasper Dekoninck、Nikola Jovanović等人构建,旨在从海量ArXiv学术论文中提取原始数学问题陈述,并通过精心设计的扰动生成可验证的错误变体,从而为训练具备严谨数学鉴别能力的模型提供高质量数据。数据集涵盖3226个训练样本,每条记录包含原始陈述、扰动后错误陈述及错误原因解释,并保留了论文元数据以尊重不同来源的许可证要求。这一资源有效填补了研究级数学问题训练数据的空白,推动了LLM在形式化数学推理领域的应用。
当前挑战
该数据集所应对的核心挑战在于解决当前大语言模型在处理研究级数学问题时的虚假事实生成(hallucination)难题。传统数学基准如GSM8K或MATH多局限于初等或竞赛级别,而ArXiv论文中的高等数学问题往往包含复杂符号推理与多步证明,这对模型的事实一致性提出了更高要求。在构建过程中,研究者面临双重挑战:其一,如何从非结构化的学术文本中准确提取并形式化原始数学命题,确保声明具备可验证的真值;其二,设计扰动策略以生成“看似合理但本质错误”的陈述,同时保持数学语言的严谨性,这需要领域专家与自动验证工具的协同。此外,不同ArXiv文章采用多样的许可协议,使得数据合规性管理成为分布式知识整合的又一难题。
常用场景
经典使用场景
在数学推理与自然语言处理的交叉领域,BrokenArXiv-Training数据集为研究者提供了一种新颖的范式:通过对比原始数学命题与经扰动后生成的错误命题,训练模型精准识别数学陈述的真伪。该数据集的核心价值在于,它不仅包含了从ArXiv论文中提取的高难度数学问题,还通过精心设计的扰动机制构建了具有对抗性的负样本,从而迫使模型深入理解数学逻辑的严密性而非表面模式。经典的使用方式是将原始陈述与扰动陈述作为正负样本对,用于训练二元分类器或强化基于对比学习的数学推理模型,尤其适用于评估和提升大型语言模型在科研级数学问题上的判别能力。
解决学术问题
该数据集直击当前大型语言模型在数学推理中面临的“虚假自信”与“模式匹配”困境——模型往往能产出看似合理的推导,却无法辨别微妙的逻辑谬误。通过提供配对的真实-错误数学陈述以及专家级错误解释,该资源解决了两个关键学术问题:其一,如何系统性地生成高质量的反事实数学样本以进行鲁棒性训练;其二,如何量化模型对数学陈述真值的理解程度。其意义在于,推动了数学推理评估从简单的答案正确性向深度逻辑一致性迈进,为构建真正具备数学洞察力的AI系统奠定了数据基础,并对可解释AI领域关于错误追溯的研究产生了深远影响。
衍生相关工作
围绕BrokenArXiv-Training数据集的构建思想,学术界已涌现出一系列衍生工作。其中最突出的包括:基于该数据提出的“数学陈述对抗训练”框架,促使研究者开发了多种扰动策略(如变量替换、条件弱化、定义扭曲)以生成更逼真的错误命题;同时催生了专门用于数学错误定位的细粒度归因模型。此外,该数据集不仅被直接用于训练,还作为基准催生了多项关于大型语言模型数学鲁棒性的系统评估,并启发了几何、代数等不同数学子领域的类似对抗性数据集构建流程。值得注意的是,其背后的MathArena评估平台也因该数据的引入而扩展了从“解题”到“证伪”的评价维度,形成了更加全面的数学能力测试体系。
以上内容由遇见数据集搜集并总结生成


