
遇见数据集

TTS-AGI/ears-corrupted-dramabox-roundtrip

收藏
Hugging Face2026-06-20 更新2026-07-22 收录
官方服务:

资源简介:

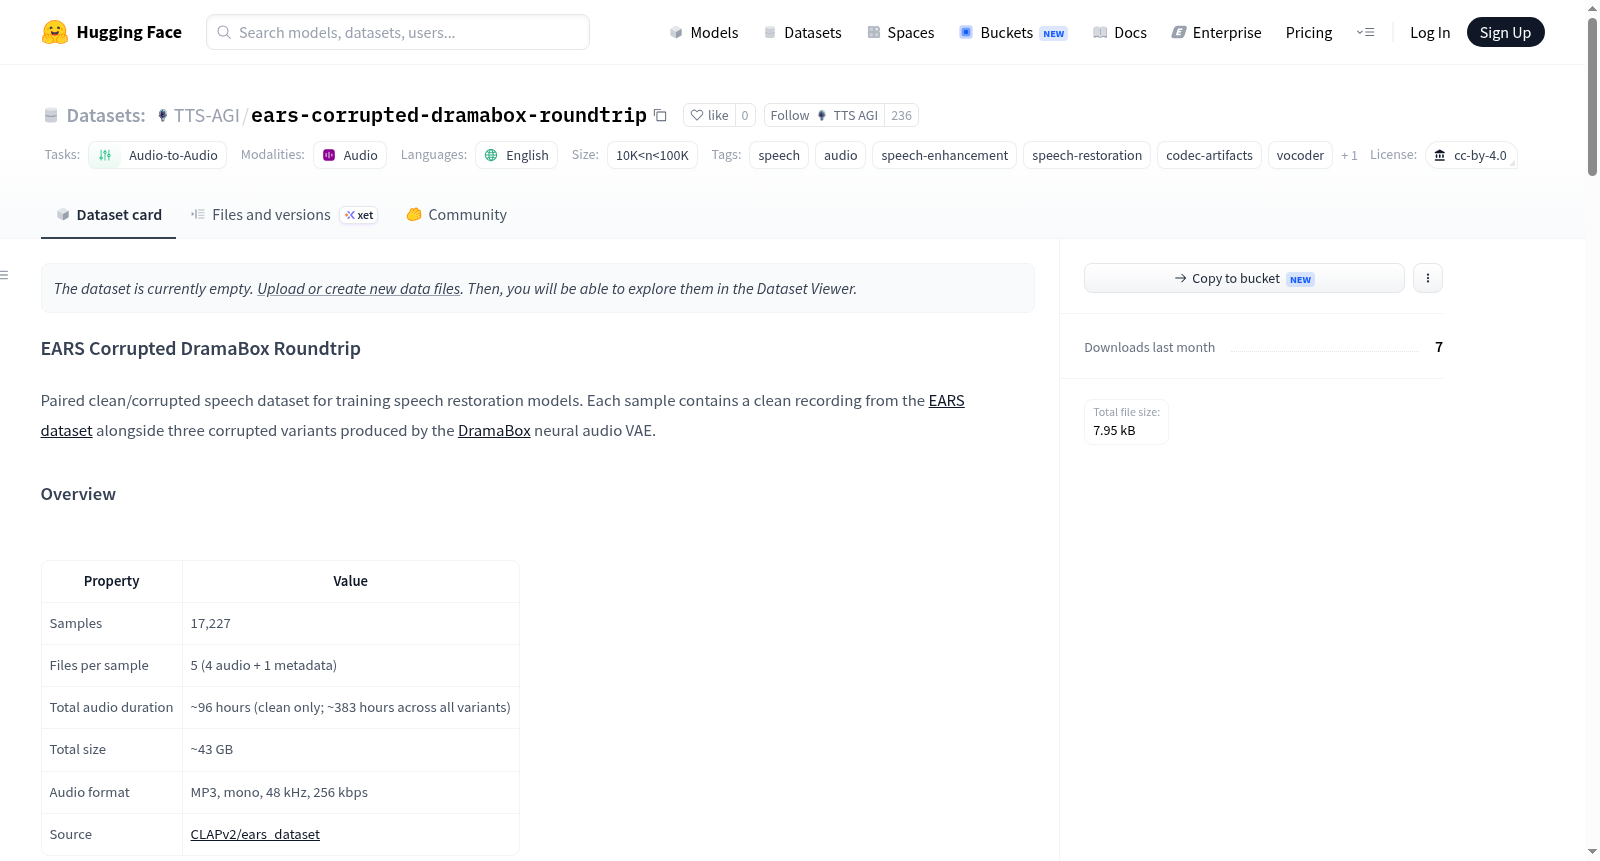
EARS Corrupted DramaBox Roundtrip 是一个用于训练语音恢复模型的配对干净/腐败语音数据集。每个样本包含来自EARS数据集的干净录音,以及由DramaBox神经音频VAE生成的三种腐败变体。数据集包括17,227个样本,每个样本有4个音频文件(干净录音、标准VAE往返、噪声潜在往返和增强输入往返)和1个元数据文件,总音频时长约96小时(仅干净录音)或约383小时(所有变体),总大小约43 GB,音频格式为MP3、单声道、48 kHz、256 kbps。腐败变体模拟了神经编解码器伪影、潜在空间噪声和DSP增强效果,用于训练Sidon语音恢复声码器以去除DramaBox伪影并保持语音质量。

Paired clean/corrupted speech dataset for training speech restoration models. Each sample contains a clean recording from the EARS dataset alongside three corrupted variants produced by the DramaBox neural audio VAE. The dataset includes 17,227 samples, each with 4 audio files (clean, roundtrip, noisy roundtrip, augmented roundtrip) and 1 metadata file, total audio duration ~96 hours (clean only) or ~383 hours (across all variants), total size ~43 GB, audio format MP3, mono, 48 kHz, 256 kbps. The corruption variants simulate neural codec artifacts, latent space noise, and DSP augmentation effects, used to train the Sidon speech restoration vocoder for removing DramaBox artifacts while preserving speech quality.
提供机构:
TTS-AGI
搜集汇总
数据集介绍
TTS-AGI/ears-corrupted-dramabox-roundtrip 数据集图片
构建方式
该数据集基于TTS-AGI团队开发的脚本,以流式方式从HuggingFace加载CLAPv2/ears_dataset原始语音,避免内存溢出。采用生产者-消费者架构,由单线程喂料至多进程队列,8块GPU并行处理。每块GPU加载DramaBox神经音频VAE的编码器和解码器,对音频进行16kHz重采样、立体声复制后编码为潜变量,再解码恢复至48kHz生成标准往返音频;在潜变量中各通道注入高斯噪声(幅度为通道标准差0.1%至5%)产生噪声往返音频;对原始音频施加梳状滤波、失真或两者组合的数字信号处理效果后,再经VAE往返生成增强往返音频。所有音频最终以48kHz、256kbps的MP3格式保存。
特点
数据集包含17,227个样本,每个样本由一段干净语音和三段不同损坏变体组成,总音频时长约96小时(干净语音),各类变体合计约383小时。三种损坏变体各具特征:标准往返引入神经编解码伪影,如频谱平滑、金属质感偏移和瞬态模糊;噪声往返模拟潜变量传输误差或量化噪声;增强往返叠加DSP与编解码复合伪影。元数据文件详细记录样本标识、转录文本、采样率、时长、噪声幅度及增强类型,便于研究者按需筛选和统计分析。
使用方法
可通过HuggingFace的datasets库直接加载数据集:from datasets import load_dataset; ds = load_dataset("TTS-AGI/ears-corrupted-dramabox-roundtrip")。亦支持从磁盘读取单条音频,如使用torchaudio加载clean.mp3和roundtrip.mp3。该数据集专为训练语音恢复模型设计,典型应用于Sidon语音恢复声码器,旨在消除DramaBox神经编解码伪影的同时保留语音质量。研究者可依据元数据中的损坏类型、噪声幅度等字段构建自定义训练或测试子集,评估不同降质条件下的恢复性能。
背景与挑战
背景概述
在语音处理领域,神经音频编解码器(如DramaBox)因其高效的压缩能力而备受关注,但引入的伪影严重影响了语音自然度与保真度。在此背景下,TTS-AGI团队于2025年基于EARS数据集构建了本数据集,旨在为语音修复模型提供配对的干净与受损语音样本。该数据集由17,227个样本组成,总计约96小时的干净语音,并衍生出三种基于DramaBox变分自编码器的受损变体,覆盖标准编解码伪影、潜在空间噪声及复合失真。作为Sidon语音修复声码器的训练基石,该数据集在推动神经编解码伪影消除与语音质量提升方面具有里程碑意义。
当前挑战
该数据集的核心挑战在于解决神经编解码器导致的多重声学退化问题,包括频谱平滑导致的细节丢失、金属感音色偏移以及瞬态模糊,这些退化不同于传统噪声或混响,难以通过现有增强模型泛化。构建过程中面临双重困难:一是需要在高计算开销下并行处理大量长语音(最长达208.7秒),通过生产者-消费者架构与8个GPU工作节点实现流式生成;二是精确控制三种受损变体的参数空间,如潜在噪声比例需在0.1%至5%之间均匀采样,同时确保DSP增强(梳状滤波、失真)与编解码伪影的复合效应具有代表性,避免数据分布偏差影响模型鲁棒性。
常用场景
经典使用场景
在语音通信与生成领域,神经编解码器虽能高效压缩语音信号,却不可避免地引入频谱平滑、金属音色偏移及瞬态模糊等伪影。EARS Corrupted DramaBox Roundtrip数据集为此提供了绝佳的基准平台,其核心使用场景在于配对干净与受损语音样本,用以训练语音修复模型,尤其是消除DramaBox等神经音频VAE产生的编解码伪影。每一组样本均包含原始录音及其经标准VAE往返、潜在空间加噪往返以及前置增强往返后的三种退化变体,为模型学习从复杂退化中恢复纯净语音提供了多样性极强的训练素材。该数据集共涵盖17,227组样本,总时长约96小时,规模涵盖10K至100K量级,充分满足深度学习模型对数据量与多样性的双重需求。
解决学术问题
该数据集精准回应了语音修复领域长期面临的学术难题:如何鲁棒地消除神经音频编解码器产生的结构化伪影。经典语音增强方法多针对加性噪声或混响,而编解码伪影具有非线性、频域相关且与信号内容耦合的特性,传统方法往往难以奏效。EARS Corrupted DramaBox Roundtrip通过系统性地构造三种退化类型——标准编解码失真、潜在空间噪声干扰以及复合信号处理增强,复刻了实际传输与重建链路中的多种退化模式。研究者可利用这些配对数据探索伪影感知机制、频域重建损失函数设计以及隐空间正则化策略,推动语音修复从简单去噪向深度伪影移除方向演进。数据集的公开与标准化进一步降低了研究门槛,加速了该方向学术成果的可复现与对比。
衍生相关工作
该数据集直接催生并支撑了Sidon语音修复声码器的开发与训练,Sidon专门设计用于去除DramaBox等神经编解码器的伪影,其核心思想是通过隐空间引导与生成式后处理实现高质量重建。基于此类配对数据,研究者进一步衍生出多项经典工作,包括探索基于扩散模型的语音增强方法,利用编解码伪影的结构特性作为条件信号引导生成过程;以及将对抗训练引入伪影移除框架,通过判别器感知伪影分布以提升修复结果的逼真度。此外,该数据集也为编解码伪影的感知评价研究提供了标准化测试床,推动了客观感知指标(如PESQ、STOI)对神经伪影敏感性分析的完善。在语音表示学习领域,相关工作利用此类数据探索自监督预训练模型对编解码退化的鲁棒表征提取能力,形成了从数据构建到模型评估的完整研究闭环。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

