
mzio/aprm-sft_genthinkact-Einsurance_default-G1-S1-Rinsurance_aprm_1_mc-ap1_best-train_all-b099
收藏数据链接:
官方服务:
资源简介:
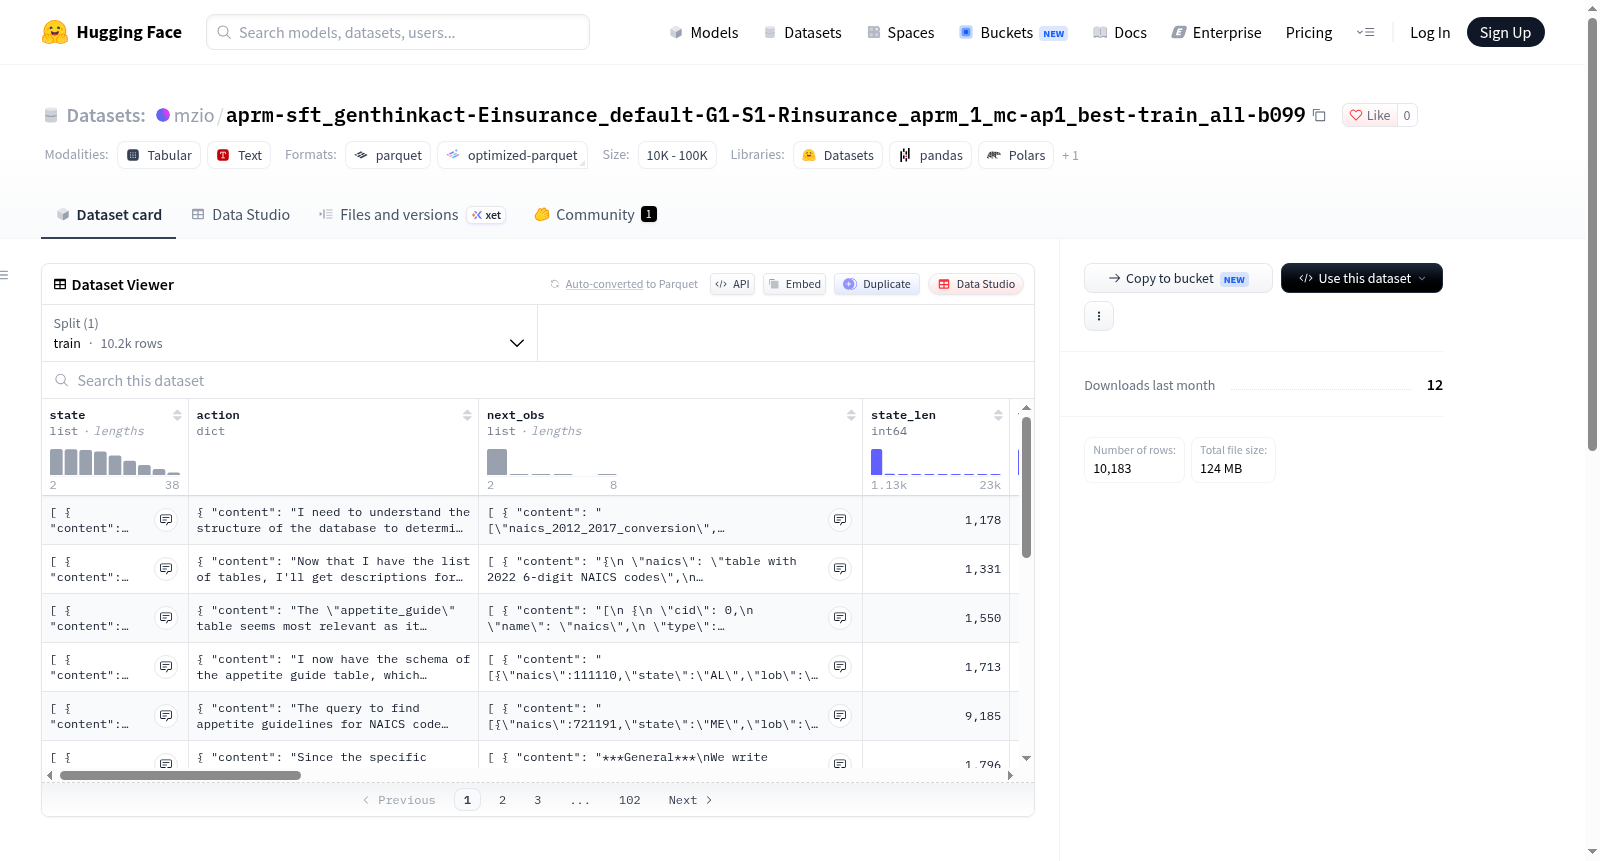
这是一个基于Act-PRM(动作-过程奖励模型)的滚动数据集,用于保险领域。数据集包含10183条轨迹,每条轨迹对应一个episode,使用Qwen3 4B模型生成。轨迹键为think_act_policy,数据来自训练集(train_all)。
This is a rollout dataset based on Act-PRM (Action-Process Reward Model), used in the insurance domain. The dataset contains 10,183 trajectories, each corresponding to an episode, generated using the Qwen3 4B model. The trajectory key is think_act_policy, and the data comes from the training set (train_all).
提供机构:
mzio搜集汇总
数据集介绍
构建方式
在强化学习与过程奖励模型(PRM)日益融合的背景下,该数据集通过自动化轨迹采样与过滤机制构建而成。基于配置为“act-prm-v2”的运行时环境,利用Qwen3-4B指令模型作为策略生成器,在保险场景(insurance_default)中执行“思考-行动”策略,并借助过程奖励模型(aprm_qwen3_ap)对每一步推理与动作进行评分。采样过程采用批量大小为16、组大小为1的设置,最大序列长度4096,共收集10183条轨迹,每条轨迹对应一个完整的情节,最终形成面向监督微调(SFT)的高质量训练集。
使用方法
该数据集适用于监督微调(SFT)场景,尤其面向基于过程奖励模型增强的策略学习任务。使用者可通过标准的序列到序列训练框架加载数据,将“思考-行动”轨迹作为目标输出,并结合动作掩码与观测隐藏等配置进行高效训练。典型用法包括:以Qwen3-4B等指令模型为基座,采用LoRA(r=8, alpha=16)进行参数高效微调,批量大小设为16,学习率4e-5,最大序列长度4096,并可启用梯度检查点与均值中心化等优化策略。训练过程中可依据验证集表现调整超参数,以提升模型在保险决策任务中的逐步推理与行动生成能力。
背景与挑战
背景概述
随着大规模语言模型在复杂决策任务中的广泛应用,如何通过过程奖励建模(Process Reward Modeling, PRM)提升模型在交互式环境中的推理与行动能力,已成为强化学习与自然语言处理交叉领域的前沿议题。在此背景下,aprm-sft_genthinkact-Einsurance_default-G1-S1-Rinsurance_aprm_1_mc-ap1_best-train_all-b099数据集应运而生,由相关研究团队于近期构建,旨在为保险领域的智能决策任务提供高质量的轨迹级监督信号。该数据集聚焦于“思考-行动”策略的监督微调,通过采集万余条交互轨迹,系统性地探索过程奖励模型在真实业务场景中的训练范式,对推动可解释、可控制的智能体决策研究具有重要的实证价值与领域影响力。
当前挑战
该数据集所应对的核心领域问题在于复杂交互环境下稀疏奖励信号导致策略学习效率低下与行为不可解释的困境,其目标在于借助过程奖励建模为中间推理步骤提供细粒度监督,从而缓解信用分配难题。在构建过程中,主要挑战包括:保险领域状态空间庞大且动作语义复杂,高质量轨迹采集对专家知识与环境交互成本要求极高;轨迹数据中“思考”与“行动”的耦合关系需精细标注,以保证监督信号的因果一致性;此外,如何在大规模语言模型微调中平衡过程奖励与最终任务回报,避免策略退化或过拟合,亦是构建者需持续应对的技术难点。
常用场景
经典使用场景
在强化学习与智能体决策的研究中,该数据集作为过程奖励模型(PRM)的监督微调资源,经典使用场景聚焦于训练智能体在保险场景下生成分步推理动作的能力。具体而言,数据集包含逾万条轨迹,每条轨迹记录了策略在特定状态下产生的思考与动作序列,并配以过程奖励信号。研究者通常将其用于训练基于LoRA微调的Qwen3-4B模型,使其学会在复杂交互中依据环境反馈优化决策步骤,从而提升智能体在长程任务中的规划与执行效能。这一场景体现了过程奖励建模在序列决策中的核心价值,即通过细粒度奖励引导策略逐步逼近最优行为。
解决学术问题
该数据集着力解决强化学习中学者长期面临的稀疏奖励与信用分配难题。在传统方法中,仅依赖最终结果奖励难以有效指导多步决策,导致智能体学习效率低下。此数据集通过提供过程奖励信号,使模型能够评估中间步骤的优劣,从而缓解奖励稀疏性并改善信用分配。其学术意义在于,为过程奖励模型在复杂环境中的有效性提供了实证支持,推动了从结果监督向过程监督的范式转变。同时,该数据集也为研究离线强化学习、模仿学习与奖励建模的交叉问题提供了标准化基准,促进了可复现研究与算法比较。
实际应用
在实际应用中,该数据集可赋能保险领域的智能客服与自动化理赔系统。通过训练过程奖励模型,智能体能够在与用户的多轮对话中,逐步推理并执行信息收集、风险评估与方案推荐等动作,提升服务效率与准确性。此外,该数据集所采用的技术框架可迁移至金融、医疗等需要多步推理与合规决策的行业,辅助构建可信赖的智能决策系统。其实际价值还体现在降低人工干预成本,通过自动化流程处理标准化请求,同时保留过程可解释性,便于审计与优化。
数据集最近研究
最新研究方向
在强化学习与过程奖励模型(PRM)交叉领域,基于Act-PRM的保险场景决策优化正成为前沿探索方向。该数据集通过轨迹级“思考-行动”策略(think_act_policy)与分组规模1的批量采样,构建了涵盖10183条专家轨迹的精细化监督信号,旨在缓解稀疏奖励下策略信用分配难题。其关联热点在于利用过程奖励模型对多步推理与动作序列进行中间步骤评分,从而提升智能体在保险默认预测等高风险场景中的可解释性与鲁棒性。该研究意义在于推动奖励建模从结果导向转向过程感知,为复杂决策任务提供可复现的基准数据,并启发基于分组采样的策略梯度优化新范式。
以上内容由遇见数据集搜集并总结生成


