nanoJEPA-base
收藏资源简介:
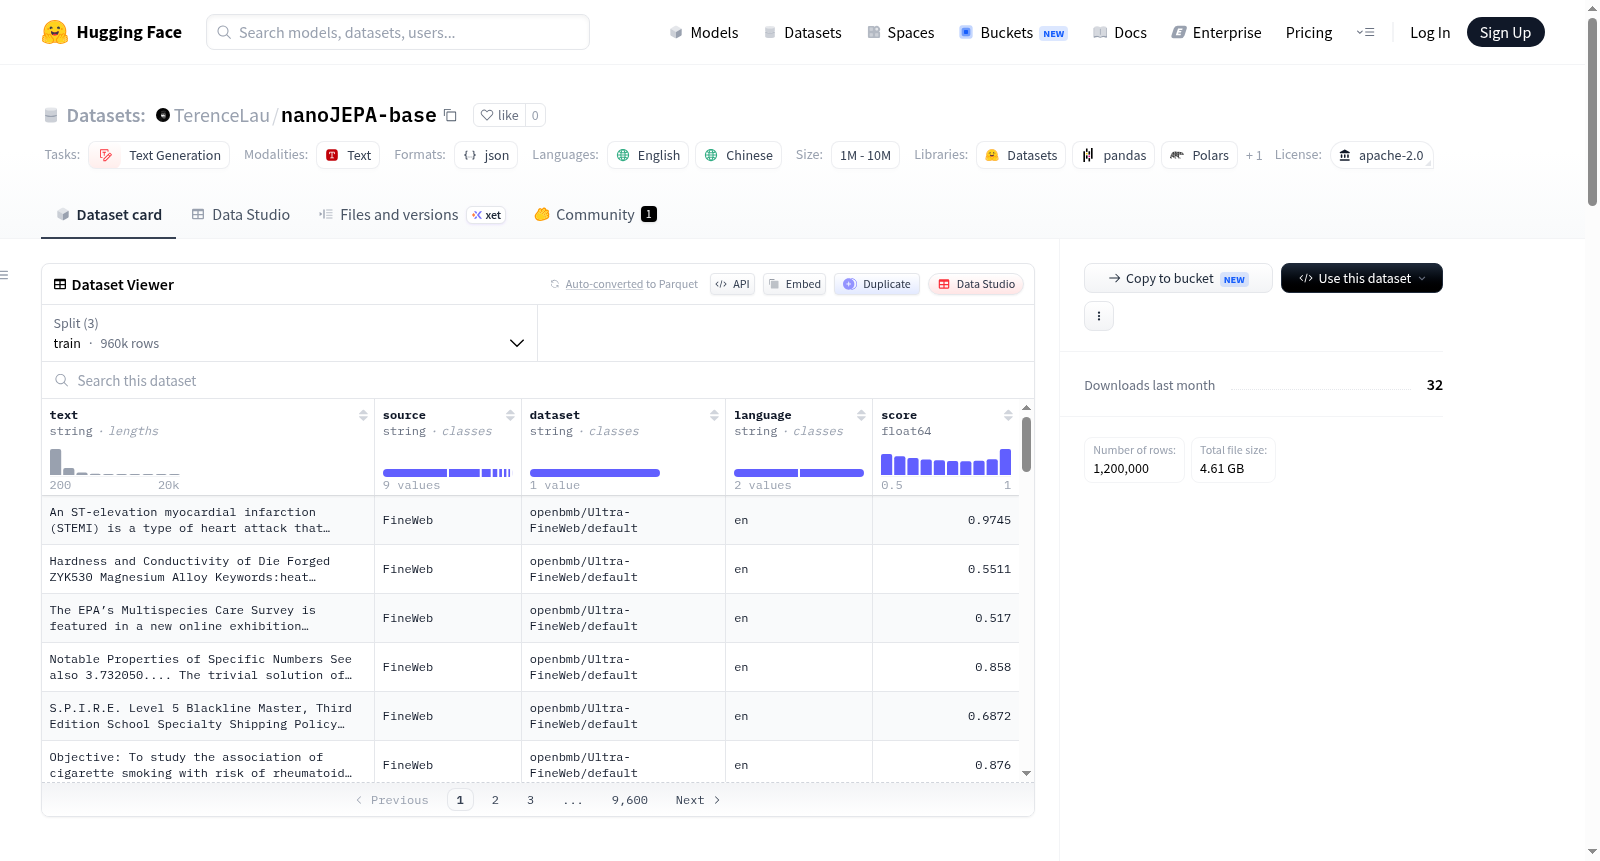
nanoJEPA EN/ZH Ultra-FineWeb 数据集是一个专为 nanoJEPA 模型设计的小规模预训练数据集。它通过流式处理 openbmb/Ultra-FineWeb 数据集中的英文(en)和中文(zh)分片构建而成,旨在为语言模型的预训练提供高质量的双语文本资源。数据集包含三个标准分割:训练集(train)、验证集(valid)和测试集(test),每个分割均以 JSONL 格式存储,每条记录包含文本内容(text)、数据来源(source)、原始数据集名称(dataset)、语言标识(language,取值为 en 或 zh)以及质量评分(score)等字段。数据规模方面,训练集包含 960,000 条样本(英文和中文各 480,000 条),验证集包含 60,000 条样本(中英文各 30,000 条),测试集包含 180,000 条样本(中英文各 90,000 条)。该数据集适用于文本生成任务的预训练,特别是需要中英文双语能力的语言模型开发。数据集的构建过程通过指定脚本完成,支持自定义语言选择、各语言最大样本数以及训练/验证/测试集的比例划分。
The nanoJEPA EN/ZH Ultra-FineWeb dataset is a small-scale pre-training dataset specifically designed for the nanoJEPA model. It is constructed by streaming the English (en) and Chinese (zh) shards from the openbmb/Ultra-FineWeb dataset, aiming to provide high-quality bilingual text resources for language model pre-training. The dataset includes three standard splits: training set (train), validation set (valid), and test set (test), each stored in JSONL format. Each record contains fields such as text content (text), data source (source), original dataset name (dataset), language identifier (language, with values en or zh), and quality score (score). In terms of data scale, the training set contains 960,000 samples (480,000 each for English and Chinese), the validation set contains 60,000 samples (30,000 each for English and Chinese), and the test set contains 180,000 samples (90,000 each for English and Chinese). This dataset is suitable for pre-training in text generation tasks, particularly for developing language models with bilingual capabilities in English and Chinese. The construction process is completed through specified scripts, supporting custom language selection, maximum sample counts per language, and the proportional division of training/validation/test sets.
nanoJEPA EN/ZH Ultra-FineWeb 数据集
数据集概述
本数据集是专为 nanoJEPA 模型设计的轻量级预训练数据集,基于 openbmb/Ultra-FineWeb 数据集构建,包含英文(en)和中文(zh)两种语言。
数据集信息
- 许可证:Apache-2.0
- 任务类别:文本生成
- 语言:英语、中文
- 数据集名称:nanoJEPA EN/ZH Ultra-FineWeb Dataset
文件结构
数据集包含三个 JSONL 格式文件,每个文件的 schema 如下:
train.jsonl:训练集valid.jsonl:验证集test.jsonl:测试集
每条记录包含字段:text(文本内容)、source(来源)、dataset(数据集名称)、language(语言,en 或 zh)、score(分数,默认为 0.0)
数据统计
| 数据子集 | 总行数 | 英文行数 | 中文行数 | 扫描行数 |
|---|---|---|---|---|
| train | 960,000 | 480,000 | 480,000 | 984,987 |
| valid | 60,000 | 30,000 | 30,000 | 61,790 |
| test | 180,000 | 90,000 | 90,000 | 185,045 |
- 数据集总量:1,200,000 行
- 数据源:
openbmb/Ultra-FineWeb(配置:default) - 随机种子:42
数据划分比例
- 训练集:80%
- 验证集:5%
- 测试集:15%