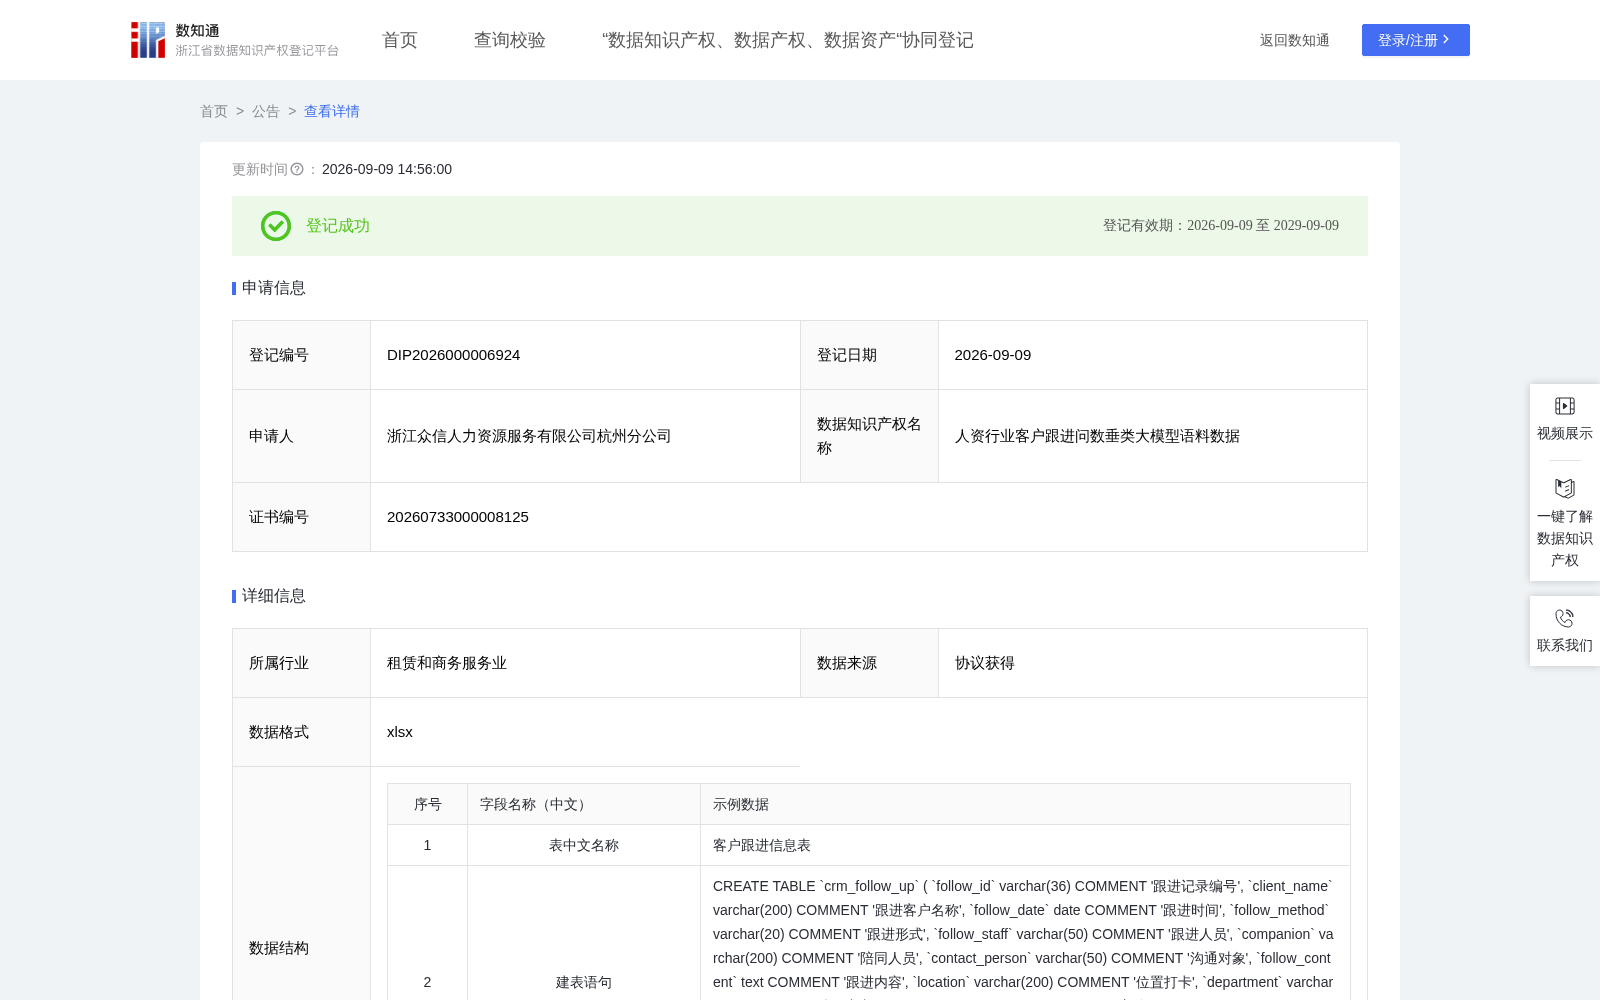
人资行业客户跟进问数垂类大模型语料数据
收藏资源简介:
本数据专为训练人力资源服务行业客户跟进分析领域垂类大语言模型而构建。当前人力资源服务企业客户跟进数据主要依赖人工汇总和报表统计,普通业务人员难以自主查询跟进信息。客户跟进记录分散在不同渠道和不同时期,跨维度对比分析需要多次汇总合并,效率低下。不同企业的客户跟进数据格式不统一、内容描述差异大,给跨企业客户跟进分析模型训练带来数据质量障碍。本数据采用Text-to-SQL技术路径,围绕客户跟进信息表设计多种典型查询场景,覆盖跟进频次查询、部门分布统计、业务关键词检索、客户覆盖分析、跟进形式分析、多条件组合筛选等场景,生成高质量的问题-SQL-结果三元组训练语料。企业可基于本语料数据的"指标名称""问题查询"等字段内容,适配自身数据表结构,快速启用文字转SQL功能复用。本数据产品作为稀缺的垂直领域语料,对推动人力资源服务行业客户跟进分析智能化发展提供了有力支撑。规则一:数据采集与预处理 原始数据来源于公司开展第三方人力资源服务过程中采集,涵盖线上联系、现场拜访、电话沟通等跟进形式。对跟进记录进行去重与有效性校验,剔除缺失、异常记录,数据有效率≥98%。统一时间格式与跟进形式命名规范,对企业名称及跟进对象进行脱敏处理,数据不含任何个人身份信息。 规则二:问数需求分类 围绕客户跟进管理核心业务,按跟进总量统计、维度筛选、频次分析、交叉组合查询、趋势分析、排名查询、占比计算、年度对比等场景分类,标注跟进形式与部门标签,覆盖客户跟进分析90%以上核心问数需求,构建基础问题集。 规则三:SQL编写与结果核验 基于"业务术语-字段名"映射规则编写标准SQL:简单问数采用预设SQL模板,多条件组合问数按字段间的业务关联关系编写条件筛选与聚合语句。SQL查询结果严格遵循"问一项答一项"原则,仅返回问题所询问的具体内容。每条SQL经数据库执行验证并与原始数据比对,删除执行结果不一致的语料,SQL正确率≥94%。由资深业务专家对问题-SQL-结果三元组进行最终核验,确保语义对齐、数值准确,结果核验正确率≥97%。 规则四:语料独立构建与迭代优化 本语料按"客户跟进"单一专题独立构建,刻意不与地域覆盖、业务模式等其他维度语料合并训练。原因在于:合并训练会使模型在客户跟进这一专题上的学习权重被稀释,削弱其对跟进形式、跟进频次、部门归属等核心语义的识别精度;而独立语料样本分布更纯粹、标注口径更统一,能显著提升模型在该场景下的专项理解与SQL生成准确率,便于按专题针对性迭代优化、独立交付,也更契合不同客户按需选购专项语料的市场化需求。同时建立"生成-校验-反馈-修正"闭环机制,错误样本归入修正队列,定期补充边缘问句与缺失场景,形成自进化的客户跟进问数语料体系。