EN-DE-MT
收藏资源简介:
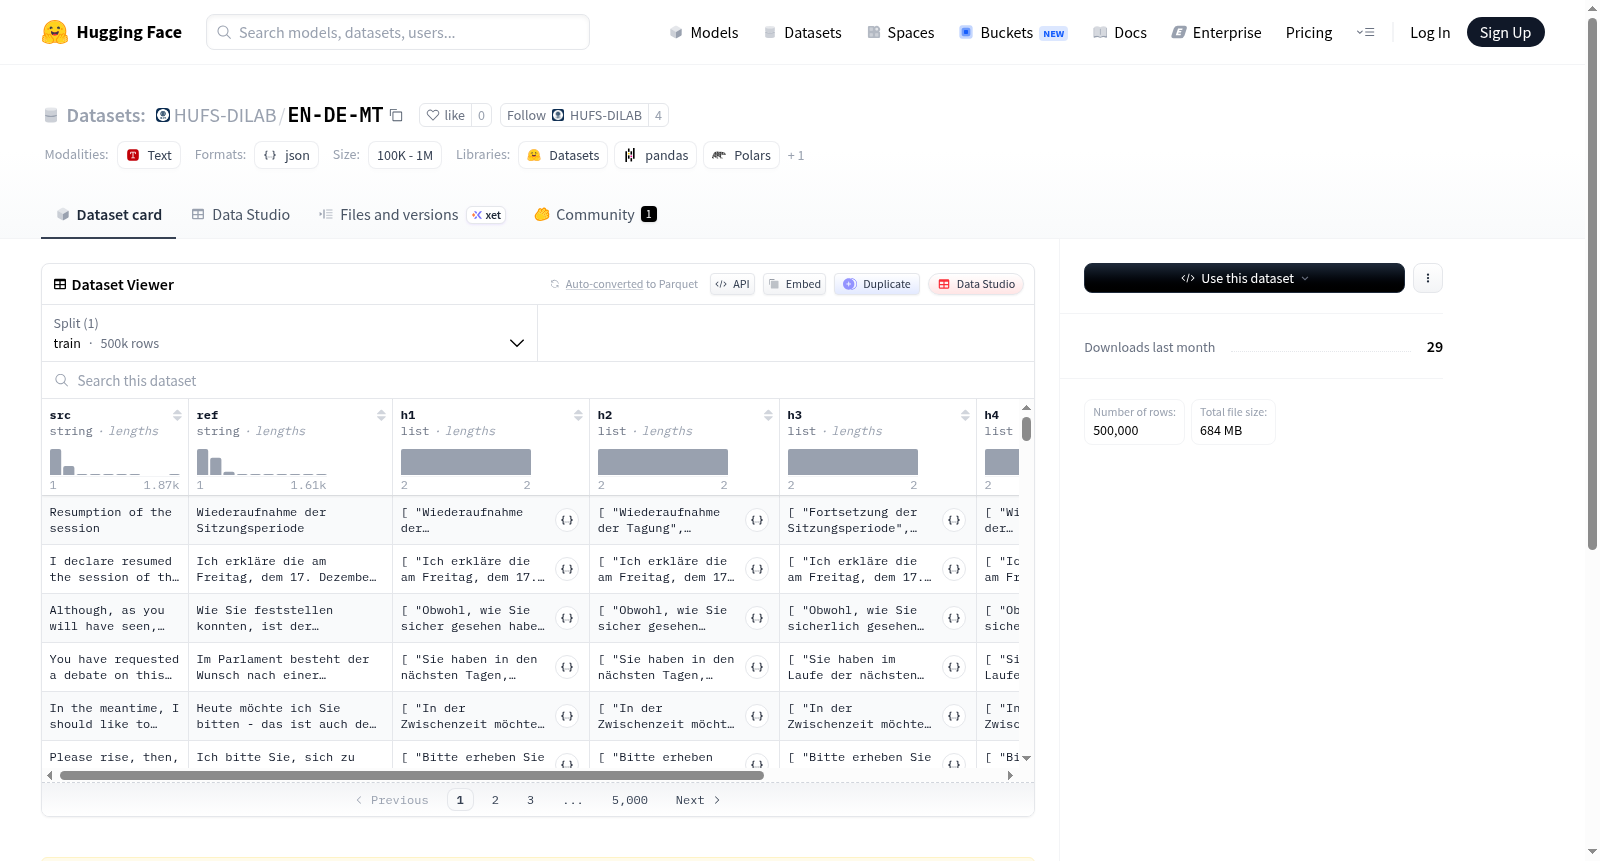
该数据集是WMT14(2014年机器翻译研讨会)英德翻译任务训练集的一个子集,包含50万句对。数据由Helsinki-NLP/opus-mt-en-de机器翻译模型生成,翻译方向为英语到德语,解码过程采用集束搜索(beam search),参数设置为num_beams=5和num_return_sequences=5。每个数据样本包含以下字段:src(英语源文本)、ref(原始人工参考译文),以及h1到h5(5个由模型生成的德语翻译候选,每个候选都附有其对数概率得分,并且列表已按得分降序排列)。该数据集适用于机器翻译模型训练、评估、重排序(reranking)或翻译质量估计等研究任务。
This dataset is a subset of the WMT14 (Workshop on Machine Translation 2014) English-German translation task training set, containing 500,000 sentence pairs. The data is generated by the Helsinki-NLP/opus-mt-en-de machine translation model in the direction from English to German, using beam search decoding with parameters set to num_beams=5 and num_return_sequences=5. Each data sample includes the following fields: src (English source text), ref (original human reference translation), and h1 to h5 (five model-generated German translation candidates, each accompanied by its log probability score, with the list sorted in descending order by score). The dataset is suitable for research tasks such as machine translation model training, evaluation, reranking, or translation quality estimation.
根据您提供的数据集详情页面内容,以下是该数据集的概述:
数据集概述
- 数据集名称:EN-DE-MT
- 提供机构:HUFS-DILAB
- 任务类型:机器翻译(English → German)
数据来源与构成
- 源文本(src):来自 WMT14 英语-德语数据集,使用训练集拆分,包含 500,000 个句子。
- 参考译文(ref):原始参考译文。
翻译候选与评分
- 候选译文:包含 5 个翻译候选(h1, h2, h3, h4, h5),每个候选附有对数概率分数,按降序排列。
模型与参数
- 翻译模型:Helsinki-NLP/opus-mt-en-de
- 翻译方向:英语 → 德语
- 束搜索配置:束宽(num_beams)= 5,返回序列数(num_return_sequences)= 5