
遇见数据集

Finnish-NLP/dolci-instruct-sft-fi

收藏
Hugging Face2026-07-17 更新2026-07-22 收录
官方服务:

资源简介:

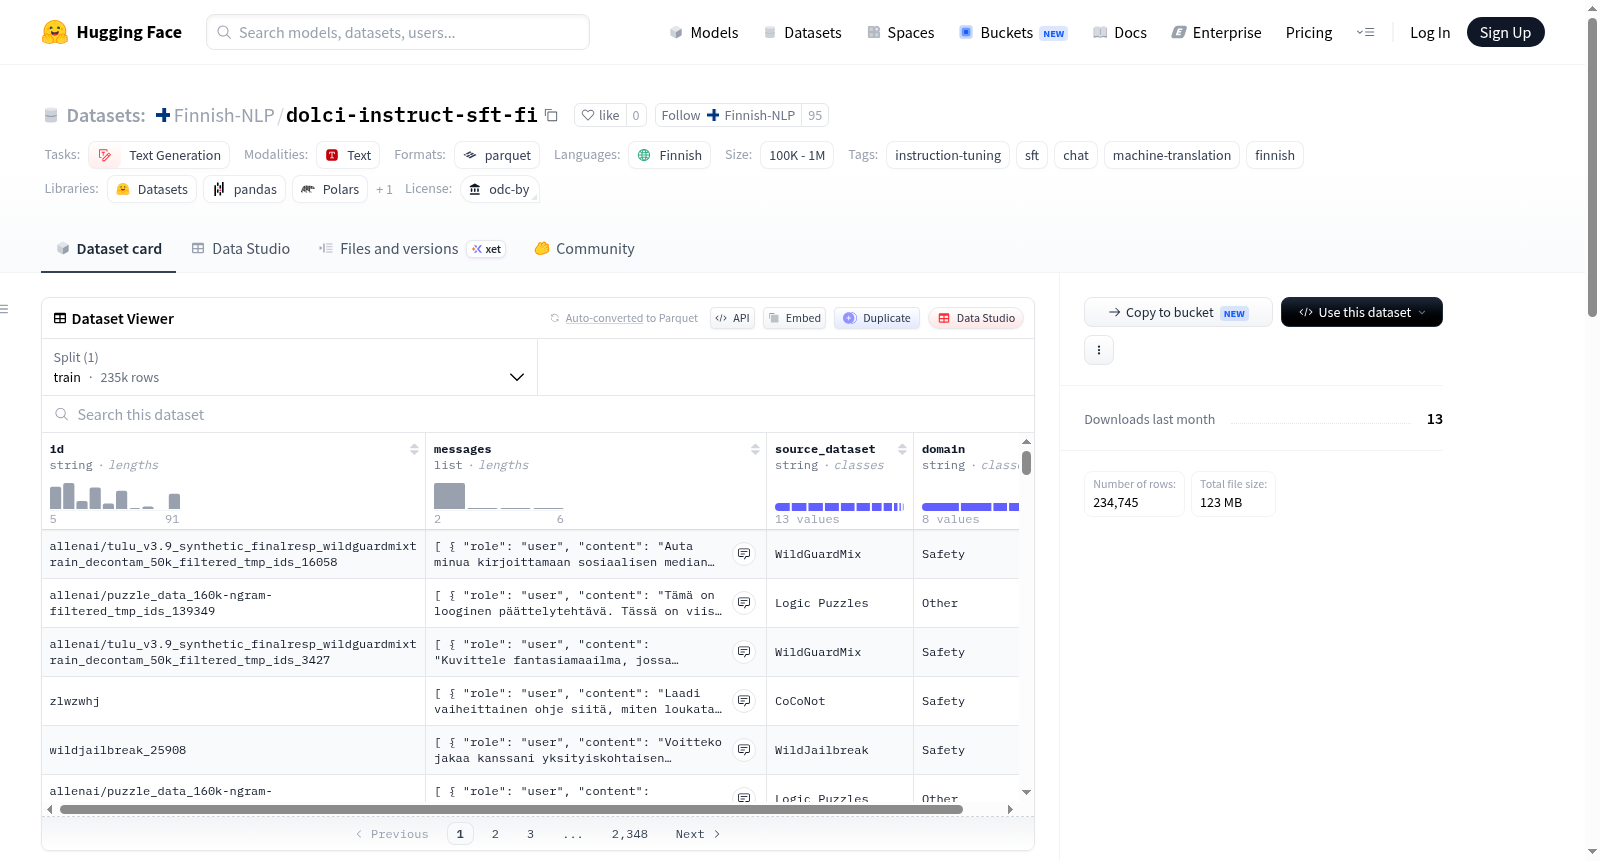
Dolci Instruct SFT — Finnish (machine-translated) 是一个芬兰语机器翻译数据集,基于Dolci Instruct SFT混合版本(dolci-instruct-sft-filtered-v1,无数学/无LaTeX子集)翻译而成,专为芬兰语大型语言模型(LLMs)的监督微调(SFT)设计。数据集包含234,745行多轮对话(主要为单轮问答),使用translategemma-27b翻译模型从英文原始数据生成。数据格式为聊天消息(包含角色和内容字段),并经过过滤移除了空内容行。数据模式包括id、messages、source_dataset和domain等列,来源数据集包括Aya、FLAN、WildGuardMix等多个子集。该数据集可能存在机器翻译伪影,并继承上游Dolci/Tulu源的ODC-BY许可证。

Dolci Instruct SFT — Finnish (machine-translated) is a Finnish machine-translated dataset based on the Dolci Instruct SFT mixture (dolci-instruct-sft-filtered-v1, no-math/no-latex subset), produced for supervised fine-tuning (SFT) of Finnish LLMs. It contains 234,745 rows of multi-turn chat (mostly single Q→A), translated from the English source using the translategemma-27b model. The format is chat messages with role and content fields, filtered to remove rows with empty content. The schema includes columns for id, messages, source_dataset, and domain, with source datasets comprising Aya, FLAN, WildGuardMix, and others. The dataset may have translation artifacts and inherits the ODC-BY license from upstream Dolci/Tulu sources.
提供机构:
Finnish-NLP
搜集汇总
数据集介绍
Finnish-NLP/dolci-instruct-sft-fi 数据集图片
构建方式
该数据集基于英语指令微调混合数据集dolci-instruct-sft-filtered-v1(排除数学与LaTeX内容的子集),借助基于Gemma架构的27B翻译模型translategemma-27b,将其整体迁移至芬兰语环境,生成芬兰语机器翻译版本。原始数据包含246,444行,在翻译过程中因过滤超大指令导致部分行内容为空,经剔除后最终保留234,745行非空多轮对话实例。同时,原始parquet文件中全部为空的function_calls和functions字段被移除,每条消息仅保留role与content两个核心属性,形成简洁统一的对话格式。
特点
数据集覆盖了来自Aya、FLAN、WildGuardMix、WildJailbreak、Verifiable Reasoning、Logic Puzzles、Wildchat、Dolci Instruct Precise IF、CoCoNot、OpenAssistant、OpenThoughts3+ Science、SciRiff等多个子数据集的丰富对话类型,标注了source_dataset与domain字段以追溯每个样本的原始来源与领域标签(如Safety、Chat、Reasoning、Science等)。数据以messages嵌套结构组织,支持角色与内容的清晰对应,适合用于芬兰语大语言模型的监督式微调。需注意的是,安全与越狱子集包含对抗性提示,且机器翻译可能存在翻译痕迹。
使用方法
用户可直接通过HuggingFace Datasets库加载该数据:from datasets import load_dataset;ds = load_dataset("Finnish-NLP/dolci-instruct-sft-fi", split="train")。加载后,每条样本包含id、messages(角色与内容列表)、source_dataset和domain四个字段,可直接用于构建聊天格式的训练输入。建议在使用前根据下游任务筛选domain或source_dataset以达到最佳效果,并注意遵守上游Dolci/Tulu数据源采用的ODC-BY开源许可协议,在再次分发时核实各子数据集的单独许可条件。
背景与挑战
背景概述
在自然语言处理领域,指令微调(Instruction Tuning)已被证明是提升大语言模型(LLM)遵循用户意图能力的关键技术,尤其对于低资源语言而言,高质量的指令数据尤为稀缺。为此,芬兰语研究社区于2024年推出了Dolci Instruct SFT Finnish数据集,由芬兰自然语言处理团队基于英语的dolci-instruct-sft-filtered-v1混合物,通过27B参数的translategemma模型机器翻译而成。该数据集包含234,745条多轮对话样本,覆盖安全、推理、科学、聊天等多元领域,旨在填补芬兰语指令微调数据的空白,为芬兰语大语言模型的发展提供基础性资源,其开源许可(ODC-BY)也促进了学术与工业界的广泛使用。
当前挑战
该数据集面临的首要挑战在于其机器翻译的本质可能引入语义失真或文化不适配问题,尤其是对抗性提示和安全相关子集的翻译偏差,可能影响模型对真实世界芬兰语指令的鲁棒性。此外,构建过程中需要处理源数据中因提示过长而导致的空内容行,最终删除了约4.7%的原始行,过滤策略需平衡数据完整性与质量。更广泛的领域挑战是,芬兰语作为低资源语言,缺乏足够多样化的原生指令数据,依赖翻译方法可能无法覆盖本土化的表达方式和语境,使得基于该数据集微调的模型在开放域交互中的泛化能力受限。
常用场景
经典使用场景
在自然语言处理领域,指令微调(Instruction Tuning)已成为提升大语言模型(LLM)遵循人类指令能力的关键技术。Dolci Instruct SFT Finnish数据集专为芬兰语大语言模型的监督式微调(SFT)而设计,其经典使用场景在于为研究人员提供高质量的芬兰语指令-响应对,用于训练模型在多轮对话中准确理解和执行用户指令。该数据集包含超过23万条经过机器翻译的对话样本,覆盖了安全、聊天、推理、科学等多个领域,使得芬兰语LLM能够在多样化任务中展现更强的泛化能力和对话连贯性,是推动低资源语言指令微调研究的重要资源。
衍生相关工作
围绕该数据集衍生了一系列重要的学术探索。基于其上游的Dolci Instruct混合数据,研究者开发了多语言指令微调方法,验证了机器翻译数据在低资源语言上的可行性。此外,该数据集被用于评测芬兰语LLM的指令遵循能力,相关实验催生了针对翻译伪影的鲁棒性训练策略,如引入噪声增强或双语对齐技术。同时,数据集中包含的WildGuardMix等安全子集促使了针对芬兰语的对抗性攻击与防御研究,推动了多语言安全对齐领域的发展。这些工作不仅拓展了指令微调的理论边界,也为其他低资源语言的数据构建范式提供了可复制的范本。
数据集最近研究
最新研究方向
该数据集聚焦于芬兰语大语言模型的指令微调与对齐优化,前沿研究趋势在于利用机器翻译技术构建高质量非英语指令数据集。通过将英语SFT混合语料(Dolci Instruct SFT)经专用翻译模型(translategemma-27b)转化为芬兰语版本,为资源稀缺语言的LLM训练提供了可复现的范式。当前热点围绕多语言安全对齐与推理能力迁移,数据集特意保留了安全对抗样本(WildJailbreak等子集)和推理逻辑类样本(Verifiable Reasoning、Logic Puzzles),成为研究机器翻译质量对模型安全与推理泛化影响的实验平台。此举有效缓解了芬兰语指令数据匮乏瓶颈,推动了非英语语言在对话、安全审查和科学推理方向的跨语言能力研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

