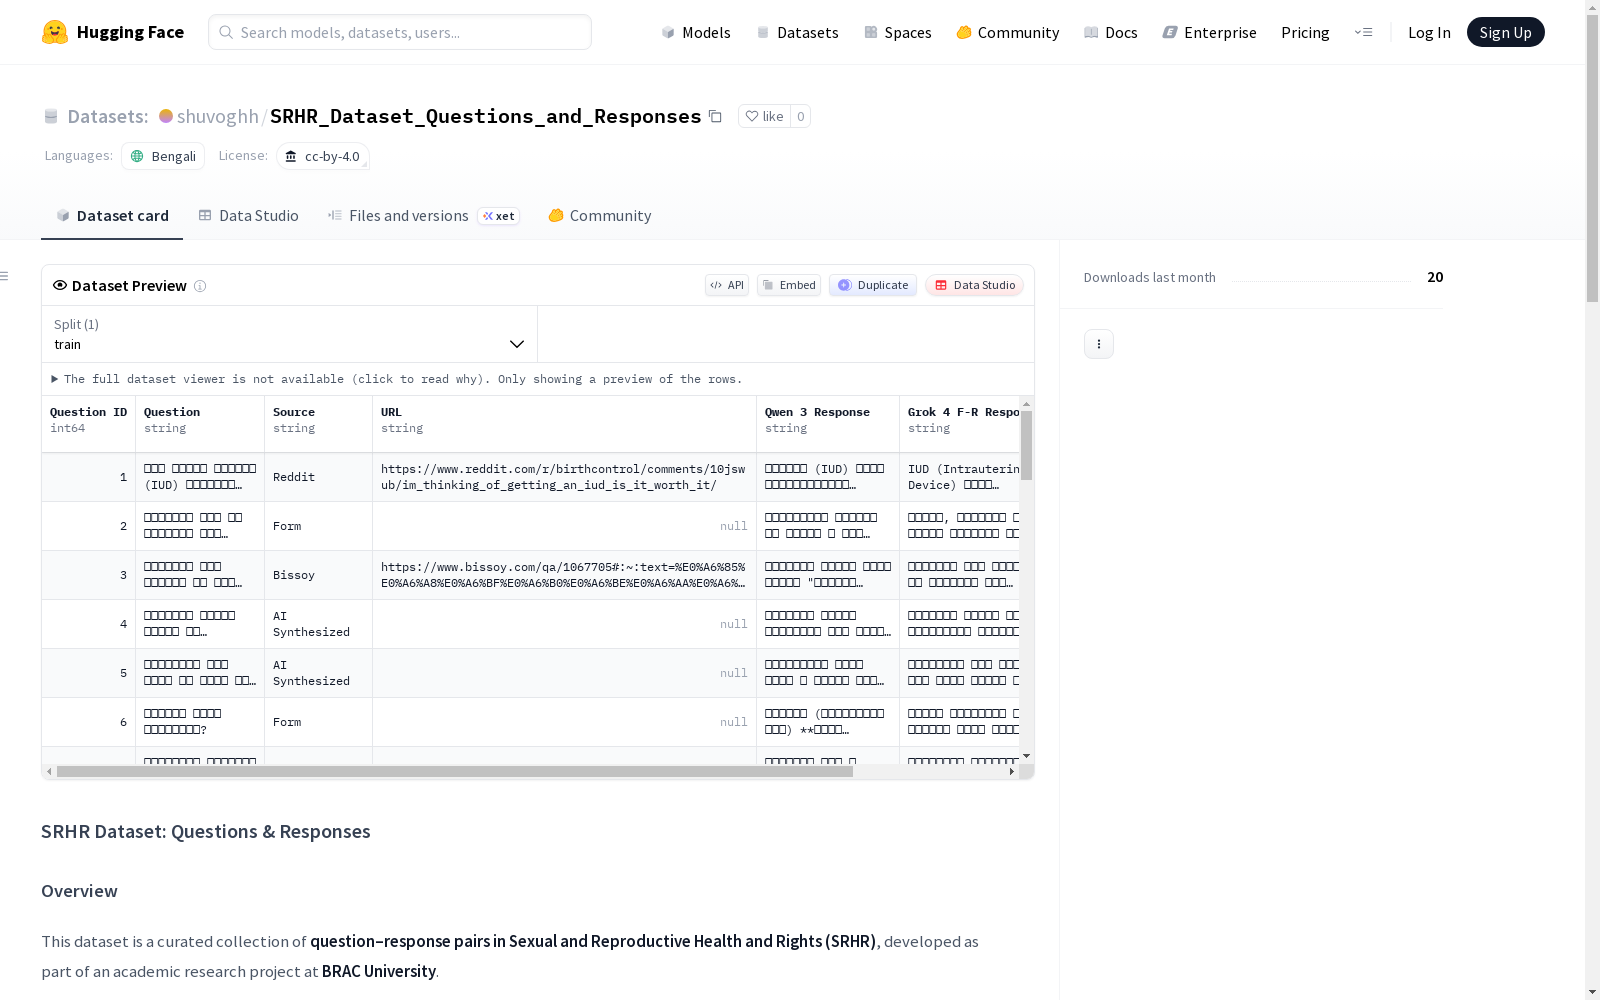
SRHR_Dataset_Questions_and_Responses
收藏资源简介:
SRHR数据集是一个关于性与生殖健康及权利(SRHR)的问题-回答对精选集合,由BRAC大学的一个学术研究项目开发。该数据集旨在支持在敏感医疗背景下对大型语言模型(LLMs)的系统性评估,特别关注孟加拉语和多语言人群,这些人群中的SRHR话题常被污名化或视为文化禁忌。数据集主要用于作为评估基准,而非训练语料库。每个数据条目包含一个真实世界的SRHR相关用户查询和一个结构化、信息丰富且不带偏见的回答。数据集反映了SRHR相关查询中常见的语言多样性、非正式表达和文化基础。数据集适用于LLM聊天机器人的评估和基准测试、多语言和低资源语言研究、LLM-as-a-Judge研究、人机比较评估以及学术研究。数据集不应用于临床诊断或治疗决策、紧急或危机干预系统、未经专业监督直接部署于医疗环境或生成个性化医疗建议。数据集在开发过程中采取了严格的伦理保护措施,确保无个人身份信息(PII)、匿名化处理、内容为信息性和教育性,并优先考虑安全性、清晰度和文化敏感性。数据集发布在Creative Commons Attribution 4.0 International (CC BY 4.0)许可下。
SRHR Dataset: Questions & Responses 数据集概述
数据集基本信息
- 数据集名称: SRHR Dataset: Questions & Responses
- 托管地址: https://huggingface.co/datasets/shuvoghh/SRHR_Dataset_Questions_and_Responses
- 许可协议: Creative Commons Attribution 4.0 International (CC BY 4.0)
- 主要语言: 孟加拉语 (bn)
概述
本数据集是一个关于性与生殖健康及权利(SRHR)的问题-回答对精选集合,由BRAC大学的一项学术研究项目开发。其创建目的是支持在敏感的医疗保健背景下对大型语言模型(LLMs)进行系统性评估,特别关注孟加拉语使用者和多语言人群,因为在这些群体中,SRHR话题常被污名化或属于文化禁忌。该数据集主要设计为对话AI系统的评估基准,而非训练语料库。
研究背景
本数据集支持以下论文研究: “Development and Implementation of a Framework for Evaluating Large Language Models in Sexual and Reproductive Health and Rights”(《评估大型语言模型在性与生殖健康及权利领域的框架开发与实施》),BRAC大学计算机科学与工程系(2025年)。 数据集支撑了一个基于量规的评估框架,该框架结合了:
- 自动化的 LLM-as-a-Judge 评分
- 由医疗专业人士和非专家用户进行的并行人工评估
数据集结构
每个数据条目包含:
- 问题: 一个现实世界中的SRHR相关用户查询
- 回答: 一个结构化、信息丰富且不带评判性的答案 数据集反映了SRHR相关咨询中常见的语言多样性、非正式措辞和文化背景表达。
预期用途
本数据集适用于:
- SRHR领域基于LLM的聊天机器人的评估与基准测试
- 多语言和低资源语言研究
- LLM-as-a-Judge 研究
- 人机对比评估
- 学术研究、论文工作及可重复实验
非预期用途
本数据集不得用于:
- 临床诊断或治疗决策
- 紧急或危机干预系统
- 在没有专业监督的情况下直接部署于医疗保健环境
- 生成个性化医疗建议
伦理考量
鉴于SRHR的敏感性,数据集的开发遵循严格的伦理保障措施:
- 不包含任何个人可识别信息(PII)
- 所有问题均已匿名化并脱离具体情境
- 内容具有信息性、教育性并以权利为基础
- 明确排除露骨、图像化或有害内容
- 回答优先考虑安全性、清晰度和文化敏感性 强烈建议用户在使用本数据集时应用负责任的AI实践。
已知局限性
- 数据集设计用于评估,而非覆盖所有SRHR主题
- 不能替代专业医疗指导
- 所反映的文化规范主要以南亚/孟加拉为中心
许可信息
本数据集根据知识共享署名 4.0 国际许可协议(CC BY 4.0) 发布。 您可以自由分享和改编该数据集,但需进行适当署名。
联系方式
如有学术或研究相关查询,请通过相关的Hugging Face个人资料联系数据集作者。