遇见数据集

Multimodal-Fatima/FGVC_Aircraft_test_facebook_opt_350m_Attributes_Caption_ns_3333_random

收藏
Hugging Face2023-02-04 更新2024-03-04 收录
官方服务:

资源简介:

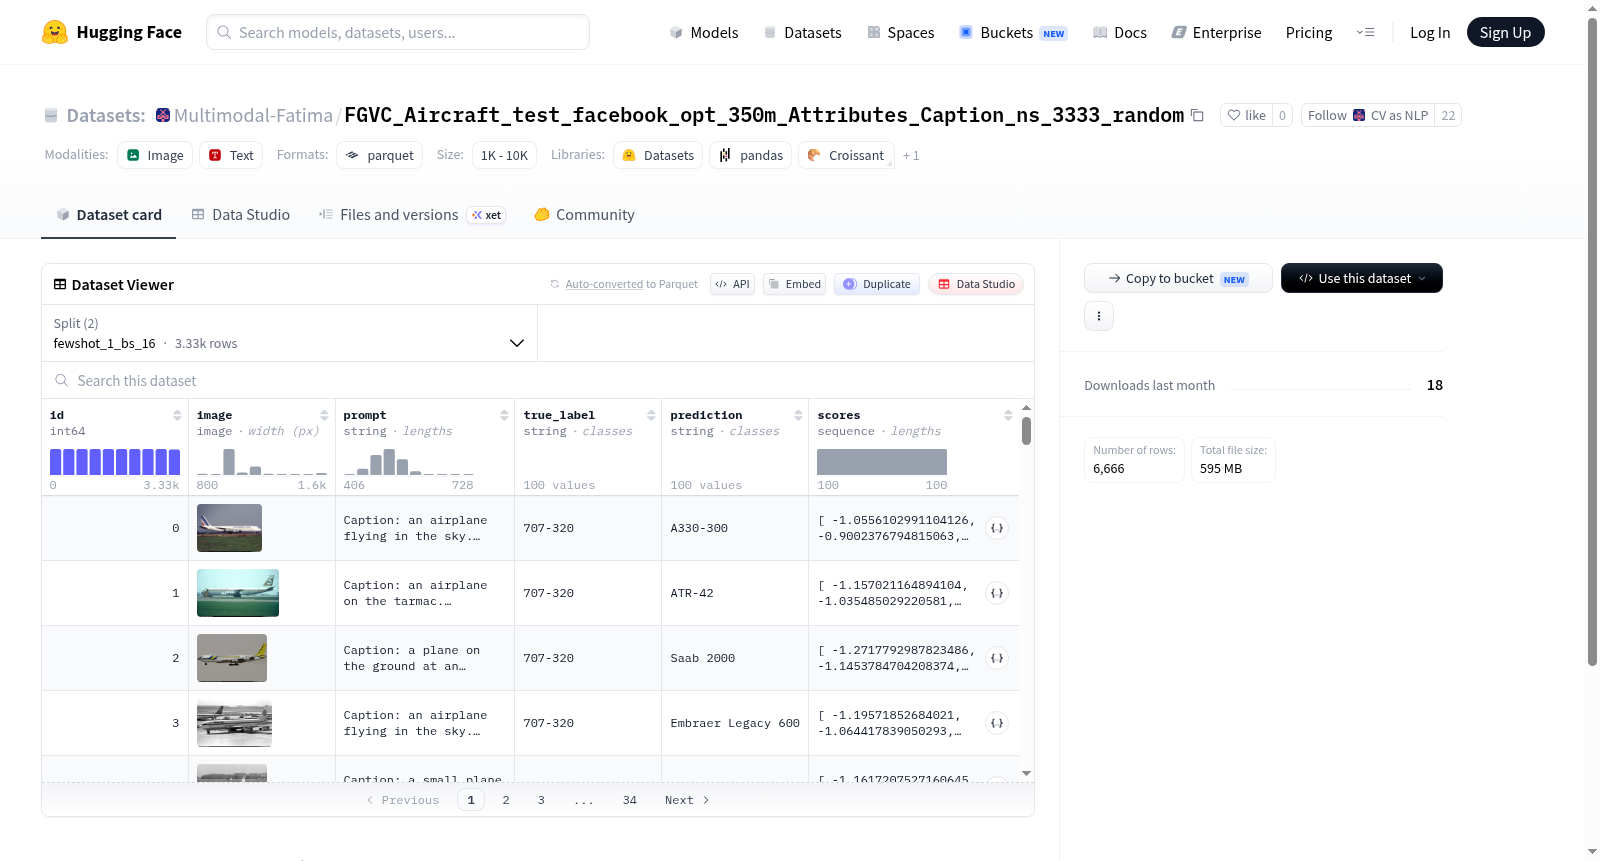
--- dataset_info: features: - name: id dtype: int64 - name: image dtype: image - name: prompt dtype: string - name: true_label dtype: string - name: prediction dtype: string - name: scores sequence: float64 splits: - name: fewshot_1_bs_16 num_bytes: 300147629.375 num_examples: 3333 - name: fewshot_3_bs_16 num_bytes: 301866570.375 num_examples: 3333 download_size: 595044400 dataset_size: 602014199.75 --- # Dataset Card for "FGVC_Aircraft_test_facebook_opt_350m_Attributes_Caption_ns_3333_random" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

--- 数据集信息: 特征字段: - 名称:id,数据类型:int64(64位整数) - 名称:image,数据类型:图像 - 名称:prompt(提示词),数据类型:字符串 - 名称:true_label(真实标签),数据类型:字符串 - 名称:prediction(预测结果),数据类型:字符串 - 名称:scores(得分),数据类型:float64序列(64位浮点数序列) 数据集划分: - 名称:fewshot_1_bs_16(少样本1,批大小16),字节数:300147629.375,样本数:3333 - 名称:fewshot_3_bs_16(少样本3,批大小16),字节数:301866570.375,样本数:3333 下载大小:595044400 字节 数据集总大小:602014199.75 字节 --- # 「FGVC_Aircraft_test_facebook_opt_350m_Attributes_Caption_ns_3333_random」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
Multimodal-Fatima
原始信息汇总

数据集概述

数据集名称

  • 名称: FGVC_Aircraft_test_facebook_opt_350m_Attributes_Caption_ns_3333_random

数据集特征

  • id: 整数类型 (int64)
  • image: 图像类型
  • prompt: 字符串类型 (string)
  • true_label: 字符串类型 (string)
  • prediction: 字符串类型 (string)
  • scores: 序列类型,浮点数 (float64)

数据集分割

  • fewshot_1_bs_16:
    • 示例数量: 3333
    • 数据大小: 300147629.375 字节
  • fewshot_3_bs_16:
    • 示例数量: 3333
    • 数据大小: 301866570.375 字节

数据集大小

  • 下载大小: 595044400 字节
  • 数据集总大小: 602014199.75 字节
搜集汇总
数据集介绍
Multimodal-Fatima/FGVC_Aircraft_test_facebook_opt_350m_Attributes_Caption_ns_3333_random 数据集图片
构建方式
该数据集基于FGVC Aircraft测试集构建,通过引入facebook/opt-350m模型为每张图像生成属性描述与随机负样本提示(ns_3333_random),形成包含图像、提示文本、真实标签、模型预测及置信度分数的多模态结构。数据划分为fewshot_1_bs_16和fewshot_3_bs_16两个子集,各含3333个样本,以支持不同样本量的少样本学习场景。
特点
数据集以细粒度飞机分类为核心,融合了视觉与语言模态,其中提示文本由大语言模型自动生成,增强了对类间微小差异的语义表征。每个样本均附带模型预测与得分序列,便于评估分类置信度,同时随机负样本设计提升了判别任务难度,适用于鲁棒性分析。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,直接访问image与prompt字段进行多模态输入,利用true_label和prediction字段计算分类指标。支持基于fewshot_1_bs_16或fewshot_3_bs_16子集开展少样本学习实验,亦可结合scores字段进行置信度校准或不确定性分析。
背景与挑战
背景概述
细粒度视觉分类(Fine-Grained Visual Classification, FGVC)是计算机视觉领域的重要研究方向,旨在区分同一大类下不同子类之间的细微差异,例如不同型号的飞机、不同种类的鸟类或不同款式的汽车。FGVC-Aircraft数据集作为该领域的经典基准之一,专注于飞机型号的识别任务,其测试集常被用于评估模型对细粒度特征的捕捉能力。Multimodal-Fatima团队基于此数据集,融合了多模态学习范式,利用Facebook的OPT-350M语言模型生成属性描述与标题,构建了包含3333条样本的测试子集。该数据集创建于多模态与预训练模型快速发展的时期,核心研究问题在于探索视觉与语言模型协同作用下的细粒度分类性能,尤其关注少样本学习场景下的泛化能力。这一工作推动了视觉-语言模型在专业领域应用的研究进程,为评估模型对细粒度知识的理解提供了新的测试基准。
当前挑战
该数据集面临的核心挑战首先来自细粒度分类本身的领域难题:不同飞机型号之间视觉差异极其微小,例如仅凭机翼形状或引擎位置进行区分,对模型的特征提取能力提出极高要求。在少样本设定下(如仅提供1或3个训练样本),模型需从有限样例中学习泛化特征,极易陷入过拟合或混淆。此外,构建过程中,将原始FGVC-Aircraft测试集与OPT-350M生成的文本描述对齐,需确保属性与标题的语义准确性,避免因语言模型幻觉引入噪声标签。同时,多模态融合的挑战在于如何有效整合视觉特征与文本表示,防止模态间信息冗余或冲突,从而影响最终分类决策的鲁棒性。
常用场景
经典使用场景
在细粒度视觉分类领域,FGVC-Aircraft数据集长期以来是评估模型对飞机型号辨识能力的标杆。该数据集将高分辨率航拍图像与精准的类别标签结合,为研究飞机子类别间的细微差异提供了标准化基准。其经典使用场景聚焦于零样本与少样本学习范式,即通过少量标注样本(如每类1张或3张图片)测试模型在未见过的飞机型号上的泛化能力。这一设定尤其适用于现实世界中稀有型号数据难以大量采集的困境,推动模型从有限样本中捕获判别性特征,如机翼形状、引擎布局等视觉线索。
解决学术问题
该数据集直面细粒度分类中两大核心学术挑战:类别间高相似性与数据稀缺性。传统分类方法在区分波音737与空客A320等视觉近似型号时,常因特征重叠而性能受限。通过提供多粒度标签(如制造商、家族、变体)与对比性预测概率,该数据集促使研究者探索注意力机制与度量学习等策略,以增强模型对局部纹理和结构差异的敏感性。其意义在于验证了跨模态知识迁移(如视觉-语言模型)在细粒度任务中的有效性,为计算视觉与自然语言处理的交叉融合提供了实证支撑。
衍生相关工作
围绕此数据集,学术界已衍生出一系列经典工作。其中,基于CLIP视觉语言模型的零样本分类方法被首次在此数据集上验证,证明预训练模型在未见类别上的零样本迁移能力。后续工作包括引入属性级语义描述(如机翼角度、发动机数量)作为辅助监督信号,构建多模态对比学习框架以增强类别区分度。此外,少样本学习领域中的原型网络与关系网络也常以此数据集为测试床,探索如何通过元学习策略从每类少量样本中提取可泛化的特征空间。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务