
PrimeIntellect/deshuffle-papers-v1-corpus
收藏官方服务:
资源简介:
Deshuffle Papers v1 语料库是一个私有运行时语料库,包含1,000篇独特的学术论文,其中500篇来自arXiv,500篇来自bioRxiv。许可证方面,983篇采用CC BY 4.0许可,17篇采用CC0 1.0许可。主要数据文件为corpus.jsonl,每行记录源元数据以及有序的标题和段落块,同时保留每行的特定许可证和URL元数据。记录顺序是环境确定性任务定义的一部分,必须保持不变。
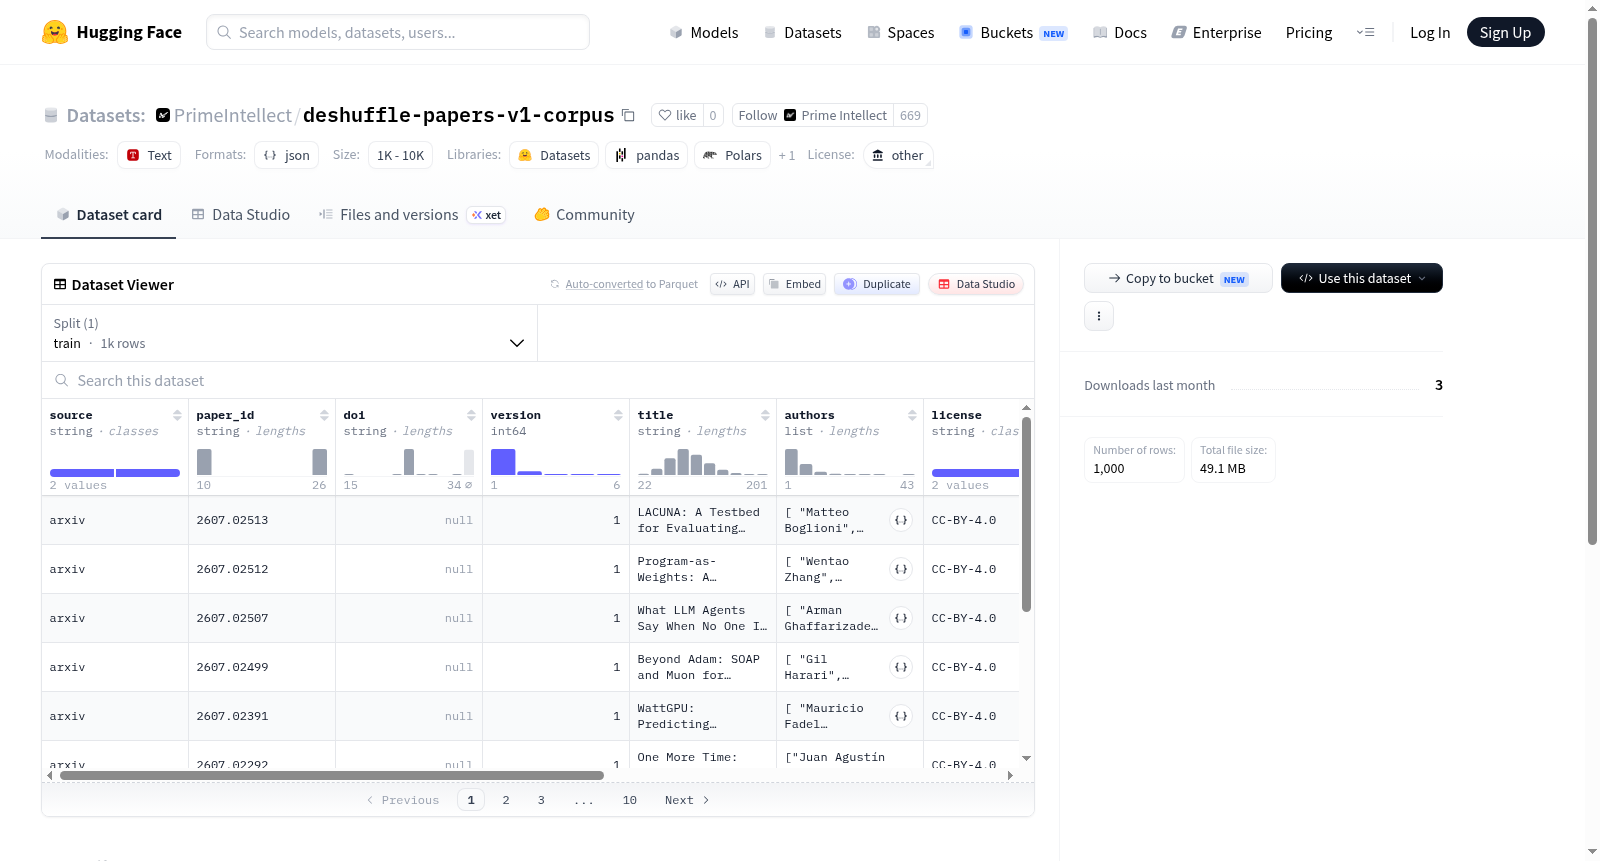
The Deshuffle Papers v1 Corpus is a private runtime corpus containing 1,000 unique papers: 500 from arXiv and 500 from bioRxiv. Licenses include 983 CC BY 4.0 and 17 CC0 1.0. The canonical file is corpus.jsonl, and each row records source metadata along with ordered heading/para blocks, retaining per-row license and URL metadata. The record order is part of the environments deterministic task definition and must be preserved.
提供机构:
PrimeIntellect搜集汇总
数据集介绍
构建方式
Deshuffle Papers v1 Corpus 是一个专为论文重组任务设计的私有运行时语料库,其构建基于对两类学术预印本平台——arXiv 与 bioRxiv——的文献筛选。数据集收录了共计1,000篇独立论文,其中500篇源自arXiv、500篇源自bioRxiv,确保了跨学科领域的覆盖。每篇论文均以JSONL格式存储于规范文件corpus.jsonl中,行内记录了来源元数据以及按序排列的“heading”与“para”文本块,同时保留了每行数据对应的特定许可与URL元信息。记录的既定顺序被视作任务环境中的确定性定义,必须予以严格保持。
特点
该数据集的核心特点在于其严格的版权合规性与结构化存储方式。全部论文均采用开放许可协议,其中983篇遵循CC BY 4.0、17篇遵循CC0 1.0,为下游科研与重排任务提供了明确的法律保障。此外,数据以heading与para块的有序排列形式呈现,而非简单的全文拼接,这种精细化的结构设计使得模型能够更好地捕捉论文章节内部的逻辑连贯性与段落间的自然过渡。固定的记录顺序则确保了任务的可复现性与评估的公平性。
使用方法
Deshuffle Papers v1 Corpus 主要用于训练与评估论文章节重排序模型。使用者可直接加载corpus.jsonl文件,遍历各行提取heading与para块序列,进而通过打乱这些块的初始顺序构造训练或测试样本。由于记录顺序是任务定义的组成部分,模型对顺序信息的利用需谨慎处理。建议采用序列到序列或基于Transformer的排序架构,以有序块为输入、恢复的原始顺序为监督信号进行优化。配合校验文件提供的SHA-256哈希值,可确保数据完整性。
背景与挑战
背景概述
Deshuffle Papers v1 Corpus 数据集于近期构建,由匿名研究团队创建,旨在为学术文献的序列重排任务提供标准化的测试基准。该数据集精心选取了1,000篇独特论文,其中500篇来自arXiv预印本平台,500篇来自bioRxiv生物科学预印本平台,涵盖了计算机科学与生命科学两大领域。所有论文均采用开放许可协议(983篇CC BY 4.0,17篇CC0 1.0),确保了数据在科研与教育场景中的自由使用。通过保留每篇论文的标题与段落块的原始顺序,该数据集为评估模型在文档结构恢复与语义连贯性推理方面的能力奠定了坚实基础,对自然语言处理中的段落排序与信息组织研究具有重要的推动作用。
当前挑战
该数据集主要挑战在于解决文档结构混乱后的段落级顺序恢复问题,即模型需从无序的标题与段落块中重新构建逻辑连贯的原始文本。这一任务要求模型具备跨越长文本上下文的语义理解与因果推理能力,而现有模型在处理多来源、多领域学术论文时往往受限于领域术语差异与论证范式多样性。构建过程中,数据筛选需兼顾来源平衡与许可合规,确保1,000篇论文的版权类型一致且元数据完整,同时记录顺序必须严格固定以维持任务定义的可复现性,这对数据采集与验证流程提出了精细化管理的要求。
常用场景
经典使用场景
Deshuffle Papers v1 Corpus 是一个精心构建的学术论文语料库,收录了1,000篇来自 arXiv 和 bioRxiv 的独特论文,其中983篇采用CC BY 4.0许可证、17篇采用CC0 1.0许可证。该数据集最经典的使用场景在于文本序列重排任务,研究者需要根据乱序的章节标题和段落块恢复论文的原始逻辑结构。这一场景模拟了现实世界中文档碎片化后的信息整合挑战,为评估和训练语言模型在长文本结构理解与排序能力方面提供了标准化的基准平台。
解决学术问题
该数据集解决了学术研究中文档结构重建的定量评估难题。传统自然语言处理研究多聚焦于句子级别的连贯性,缺乏对学术论文这种具有严格组织结构的长文档进行全局排序的标准化资源。Deshuffle Papers v1 Corpus 填补了这一空白,使得学术界能够系统性地研究段落间层次关系推理、章节语义边界检测以及基于内容逻辑的排序算法。其影响在于推动了文档理解领域从局部特征向全局结构的范式转变,并为评估模型在复杂科学文本上的推理能力提供了可复现的测试环境。
衍生相关工作
Deshuffle Papers v1 Corpus 的发布催生了一系列相关研究工作。基于该数据集,研究者提出了多种序列排序模型,如基于Transformer的层次化排序架构和结合图神经网络的段落关系推理方法。还有工作探索了利用对比学习增强段落的语义表征以提升排序精度,以及将排序任务与摘要生成联合建模的多任务学习框架。此外,该数据集也被用作评估大型语言模型在文档结构理解方面能力的基准之一,衍生出诸如结构感知的预训练目标和段落级排序数据增强策略等创新性贡献,进一步推动了文档智能处理领域的发展。
以上内容由遇见数据集搜集并总结生成


