joyo-kanji-yomi-benchmark-parakeet
收藏资源简介:
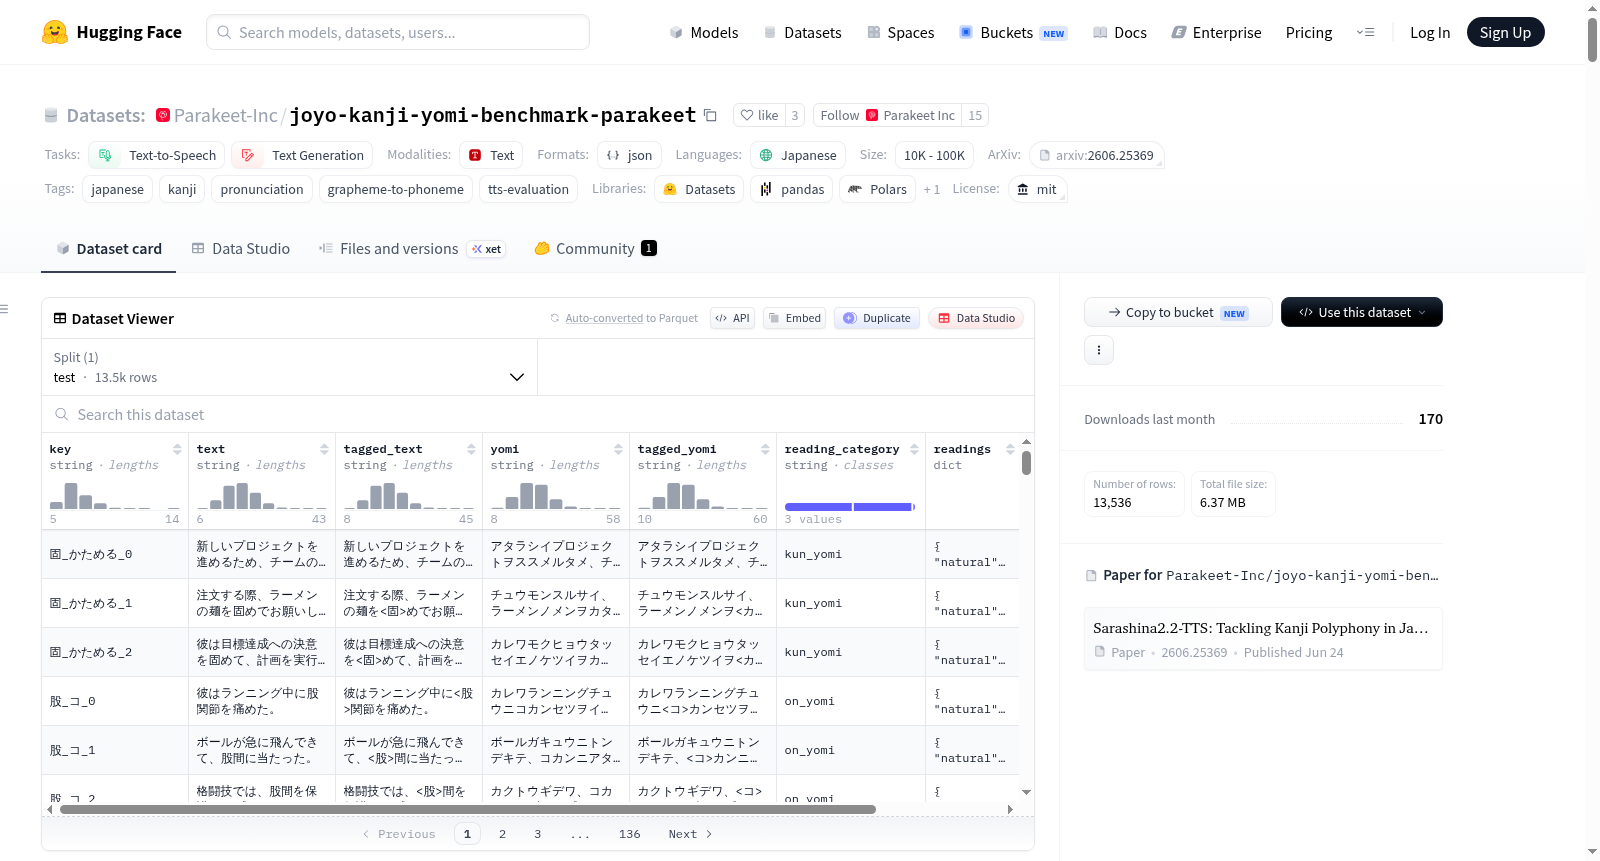
Joyo Kanji Yomi Benchmark: Parakeet Edition(JKYB-Parakeet)是一个用于评估日语汉字读音正确性的基准数据集,专注于G2P(字形到音素)模型、形态分析器和TTS(文本到语音)系统在日语句子中正确读取汉字的能力。该数据集基于SB Intuitions的原始JKYB数据集,由Parakeet Inc.独立审查、修正错误、统一标注并新增数据。数据内容涵盖日本文化厅常用汉字表本表中所有汉字-读音对,以及付表中所有词-读音对,每个读音提供3个例句。每个句子包含详细的标注:目标汉字及其读音(片假名表示)、读音分类(音读、训读或付表读音)、其他自然读音(若存在)以及可接受的边缘读音(字典上无误但通常不自然)。目标汉字在句子中用尖括号<>标记,便于精确评估。数据集规模:汉字-读音对4,512个,总句子数13,536个(4,512×3)。其中音读句子7,056个,训读句子6,108个,付表读音句子372个,具有多个自然读音的句子75个,具有边缘读音的句子55个。数据文件格式为JSONL,包含key、text、tagged_text、yomi、tagged_yomi、reading_category、readings(natural和marginal列表)以及source字段。该数据集适用于以下任务:1) G2P、形态分析或读音预测(将输入文本转换为片假名读音序列);2) TTS(从文本生成语音)。推荐使用官方提供的评估工具包进行评测。相较于原始JKYB,本数据集进行了多项修正和增强:修正了原始数据中的不自然例句、错误读音、汉字使用不当和重复;对目标读音存在歧义的句子进行LLM重构或手动标注自然/边缘读音;对非目标读音的歧义性进行了标准化处理(如“私”统一读作“ワタシ”);新增了原始JKYB中缺失的常用汉字表本表读音和所有付表条目。读音标注策略从原始JKYB的“发音形”(如“キョー”表示“今日”)改为“假名形”(如“キョウ”),但助词“は”和“へ”使用发音形“ワ”和“エ”。汉字字形进行了异体字统一(如“剝→剥”、“頰→頬”)。目标汉字标注范围统一为最小对应范围(如“固める”标注为“<固>める”)。所有修改和新增的条目均由日语母语者人工验证。数据集以MIT许可证发布。
Joyo Kanji Yomi Benchmark: Parakeet Edition (JKYB-Parakeet) is a benchmark dataset for evaluating the correctness of Japanese kanji readings in sentences, focusing on G2P (grapheme-to-phoneme) models, morphological analyzers, and TTS (text-to-speech) systems. It is based on the original JKYB dataset by SB Intuitions, independently reviewed, corrected, and augmented by Parakeet Inc. The dataset covers all kanji-reading pairs from the Joyo Kanji table and all word-reading pairs from the supplementary table, with 3 example sentences per reading. Each sentence includes detailed annotations: target kanji and its reading (in katakana), reading category (onyomi, kunyomi, or supplementary), other natural readings (if any), and acceptable marginal readings. The dataset contains 4,512 kanji-reading pairs and 13,536 sentences, with JSONL format including fields like key, text, tagged_text, yomi, tagged_yomi, reading_category, readings (natural and marginal), and source. It is suitable for G2P/morphological analysis/reading prediction and TTS tasks. The dataset is released under the MIT license.
Joyo Kanji Yomi Benchmark: Parakeet Edition (JKYB-Parakeet)
数据集概述
JKYB-Parakeet 是一个用于评估日语 G2P(字形到音素)模型、形态素解析器及 TTS 系统在日语句子中正确读取汉字能力的基准数据集。该数据集由 Parakeet 公司在 SB Intuitions 的原始数据集 sbintuitions/joyo-kanji-yomi-benchmark 基础上,经内容验证、错误修正、表记统一和数据追加后形成。
数据规模
| 项目 | 数量 |
|---|---|
| 汉字与读音配对 | 4,512 |
| 总句子数 | 13,536 |
| 音读句子 | 7,056 |
| 训读句子 | 6,108 |
| 常用汉字表付表词汇句子 | 372 |
| 含多个自然读音的句子 | 75 |
| 含可接受读音的句子 | 55 |
| 源自 JKYB 的修改行 | 3,440 |
| 修正 JKYB 缺陷数 | 1,284 |
| 新增行数 | 441 |
数据来源与覆盖范围
- 覆盖日本文化厅常用汉字表本表全部汉字与读音及付表全部词汇与读音(如熟字训:今日→キョウ、田舎→イナカ、風邪→カゼ)。
- 每个汉字读音配对包含 3 个例句,并为每个例句提供汉字和读音在上下文中的精确标注(以
<>标记),同时记录文脉上可接受的其他自然读音(natural)和边缘读音(marginal)。
适用任务
- G2P / 形态素解析 / 读音推定:将输入文本转换为片假名读音序列。
- TTS(文本到语音):从输入文本生成对应的语音。
与原始 JKYB 的主要差异
缺陷修正
- 对不自然或汉字使用不当的例句,使用 LLM 重新生成。
- 修正明确错误的读音。
- 对具有目标读音歧义的例句进行改写或手动标注。
新增数据
- 补全原始 JKYB 中因文脉无法消除歧义而被排除的本表读音条目。
- 新增常用汉字表付表(熟字训)的全部词汇与读音。
表记统一
- 对高频且文脉难以判别读音的词汇进行规则化统一(如:私→ワタシ、明日→アシタ、日本→ニホン 等)。
- 规范汉字异体字:剝→剥、塡→填、頰→頬、龍→竜、𠮟→叱。
读音表记方针
- 采用假名形表记(如:小学校→ショウガッコウ),而非原始数据的使用发音形(如:ショーガッコー)。
- 助词「は」「へ」采用发音形「ワ」「エ」。
标注方针
- 统一将标签范围设为对应目标汉字的最小范围(如:
<固>める: <カタ>メル)。
质量保证
所有从 JKYB 修改或新增的行均已由日语母语者逐行人工审查,确认修改合理性、读音正确性及歧义注释的准确性。完整的变更明细可在 Google 工作表 中查看。
使用方式
建议使用 GitHub 提供的评估工具包 进行评测,因数据集的读音表记与原始 JKYB 所假设的 ASR 模型输出(如 sbintuitions/kana-whisper)不完全兼容,需参考工具包内的读音归一化处理。
实际数据文件位于 data/common_kanji_source.jsonl(相对路径请基于 Hugging Face 数据集页面解析)。
许可协议
数据集采用 MIT 许可证,原始版权声明与归属详见数据集页面中的 LICENSE 和 NOTICE 文件。