
lmms-lab/LiveBench
收藏官方服务:
资源简介:
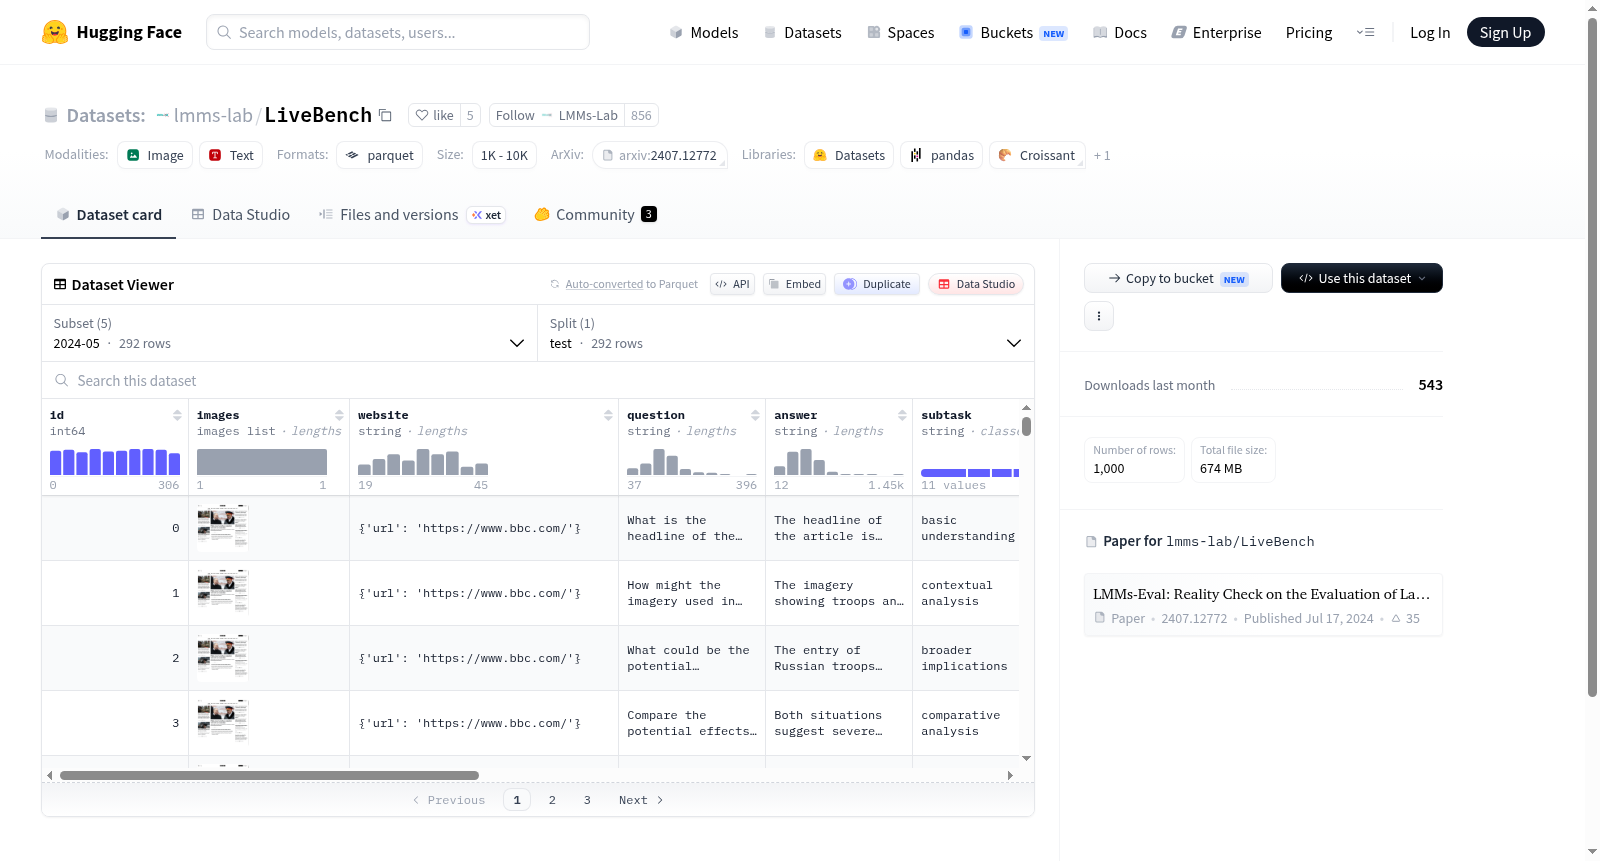
该数据集包含三个不同配置(2024-05, 2024-06, 2024-07),每个配置包含多个特征,如id、images、website、question、answer等。数据类型包括int64、int32、string和image序列。数据集仅包含测试集,每个配置的测试集大小和样本数量不同。2024-05配置包含292个样本,2024-06和2024-07配置各包含250个样本。
The dataset includes three different configurations (2024-05, 2024-06, 2024-07), each containing multiple features such as id, images, website, question, answer, etc. Data types include int64, int32, string, and image sequences. The dataset only includes a test set, with different sizes and numbers of samples for each configuration. The 2024-05 configuration contains 292 samples, while the 2024-06 and 2024-07 configurations each contain 250 samples.
提供机构:
lmms-lab原始信息汇总
数据集概述
配置名称:2024-05
-
特征信息:
- id: int64
- images: 图像序列
- website: 字符串
- question: 字符串
- answer: 字符串
- subtask: 字符串
- data_generator: 字符串
- checker: 字符串
- date_time: 字符串
- screen_shoter: 字符串
- screen_size: 字符串
- score: int32
- reason: 字符串
- scorer_name: 字符串
-
数据分割:
- 名称: test
- 数据大小: 359821661.53745925 字节
- 示例数量: 292
-
下载大小: 94416904 字节
-
数据集大小: 359821661.53745925 字节
配置名称:2024-06
-
特征信息:
- id: int32
- images: 图像序列
- website: 字符串
- question: 字符串
- answer: 字符串
- subtask: 字符串
- data_generator: 字符串
- checker: 字符串
- date_time: 字符串
- screen_shoter: 字符串
- screen_size: 字符串
- score: int32
- reason: 字符串
- scorer_name: 字符串
-
数据分割:
- 名称: test
- 数据大小: 4070390.0 字节
- 示例数量: 9
-
下载大小: 469739 字节
-
数据集大小: 4070390.0 字节
搜集汇总
数据集介绍
构建方式
在人工智能与视觉语言模型飞速发展的背景下,LiveBench数据集应运而生,旨在对多模态大模型进行动态、公平的评测。该数据集采用按月划分的构建策略,从2024年5月至9月共形成五个独立子集,每个子集包含来自真实网页的截图、问题、答案及评分信息。数据通过自动化工具生成,涵盖图像、文本、子任务类型及校验器等多个字段,确保样本的多样性和评测的可靠性。每个配置均以测试集形式提供,样本量从8到292不等,反映了不同时间段的采集强度。
特点
LiveBench数据集的核心特色在于其时间维度上的连续性与动态更新机制,能够捕捉模型在不同时期的表现变化。每个样本均附有详细的元数据,包括截图来源、屏幕尺寸、评分及评分原因,为深入分析模型行为提供了丰富维度。数据集采用多字段结构,如subtask和criteria,支持细粒度的任务拆解与评价标准定制。此外,数据生成器与校验器的分离设计,增强了数据构建的透明度和可复现性,适用于多模态模型的横向对比与纵向追踪。
使用方法
使用LiveBench数据集时,研究者可通过HuggingFace平台按配置名称加载对应月份的测试集,例如选择'2024-06'以评估模型在6月数据上的表现。数据加载后,可利用question字段作为输入,answer字段作为参考标准,结合scorer_name和score字段进行自动化评分。建议将图像数据与文本问题配对,输入多模态模型进行推理,并借助checker字段验证输出一致性。数据集支持批量处理,适用于训练后评估、模型调优或跨版本性能比较等场景。
背景与挑战
背景概述
在大规模多模态模型(LMM)评估领域,传统静态基准因数据泄露和评测时效性不足而日益受到质疑。LiveBench由lmms-lab团队于2024年提出,旨在通过动态更新的方式构建一个持续追踪前沿模型性能的评测体系。该数据集的核心研究问题在于如何设计一个能够抵抗记忆效应、反映真实世界复杂场景的评估协议。作为多模态领域的重要创新,LiveBench通过引入月度更新的子集(如2024-05至2024-09版本),覆盖图像理解、网页截图解析等多样化任务,为衡量模型在开放环境中的泛化能力提供了可靠标尺。其影响力体现在推动了评测范式的转变——从一次性静态测试转向持续演进的动态评估,为后续研究奠定了方法论基础。
当前挑战
LiveBench面临的核心挑战在于动态评测带来的多重复杂性。领域问题层面,传统多模态基准难以有效避免模型对固定测试集的过拟合,而LiveBench需在确保任务多样性的同时,维持不同月度子集间难度的一致性,这对问题生成与评分标准的可迁移性提出了极高要求。构建过程中,数据收集需兼顾时效性与质量——例如从真实网站截取图像并设计问答对时,需处理网页布局多变、干扰元素繁多等问题;此外,自动化评分器(checker)的鲁棒性直接决定评测可靠性,如何平衡规则化评分与模型判断的灵活性成为技术难点。数据规模的不均衡(如2024-08子集仅8个样本)进一步凸显了动态扩展中资源分配的挑战。
常用场景
经典使用场景
LiveBench作为多模态大语言模型(MLLM)的持续性评测基准,其经典使用场景在于对模型在真实网页环境下的视觉问答能力进行动态追踪。该数据集通过采集不同月份的网络截图与人工标注的问答对,构建了随时间演进的测试集,使得研究者能够评估模型在网页理解、图像推理与文本生成等任务上的时效性表现,尤其适用于衡量模型对新兴网络内容与复杂视觉场景的适应能力。
解决学术问题
该数据集有效解决了传统静态评测基准无法反映模型在真实互联网环境中性能动态变化的问题。学术研究中,MLLM常因训练数据与测试数据的时间错位导致评估失真,而LiveBench通过引入时间维度与持续更新的机制,提供了对模型泛化能力与鲁棒性的更可靠度量,推动了评测方法论从静态向动态演进的范式转变,其意义在于为领域内建立更贴近实际部署场景的评估标准。
衍生相关工作
基于LiveBench的持续评测框架,衍生了一系列关注模型时间泛化性的研究工作,包括动态基准构建方法、模型遗忘效应分析以及增量学习策略的评估。这些工作不仅拓展了多模态领域对模型生命周期管理的理解,还催生了诸如时序知识蒸馏与自适应评测协议等新方向,进一步巩固了LiveBench作为动态评估领域标杆数据集的地位。
以上内容由遇见数据集搜集并总结生成


