
davron04/wikimedia_v20230407_en_uz
收藏官方服务:
资源简介:
--- license: mit configs: - config_name: default data_files: - split: train path: "data/*.parquet" ---
提供机构:
davron04搜集汇总
数据集介绍
构建方式
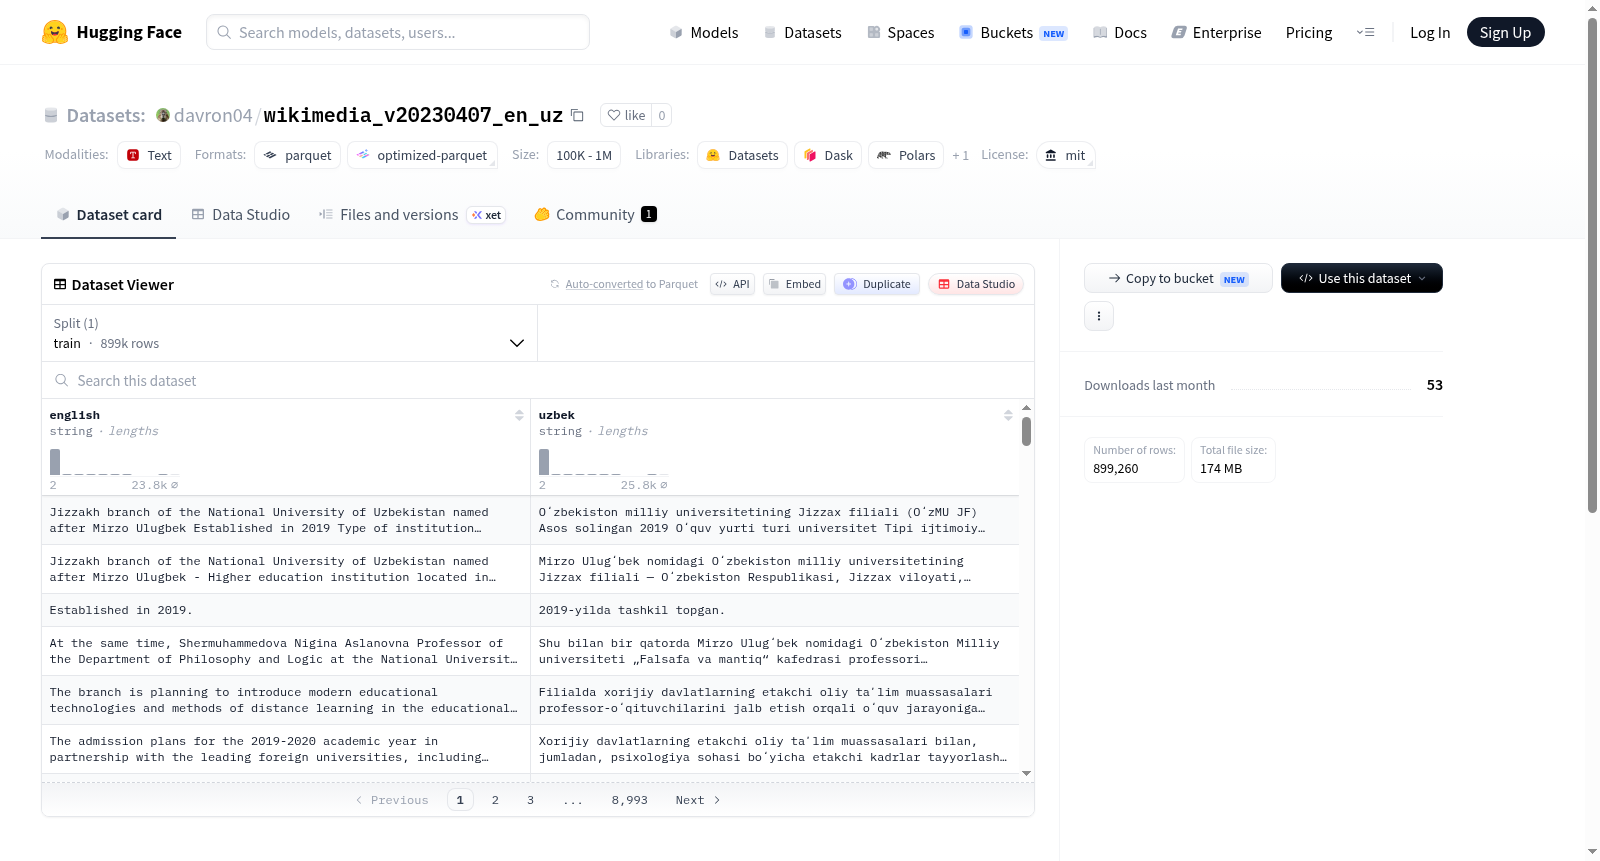
wikimedia_v20230407_en_uz数据集源自OPUS项目,由Jörg Tiedemann等人基于大规模多语言平行语料库构建而成。该数据集聚焦于英语与乌兹别克语之间的平行文本,通过从维基媒体平台提取并过滤高质量的双语对齐语料,以Parquet格式存储,便于高效读取与处理。数据仅包含训练集,文件路径统一为data/*.parquet,支持灵活的分布式加载。
特点
该数据集的核心特点在于其针对英语-乌兹别克语这一低资源语言对的专门设计,弥补了相关平行语料稀缺的空白。数据采用统一的Parquet列式存储格式,显著提升了数据压缩比与I/O性能,适配现代大数据处理框架。此外,数据集基于维基媒体社区的开放内容构建,确保了来源的多样性与广泛的领域覆盖,为机器翻译、跨语言信息检索等任务提供了可靠的基础资源。
使用方法
使用该数据集时,研究人员可通过HuggingFace Datasets库加载,只需指定数据集名称与配置名'default',系统即可自动从'data/*.parquet'路径读取训练数据。Parquet格式使得数据可直接与Apache Arrow、Pandas等工具集成,支持高效查询与预处理。建议配合OPUS工具包进行对齐质量评估,或直接用于训练序列到序列模型,结合分词器进行英语-乌兹别克语的双向翻译建模。
背景与挑战
背景概述
在自然语言处理与机器翻译领域,高质量并行语料库是训练神经机器翻译模型的核心资源。wikimedia_v20230407_en_uz数据集由赫尔辛基大学的Jörg Tiedemann及其OPUS项目团队于2012年创建,旨在为英语与乌兹别克语的低资源语言对提供大规模、多领域的平行文本。该数据集从维基媒体(Wikipedia、Wikibooks等)中提取并清洗,核心研究问题在于缓解低资源语言对中数据稀缺的瓶颈,推动乌兹别克语等中亚语言的机器翻译研究。其影响力在于,通过整合多源维基媒体内容,为跨语言信息检索、双语词典构建及机器翻译基准测试提供了标准化资源,促进了低资源语言领域的学术进展。
当前挑战
该数据集主要面临两大挑战。在领域问题层面,英语与乌兹别克语之间的语言结构差异显著(如乌兹别克语丰富的形态变化与英语的孤立语特征),导致机器翻译模型难以捕捉长距离依赖与形态句法对齐,且乌兹别克语语料中缺乏高质量标注数据,限制了监督学习的有效性。在构建过程中,从维基媒体抽取海量文本时需处理不同格式的页面(如Wikipedia、Wikibooks),面临文本对齐噪声、篇章结构不一致及内容冗余等难题;此外,乌兹别克语作为低资源语言,其拼写变体与拉丁-西里尔字母混合现象增加了语料清洗的复杂度,需依赖启发式规则与多语言对比过滤策略以保障平行句对质量。
常用场景
经典使用场景
wikimedia_v20230407_en_uz数据集是源自维基百科平台的大规模英语-乌兹别克语平行语料库,在神经机器翻译领域占据重要地位。研究者常将其作为跨语言迁移学习的基础资源,用于训练英语与乌兹别克语之间的双向翻译模型。该数据集凭借其庞大的语料规模与多领域覆盖特性,成为构建低资源语言翻译系统的经典基准,尤其在乌兹别克语这类资源匮乏语言的机器翻译研究中,发挥着无可替代的作用。
衍生相关工作
围绕该数据集,衍生了一系列经典工作,包括基于OPUS框架的跨语言嵌入研究与多语言预训练模型微调方法。研究者利用其构建了针对乌兹别克语的翻译质量评估基准,并催生了融合形态学特征的Transformer改进模型。此外,该数据集还与Tatoeba等评测任务联动,成为衡量中亚语言机器翻译进展的重要参照,极大丰富了低资源语言处理的技术栈。
数据集最近研究
最新研究方向
该数据集聚焦于维基百科中英语至乌兹别克语的平行语料库构建,为低资源语言神经机器翻译研究提供了关键数据支撑。在跨语言信息检索与多语言自然语言处理前沿领域,该数据集使研究者能够探索基于Transformer架构的翻译模型在形态丰富且数据稀缺语言对上的适应策略,尤其在零样本翻译与持续预训练技术中发挥重要作用。结合乌兹别克语拉丁化和西里尔字母转换规范化的热点事件,该数据集推动了低资源语言语料质量评估与对齐算法的优化,对促进中亚语言数字化与全球多语言信息无障碍传播具有深远意义。
以上内容由遇见数据集搜集并总结生成


