
MaLA-LM/FineOPUS-Original
收藏搜集汇总
数据集介绍
构建方式
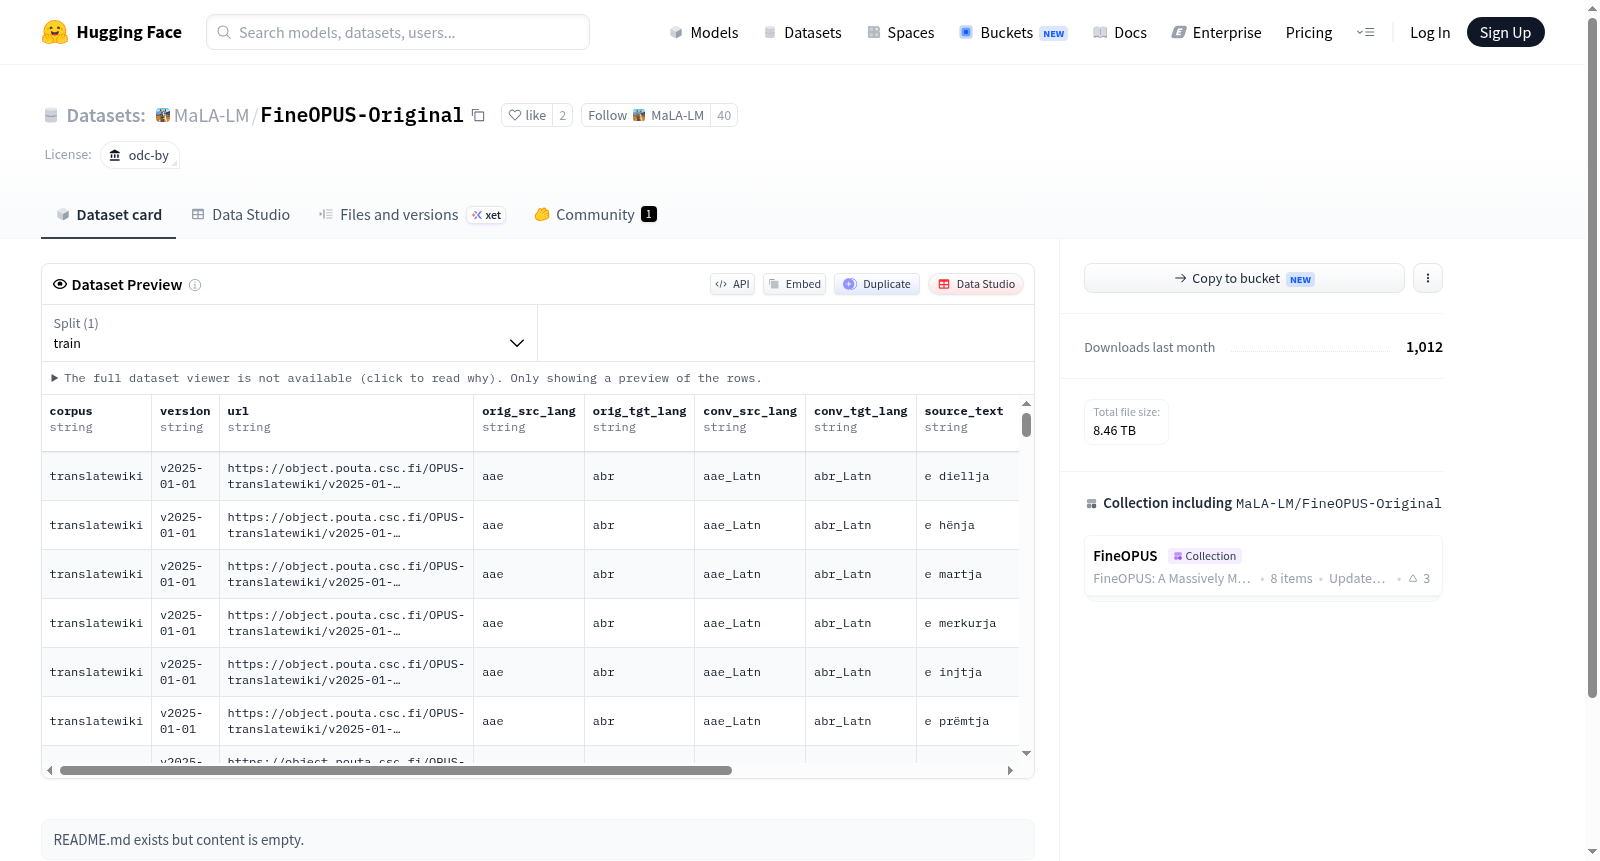
FineOPUS-Original数据集的构建基于OPUS(Open Parallel Corpus)项目,通过从多语种平行语料库中提取并精细化处理原始文本对而成。构建过程中,研究人员首先从OPUS的广泛资源中筛选出高质量的双语对齐语料,随后对其进行去噪、标准化和格式统一,确保每一对文本在语义和结构上保持高度一致。该数据集保留了原始语料的完整性和多样性,未经过额外的机器翻译或人工改写,从而为多语言自然语言处理任务提供了真实、未经修饰的平行数据。
特点
FineOPUS-Original数据集的核心特点在于其原始性和广泛的语言覆盖范围。它涵盖了数十种语言对,包括低资源语言,且每个文本对均源自真实世界的文档,如法律条文、科技手册和新闻报道,确保了数据的领域多样性和场景真实性。此外,数据集中的文本长度分布广泛,从短句到长段落均有涉及,有利于训练模型处理不同粒度的语言结构。其采用的ODC-BY开放许可进一步促进了学术和工业界的共享与使用,使之成为机器翻译、跨语言信息检索和双语词典构建等任务的理想资源。
使用方法
使用FineOPUS-Original数据集时,用户可以直接从Hugging Face平台加载,支持通过`datasets`库快速集成到现有工作流程中。具体地,研究人员可利用`load_dataset('FineOPUS-Original')`函数获取数据,并根据任务需求选择特定语言对或子集。数据集以`text_a`和`text_b`字段存储双语文本,便于直接用于训练序列到序列模型或进行对比学习。同时,建议用户在使用前对数据进行预处理,如分词和长度过滤,以适应特定模型的要求。
背景与挑战
背景概述
FineOPUS-Original数据集是由OPUS项目团队在机器翻译与平行语料库领域的重要贡献,其创建可追溯至早期多语言语料库构建的研究浪潮。该数据集专注于提供高质量、细粒度的原始平行句子对,核心研究问题在于克服传统语料库中噪音大、对齐粗糙的缺陷,为神经机器翻译模型提供更精准的训练资源。作为OPUS系列的核心组件,FineOPUS-Original通过人工校验与自动化清洗技术,显著提升了低资源语言对与专业领域翻译的基线表现,在WMT等国际评测中成为基准语料库之一,推动了多语言自然语言处理的实用化进程。
当前挑战
该数据集面临的核心挑战在于多语言环境下数据稀疏性与质量控制的平衡问题:一方面,覆盖数百种语言对导致部分语种对齐样本极度稀缺,模型易过拟合;另一方面,原始语料中残留的编码错误、未对齐片段及领域偏见需耗费大量计算资源清洗。构建过程中,技术难点包括跨语言命名实体歧义消除、学术性文本与口语化表达的混合标注策略,以及应对低资源语言词典匮乏时的人工校验成本,这些因素共同制约了语料库的通用性与扩展性。
常用场景
经典使用场景
FineOPUS-Original数据集在机器翻译与跨语言自然语言处理领域中扮演着基础性角色。其作为经过精细化对齐的双语平行语料库,最经典的使用场景是作为神经机器翻译模型的训练与评估基准。研究人员通过该数据集获取高质量、句子级别对齐的源语言与目标语言对,从而训练出具备良好泛化能力的翻译系统,特别是在资源相对匮乏的语言对之间,FineOPUS-Original提供的精细对齐数据能够有效缓解数据稀疏问题,提升翻译质量。
解决学术问题
该数据集解决了双语平行语料构建中普遍存在的对齐精度不足与噪声干扰问题。在学术研究中,质量低下的平行语料常导致翻译模型学习到错误映射,FineOPUS-Original通过精细化的对齐策略和严格的筛选流程,为跨语言语义等价性研究提供了可靠的数据基础。其意义在于推动了低资源机器翻译、多语言表示学习以及跨语言信息检索等方向的发展,使得学术界能够更深入地探究语言间的结构差异与共性,进而提升多语言系统的鲁棒性。
衍生相关工作
基于FineOPUS-Original数据集,研究人员衍生出多项经典工作,包括提出更高效的数据过滤与对齐算法,例如基于对比学习的双语语料去噪方法。该数据集还催生了针对特定领域的微调翻译模型,如将法律或医学双语数据从原始语料中分离并构建领域专用平行库。此外,一些研究将其与预训练语言模型结合,探索零样本翻译与跨语言迁移学习的边界,为多模态翻译和语音翻译等前沿方向奠定了实验基础。
以上内容由遇见数据集搜集并总结生成


