
遇见数据集

SEED-Data-Edit

收藏
arXiv2024-05-07 更新2024-06-21 收录
官方服务:

资源简介:

SEED-Data-Edit是由腾讯AI Lab和ARC Lab联合创建的混合数据集,专注于指令引导的图像编辑。该数据集包含三种类型的数据:自动化管道生成的高质量编辑数据、从互联网收集的真实世界场景数据以及由Photoshop专家标注的多轮编辑数据。数据集旨在通过大规模、多样化的图像编辑样本,促进语言引导的图像编辑模型的训练。SEED-Data-Edit不仅支持单次编辑,还支持多轮迭代编辑,模拟真实世界中的编辑过程,适用于提升图像编辑技术的实用性和精确性。

SEED-Data-Edit is a hybrid dataset jointly created by Tencent AI Lab and ARC Lab, focusing on instruction-guided image editing. This dataset includes three types of data: high-quality edited data generated via automated pipelines, real-world scene data collected from the Internet, and multi-round edited data annotated by Photoshop experts. The dataset aims to facilitate the training of language-guided image editing models through large-scale and diverse image editing samples. SEED-Data-Edit supports not only single-turn editing but also multi-round iterative editing, simulating real-world editing processes, and is suitable for enhancing the practicality and accuracy of image editing technologies.
提供机构:
腾讯AI Lab
创建时间:
2024-05-07
搜集汇总
数据集介绍
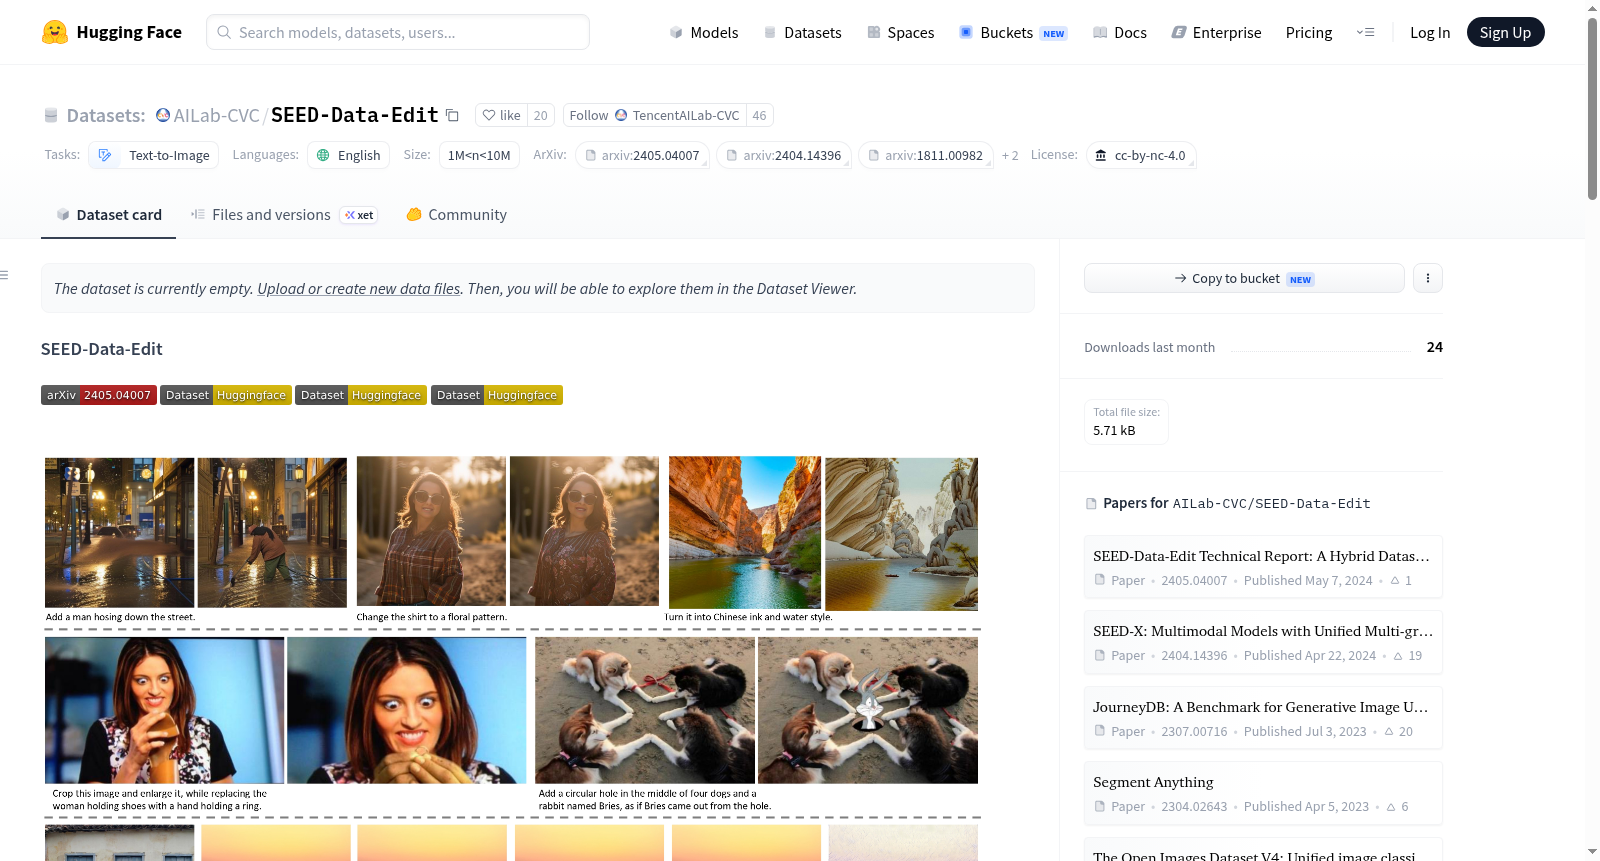
SEED-Data-Edit 数据集图片
构建方式
SEED-Data-Edit的构建融合了三条互补的路径,旨在全面覆盖指令引导图像编辑的多样性需求。第一部分通过自动化流水线生成大规模编辑样本:一条流水线利用LLaVA-1.5识别可移除物体,结合GroundingDino与SAM进行分割,再以LaMa模型完成修复,从而产生“移除”与反向生成的“添加”编辑对;另一条流水线借助ChatGPT生成编辑指令与目标描述,并利用PnP模型基于原始图像与描述生成源图与目标图,经CLIP相似度过滤后,共获得约350万对高质量编辑数据。第二部分从互联网论坛爬取业余摄影师发布的编辑请求与Photoshop专家完成的编辑结果,并由人工重新标注指令,最终汇集52K反映真实用户意图的编辑样本。第三部分由Photoshop专家对真实图像执行最多五轮的多轮编辑操作,记录每轮指令,涵盖物体替换、添加、移除、动作更改等六类修改,生成95K多轮编辑对与21K编辑序列。
使用方法
SEED-Data-Edit主要用于微调多模态大语言模型以执行指令引导的图像编辑任务。研究者可基于预训练模型(如SEED-X)加载本数据集,采用LoRA等高效微调技术在16张A100-40G GPU上训练约40小时,使模型学会理解源图像与语言指令的联合输入,并生成符合编辑要求的目标图像。使用时需注意,多轮编辑数据在训练中可被拆解为单轮样本处理,以简化学习过程;同时,由于SEED-X的视觉解码器已在SEED-Data-Edit上预训练,模型能够更好地保留源图像的细粒度细节,适用于高精度编辑场景。数据集已开源至Hugging Face,用户可直接下载并整合至自己的训练流程。
背景与挑战
背景概述
指令引导图像编辑作为计算机视觉与自然语言处理交叉领域的前沿方向,旨在通过开放形式的语言指令实现灵活的图像操控,显著提升了图像编辑的可控性与实用性。然而,现有数据集普遍面临规模有限、真实场景覆盖不足以及多轮编辑能力欠缺等瓶颈。在此背景下,腾讯AI实验室与ARC Lab的研究团队于2024年联合发布了SEED-Data-Edit数据集,该数据集由Yuying Ge、Sijie Zhao、Chen Li等人主导创建,核心研究问题在于构建一个高质量、大规模且多源异构的混合数据集,以推动语言引导图像编辑模型的训练与泛化。SEED-Data-Edit创新性地融合了自动化流水线生成的大规模编辑样本、从互联网爬取的真实用户场景数据以及由Photoshop专家标注的高精度多轮编辑数据,总量达370万对编辑样本与2.1万条多轮编辑序列,为领域内提供了迄今为止最为全面的训练资源,对提升模型在复杂指令理解与精细编辑执行方面的能力具有里程碑式的影响。
当前挑战
SEED-Data-Edit所应对的核心挑战首先在于指令引导图像编辑领域长期存在的数据稀缺与质量问题。现有数据集如InstructPix2Pix依赖模型生成图像,缺乏真实感;MagicBrush虽引入人工标注但规模仅万余对;HQ-Edit则因生成过程无法保证源图细节保留而影响编辑精度。SEED-Data-Edit通过三源混合策略直面这一困境:自动化流水线需解决对象添加时位置合理性与视觉连贯性的难题,为此采用“移除-反转”策略生成“添加”样本;真实场景数据面临用户意图复杂多样、指令与编辑结果一致性难以保障的挑战,故采用人工重标注确保质量;多轮编辑数据则需模拟迭代编辑过程中的逻辑连贯性与操作累积效应,Photoshop专家需在多达五轮的编辑序列中精确记录每轮指令,确保模型能够学习到从简单到复杂的逐步编辑能力。
常用场景
经典使用场景
在指令引导的图像编辑领域,SEED-Data-Edit被广泛用于训练能够根据自然语言指令精准操控图像内容的模型。其经典使用场景涵盖对图像进行对象添加、移除、风格转换、颜色修改、材质替换以及多轮迭代编辑等任务。该数据集通过融合自动化流程生成的大规模编辑对、反映真实用户意图的互联网场景数据以及专家标注的高精度多轮编辑样本,为模型提供了丰富且多样的训练素材,使其能够学习从简单指令到复杂语义变更的广泛编辑能力。
解决学术问题
SEED-Data-Edit有效解决了指令引导图像编辑研究中长期存在的高质量、大规模训练数据匮乏的难题。现有数据集如InstructPix2Pix仅包含单轮模型生成图像,缺乏真实感与多轮交互能力;而MagicBrush虽引入人工标注但规模有限。该数据集通过整合三种异质数据源,提供了超过360万对编辑样本,覆盖了从基础对象操作到复杂风格迁移的多样化编辑类型,显著提升了模型对语言指令的细粒度理解与执行精度,为多模态大语言模型在图像编辑领域的应用奠定了坚实基础。
实际应用
在实际应用中,SEED-Data-Edit驱动的图像编辑模型可被集成至各类创意工具与设计平台,赋能用户以自然语言进行直观的图像修改。例如,摄影师可通过简单指令调整照片风格或移除干扰元素;设计师能快速替换产品背景或改变材质;社交媒体用户则能轻松为图片添加趣味元素或转换艺术风格。此外,该数据集支持的多轮编辑特性使其适用于需要逐步精修的专业工作流,如广告海报迭代设计与影视后期处理,极大降低了图像编辑的技术门槛。
数据集最近研究
最新研究方向
在指令引导的图像编辑领域,SEED-Data-Edit的提出标志着一个重要的转折点,它通过融合自动化流水线生成的大规模编辑样本、真实世界场景的用户编辑数据以及Photoshop专家标注的多轮迭代编辑数据,构建了一个前所未有的混合型数据集。这一创新设计不仅解决了现有数据集在规模、真实性和多轮编辑能力上的不足,还推动了多模态大语言模型在图像编辑中的精准理解与生成能力。该数据集与SEED-X模型结合后,展示了在复杂编辑指令如风格转换、对象增删与背景替换上的卓越表现,为图像编辑从实验室走向实际应用铺平了道路,同时也为未来研究如何更自然地模拟人类编辑意图和迭代过程提供了重要基础。
相关研究论文
  • 1
    SEED-Data-Edit Technical Report: A Hybrid Dataset for Instructional Image Editing腾讯AI Lab · 2024年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

