
遇见数据集

stockmatch-synthetic

收藏
Hugging Face2026-08-04 更新2026-08-05 收录
官方服务:

资源简介:

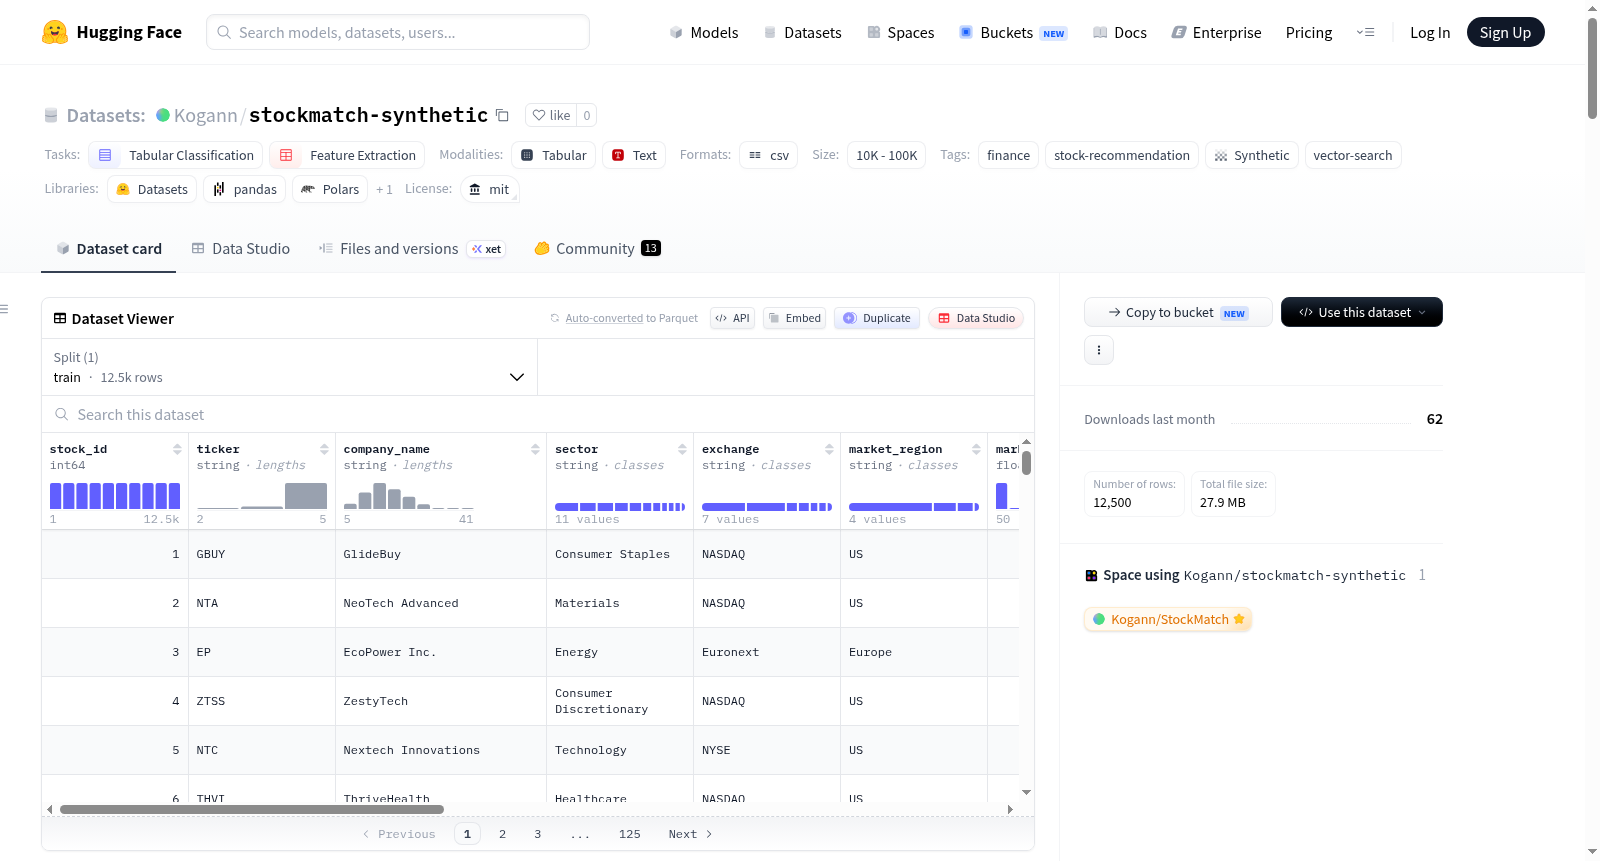
StockMatch Synthetic Dataset 是一个合成的股票档案数据集,包含 12,500 个样本,专门用于构建基于 AI 的股票推荐系统。每个样本融合了关键的数值财务指标与由 Qwen2.5 大型语言模型生成的业务摘要文本。数据集经过探索性数据分析(EDA)处理:移除了内部行索引(stock_id)和公司全名(company_name),仅保留 ticker 作为唯一标识;所有特征均无缺失值;数值分布中虽存在市场自然极端值,但无完全不可能或损坏的值;每行具有唯一的 ticker 符号,确保股票实体的唯一性。该数据集适用于表格分类、特征提取、股票推荐、向量搜索等任务,数据规模在 10,000 到 100,000 条之间,采用 MIT 许可证。

StockMatch Synthetic Dataset is a synthetic stock profile dataset containing 12,500 samples, specifically designed for building AI-based stock recommendation systems. Each sample integrates key numerical financial indicators with business summary texts generated by the Qwen2.5 large language model. The dataset has undergone exploratory data analysis (EDA) processing: internal row indices (stock_id) and company full names (company_name) have been removed, leaving only ticker as the unique identifier; all features have no missing values; although there are market natural extreme values in numerical distributions, there are no completely impossible or corrupted values; each row has a unique ticker symbol, ensuring the uniqueness of stock entities. The dataset is suitable for tasks such as tabular classification, feature extraction, stock recommendation, and vector search, with a data size between 10,000 and 100,000 entries, and is licensed under the MIT license.

创建时间:
2026-08-02
原始信息汇总

StockMatch Synthetic 数据集详情

数据集概述

该数据集包含 12,500 个合成股票档案,专为构建 AI 驱动的股票推荐系统而设计。数据集将关键的数值财务指标与 LLM 生成的业务摘要(使用 Qwen2.5 模型)相结合。

数据集信息

  • 许可证:MIT
  • 任务类别:表格分类、特征提取
  • 标签:金融、股票推荐、合成、向量搜索
  • 数据规模:10K < n < 100K

数据探索与清洗摘要

1. 无关列移除

移除了内部行索引(stock_id)和完整公司名称(company_name)等非必要标识符,保留 ticker 作为主要唯一标识符。

2. 缺失值检查

对所有特征进行了缺失值检查,结果显示 0 缺失值。这符合市场预期,因为基本面股票市场数据是公开且普遍可获取的。

3. 异常值与极端值分析

分析了数值分布的异常情况。虽然存在自然的市场极端值(例如,高增长科技股与低贝塔公用事业股),但未发现完全不可能或损坏的值。

4. 重复记录检查

检查了重复记录。虽然自动生成的公司名称存在轻微重叠,但每一行都拥有 唯一的 ticker 符号,确保了股票实体的独特性。

包含文件

  • data_science_FP_updated.ipynb:完整 notebook,包含数据生成、EDA、可视化、Embedding 基准测试、FAISS 索引和生成流程。
搜集汇总
数据集介绍
stockmatch-synthetic 数据集图片
构建方式
该数据集面向智能股票推荐系统的研发,整合了数值型财务指标与由Qwen2.5大语言模型生成的业务摘要,构建了12,500条合成的股票档案。在构建过程中,通过探索性数据分析,系统性地移除了诸如内部行索引和公司全名等非核心标识,仅保留ticker作为唯一识别符。数据完整性检查显示所有特征均无缺失值,且经过异常值和重复记录审查,确认每条数据具有独一无二的股票代码,确保了数据集的清洁度与实体唯一性。
使用方法
使用上,该数据集可支撑表格分类与特征提取任务,尤其适用于构建基于向量搜索的推荐系统。研究者可基于提供的Notebook进行嵌入模型比较,选择最优模型将股票描述转换为向量,进而利用FAISS构建高效索引,实现相似股票检索或聚类分析。数据集的MIT许可证允许灵活的学术与商业应用,降低了使用门槛。
背景与挑战
背景概述
StockMatch Synthetic 数据集诞生于金融科技与人工智能交叉领域的前沿探索,由研究团队于2023年基于Qwen2.5大语言模型生成。该数据集包含12,500条合成股票档案,旨在为构建AI驱动的股票推荐系统提供结构化训练与评估基础。其核心研究问题聚焦于如何通过整合数值财务指标与语义化业务摘要,提升推荐算法对股票本质特征的捕捉能力。数据集在HuggingFace平台发布后,凭借其合成数据的灵活性与可扩展性,迅速成为金融领域研究社区的重要资源,推动了向量检索、聚类分析及嵌入模型评估等方向的发展,尤其在数据稀缺场景下为模型预训练与特征工程提供了新颖的基准。
当前挑战
该数据集所解决的领域问题在于,真实股票数据往往涉及隐私、时滞与高噪声,难以支撑大规模监督学习,而合成数据虽缓解了可得性,却引入了真实性与泛化性的根本挑战。构建过程中,团队需在模拟市场极端值(如高增长科技股与低波动公用事业股)的同时确保无离群腐蚀,并在去除无关标识符后维持数据完整性。此外,尽管自检显示零缺失值,生成式模型可能隐含语义偏差,需通过聚类与嵌入比较来验证合成股票间的区分度,这要求精细的清洗策略与鲁棒的评估框架,以平衡数据多样性与推荐系统的实用可信度。
常用场景
经典使用场景
StockMatch-Synthetic数据集以12,500条合成股票档案为核心,融合了关键财务指标与大语言模型生成的业务摘要,为金融科技领域的智能投顾系统构建提供了理想的实验场。该数据集最经典的使用场景聚焦于表格分类任务,研究者可基于数值型财务特征与文本摘要特征,训练分类模型以区分不同风险偏好或行业属性的股票类型。此外,它亦广泛用于特征提取研究,通过对比不同嵌入模型在股票业务摘要上的表示学习能力,探索如何将非结构化文本转化为高维向量,从而支撑下游的信息检索与相似股票匹配任务。该数据集的合成性质保证了实验环境的可控性与可重复性,便于研究者快速迭代模型架构,因而成为金融自然语言处理与机器学习交叉领域的重要基准资源。
解决学术问题
在学术研究领域,StockMatch-Synthetic数据集有效应对了金融数据获取困难且标注成本高昂的长期挑战。真实股票数据通常涉及隐私、商业授权和时变性,导致研究复现难度大,而该数据集的合成生成策略提供了规范化、无缺漏且无重复的干净数据源,解决了数据清洗和预处理的常见痛点。它支持对缺失值处理、异常值检测以及数据去重等方法的系统验证,促使研究者聚焦于算法本身的创新而非繁琐的数据工程。更为关键的是,数据集内嵌的LLM生成文本为跨模态学习研究提供了契机,推动了对金融语义理解、文本与数值特征融合以及嵌入模型选择等课题的深入探索,从而为金融AI领域的可复现性研究树立了新的标杆。
实际应用
实际应用中,StockMatch-Synthetic数据集直接服务于构建智能化股票推荐引擎的原型设计与评估。开发者可借助该数据集训练多种机器学习模型,生成个性化的股票推荐列表,并利用FAISS等向量检索技术实现近似最近邻搜索,大幅提升推荐响应速度。数据集覆盖广泛的市场极端情形(如高增长科技股与低波动公用事业股),使得推荐系统能够在多样化的投资风格中进行泛化测试。此外,该数据集也适用于金融机构的量化研究部门,作为算法交易策略中的特征工程和模型验证的沙盘,帮助团队在模拟环境中检验投资组合优化算法,降低实盘试错成本。其MIT许可协议进一步降低了商业应用的法律门槛,促进技术向实际产品的快速转化。
数据集最近研究
最新研究方向
在金融科技与人工智能深度融合的浪潮中,StockMatch Synthetic数据集以其精巧的合成数据设计,为智能投顾领域的前沿探索提供了崭新锚点。该数据集巧妙融合了结构化财务指标与由Qwen2.5生成的非结构化业务摘要,构建了12,500个独特的股票画像,契合了当下多模态数据融合与检索增强生成在金融决策中的研究热点。其研究价值不仅体现在通过生成式AI构建高质量训练样本以缓解真实数据稀缺性,更在于结合FAISS向量索引和嵌入模型评估,开创了一条从数据清洗、特征工程到语义检索的完整研究范式。这一精细化的数据构建流程,对于推动可解释、高性能的股票推荐系统,乃至更广泛的金融大模型应用,均具有重要的示范意义与先导价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

