verl_vla_libero_collected
收藏资源简介:
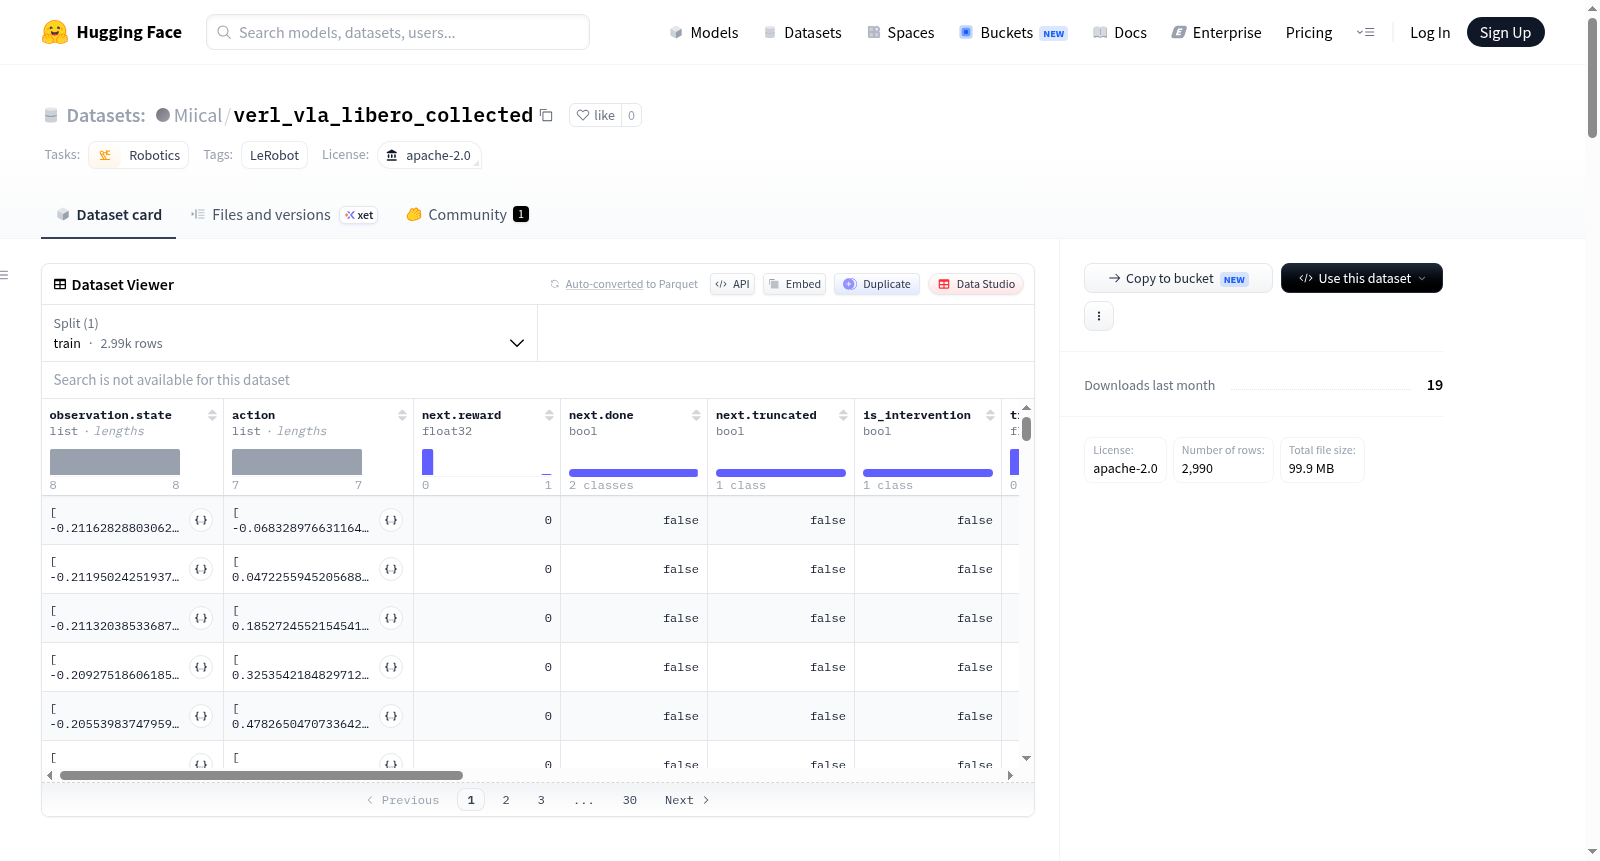
该数据集是一个使用LeRobot工具创建的机器人演示数据集,包含32个训练episodes,共计2990帧数据,帧率为10fps,以Parquet格式存储,总大小约100MB,采用Apache-2.0许可证。数据内容包含多模态观测和对应的机器人动作:观测部分包括两个视角的RGB视频(图像和腕部图像,分辨率均为256x256x3)以及一个8维的机器人状态向量;动作是一个7维的连续控制向量。每个数据点还包含奖励信号(next.reward)、episode完成标志(next.done)、截断标志(next.truncated)、人工干预标志(is_intervention)以及时间戳和各类索引(如帧索引、episode索引)。此外,数据集提供了一些用于强化学习的recap字段,包括回报(return)、价值估计(value)、优势函数(advantage)和指示器(indicator)。该数据集适用于机器人强化学习、模仿学习或行为克隆等任务,可用于训练从多模态观测(视觉+状态)到连续动作的映射策略。
This dataset is a robot demonstration dataset created using the LeRobot tool. It contains 32 training episodes, totaling 2990 frames of data at a frame rate of 10fps, stored in Parquet format with a total size of approximately 100MB, and is licensed under Apache-2.0. The data includes multimodal observations and corresponding robot actions: the observation part consists of two-view RGB videos (image and wrist image, both with a resolution of 256x256x3) and an 8-dimensional robot state vector; the action is a 7-dimensional continuous control vector. Each data point also includes reward signals (next.reward), episode completion flags (next.done), truncation flags (next.truncated), human intervention flags (is_intervention), as well as timestamps and various indices (such as frame index and episode index). Additionally, the dataset provides some recap fields for reinforcement learning, including return, value estimation, advantage function, and indicator. This dataset is suitable for tasks such as robot reinforcement learning, imitation learning, or behavior cloning, and can be used to train mapping policies from multimodal observations (visual + state) to continuous actions.
数据集概述
- 名称:
verl_vla_libero_collected - 许可证: Apache-2.0
- 任务类别: 机器人学 (robotics)
- 标签: LeRobot
- 创建工具: 使用 LeRobot 创建
数据集规模
| 指标 | 数值 |
|---|---|
| 总片段数 (episodes) | 32 |
| 总帧数 (frames) | 2990 |
| 总任务数 (tasks) | 1 |
| 帧率 (fps) | 10 |
| 数据文件大小 | 100 MB |
| 视频文件大小 | 约 0 MB |
| 数据划分 | 训练集: 片段 0 到 31 |
机器人类型
- 机器人型号: panda
数据特征
数据集包含以下特征字段,每个字段的类型、形状和说明如下:
| 特征字段 | 数据类型 | 形状 | 说明 |
|---|---|---|---|
observation.images.image |
video | (256, 256, 3) | 主摄像头图像,分辨率 256x256,RGB 3通道,AV1编码,帧率10fps |
observation.images.wrist_image |
video | (256, 256, 3) | 腕部摄像头图像,分辨率 256x256,RGB 3通道,AV1编码,帧率10fps |
observation.state |
float32 | (8,) | 机器人状态,8维向量 |
action |
float32 | (7,) | 动作指令,7维向量 |
next.reward |
float32 | (1,) | 下一个时间步的奖励 |
next.done |
bool | (1,) | 下一个时间步是否结束 |
next.truncated |
bool | (1,) | 下一个时间步是否被截断 |
is_intervention |
bool | (1,) | 是否为人机干预帧 |
timestamp |
float32 | (1,) | 时间戳 |
frame_index |
int64 | (1,) | 帧索引 |
episode_index |
int64 | (1,) | 片段索引 |
index |
int64 | (1,) | 全局索引 |
task_index |
int64 | (1,) | 任务索引 |
recap.return |
float32 | (1,) | 累积回报 |
recap.value |
float32 | (1,) | 状态价值 |
recap.advantage |
float32 | (1,) | 优势函数 |
recap.indicator |
int64 | (1,) | 指示器 |
数据文件结构
- 数据路径:
data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet(分块parquet文件) - 视频路径:
videos/{video_key}/chunk-{chunk_index:03d}/file-{file_index:03d}.mp4(分块MP4视频文件) - 元数据文件:
meta/info.json包含上述所有描述信息