
Turkce-istatistik-reasoning
收藏官方服务:
资源简介:
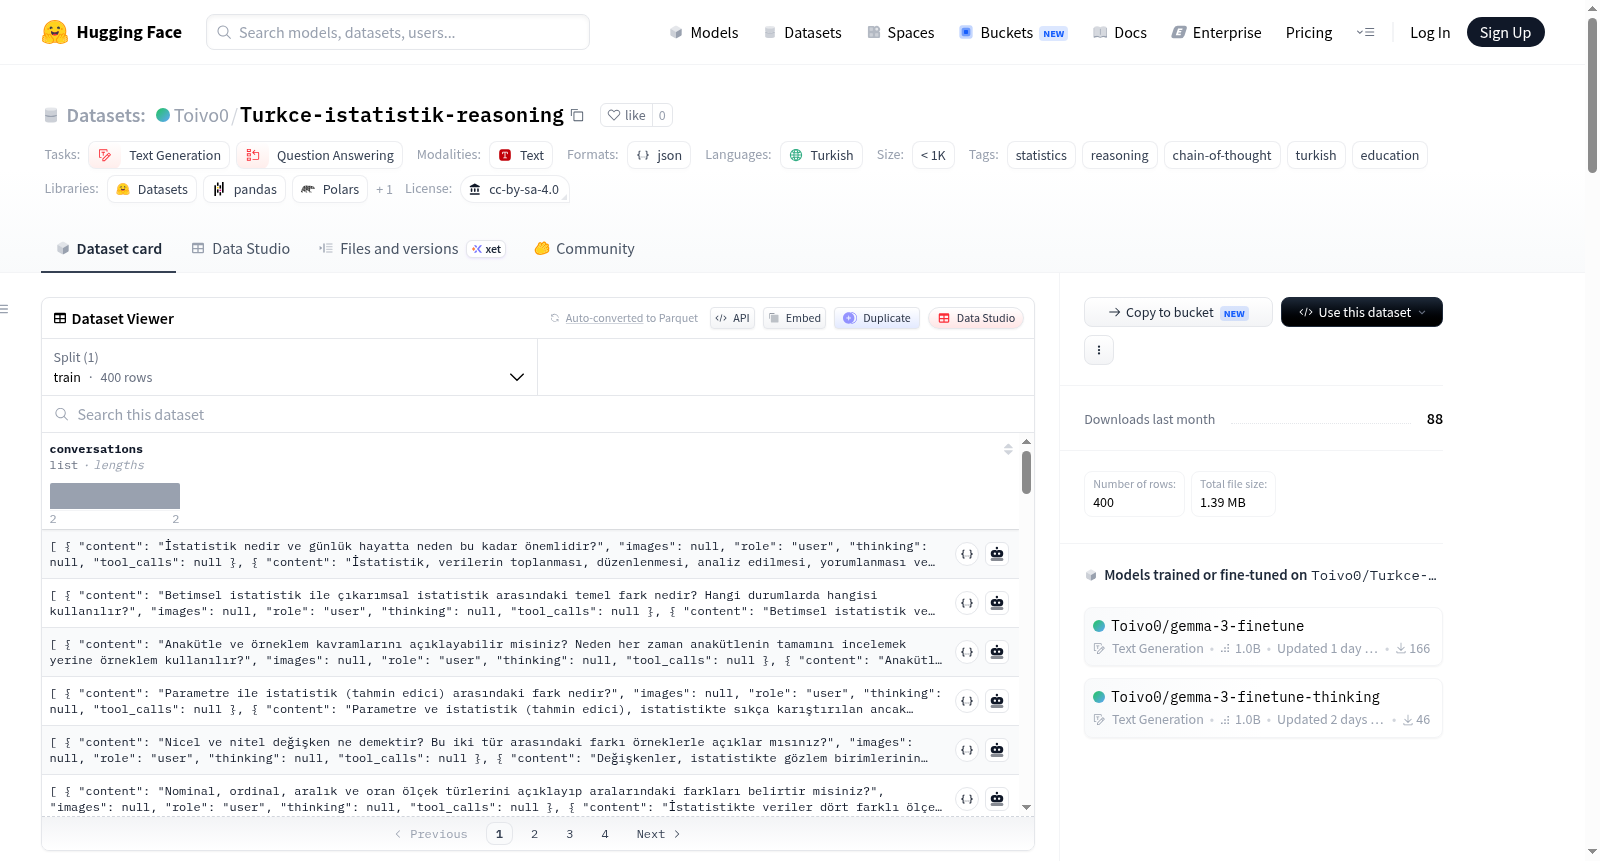
Türkçe İstatistik Muhakeme (Chain-of-Thought) Veri Seti 是一个用于微调的土耳其语统计推理数据集,其特点是包含了思维链(chain-of-thought)标注。数据集采用问答对话格式,专门设计用于提升模型在统计领域的推理能力。数据集共包含400个高质量样本,覆盖了统计学的7个核心模块:统计学基础、描述性统计、概率、概率分布、抽样与估计、假设检验以及回归与相关性。每个样本由一段对话组成,包含一个用户问题和一个助手回答。助手回答不仅提供最终答案,还包含一个详细的、以自然内部独白形式呈现的推理过程(标注在`thinking`字段中),清晰展示了从问题到答案的思维路径。数据样本具有精细的标注:每个问题都标有难度等级(简单、中等、高级)和问题类型(概念性、解释性、陷阱/误解类)。数据以标准化的JSON格式存储,便于直接用于模型训练。数据集遵循CC-BY-SA-4.0许可协议。该数据集适用于需要复杂推理的文本生成和问答任务,特别是针对土耳其语教育、统计知识普及和模型推理能力微调等场景。已知的限制是当前版本不包含数值计算类问题,且不同模块间可能存在轻微的术语不一致。
创建时间:
2026-07-21
搜集汇总
数据集介绍
构建方式
该数据集针对土耳其语统计学教育领域,通过人工构建方式精心设计了400个高质量问答对。每个样本采用对话结构,包含用户提问与助手回答两部分,其中助手回答不仅呈现最终答案,还融入了自然连贯的内部思维链(thinking),模拟人类逐步推理的过程。数据集覆盖统计学基础、描述性统计、概率论、概率分布、抽样与估计、假设检验、回归与相关七大知识模块,每个模块均分配了均衡的题目数量。问题类型被系统划分为概念性、解释性与陷阱/误区三类,并依据认知难度分为简单、中等、高级三个层次,其中中等难度题目占据主导地位,占比53%,形成了合理的难度梯度。
特点
该数据集的核心特色在于其专门针对土耳其语统计学推理能力的培养而设计,具有鲜明的教育导向性。数据集中约47%为概念性问题,32.3%为解释性问题,20.8%为陷阱/误区纠正题,这种比例配置有效覆盖了从知识巩固到批判性思维的多维度训练需求。思维链并非采用刻板编号模板,而是以自然内心独白形式呈现,真实还原了人类解答统计学问题时的认知轨迹。此外,数据集采用CC-BY-SA-4.0许可协议,确保了学术研究与模型微调的开放共享性。
使用方法
使用该数据集时,推荐借助HuggingFace的datasets库进行加载,通过load_dataset函数即可便捷获取训练集。用户可根据具体微调目标灵活处理数据:若旨在提升模型的推理透明度,可将thinking字段作为输入特征参与训练;若仅关注最终答案生成,则可忽略该字段。典型的使用范例为将conversations中的角色与内容字段提取,转化为标准的messages格式,适配各类对话模型的微调框架。值得注意的是,当前版本不包含数值计算类问题,且术语可能存在模块间细微不一致,用户在使用时应予以关注。
背景与挑战
背景概述
在自然语言处理与教育技术交叉融合的浪潮中,针对低资源语言的高质量推理数据集显得尤为珍贵。土耳其语统计推理数据集(Türkçe İstatistik Muhakeme)于2024年由研究者Umut Kıvanç Sipahioğlu创建,旨在填补土耳其语在统计推理领域缺乏链式思考(Chain-of-Thought)标注数据的空白。该数据集包含400个精心设计的问题,覆盖从基础统计到回归分析的七大模块,并通过概念性、解释性和陷阱/谬误三类问题类型,全面评估模型的统计理解与推理能力。其在HuggingFace平台发布后,为土耳其语教育场景下的模型微调提供了标准化基准,推动了多语言推理模型的均衡发展。
当前挑战
该数据集所解决的领域问题在于,主流统计推理数据集多集中于英语等高资源语言,导致土耳其语大模型在统计问答任务中缺乏有效的监督训练信号,难以生成连贯的推理过程。构建过程中面临的核心挑战包括:一、如何设计同时涵盖概念理解、结果解释及常见谬误纠正的多元化问题,确保覆盖统计认知的完整维度;二、如何以自然流畅的土耳其语编写内部思维链,避免模板化或机械化的推理模式;三、当前版本尚不包含计算类问题,且术语在模块间存在轻微不一致,限制了其在复杂数值推理场景中的应用。
常用场景
经典使用场景
在自然语言处理与计算教育的交叉领域,Turkce-istatistik-reasoning数据集为土耳其语统计推理能力的训练与评估提供了精致的基准资源。该数据集包含400条精心构造的对话样本,每个样本均以用户提问与助手回答的双轮对话形式呈现,尤其珍贵的是,助手回答中嵌入了完整的思维链(chain-of-thought)内部推理过程。这些样本系统覆盖了统计学七大核心模块——从描述性统计、概率论到假设检验与回归分析,并依据认知深度划分为概念性、解释性与陷阱/谬误三种题型,且横跨简单、中等与高级三种难度层级。研究者常利用该数据集对大型语言模型进行指令微调或上下文学习(in-context learning)实验,旨在提升模型在土耳其语语境下进行逻辑严密、步骤清晰的统计推理能力,尤其关注模型是否能够像人类一样,在给出最终答案前进行内在的、逐步的反思与推导。
解决学术问题
该数据集直面当前多语言自然语言推理研究中的一个显著缺口——非英语典型语种中复杂推理能力的评测与增强问题。长期以来,统计推理基准多集中于英文,使得面向土耳其语等低资源语言的大模型在逻辑性、精确性与可解释性推理任务上缺乏系统评估手段。Turkce-istatistik-reasoning通过提供涵盖七大学术模块、三种认知维度的细粒度标注数据,有效解决了如何量化并提升模型在统计学这一高度结构化知识领域内进行多步推理的难题。其独特的陷阱/谬误题型(Tuzak/Yanılga)尤其具有学术价值,允许研究者深入检验模型是否能够识别并规避常见的统计误解与认知偏差,从而推动对模型推理稳健性与忠实性的理论研究。此外,该数据集的发布也促进了多语言少样本学习与跨语言迁移学习领域的发展,为构建真正具备普适性逻辑推理能力的语言智能系统提供了关键数据支撑。
衍生相关工作
Turkce-istatistik-reasoning数据集的构建与发布,催生了一系列紧密相关的开创性工作与研究脉络。首先,其独特的思维链(chain-of-thought)标注格式为土耳其语自然语言处理领域提供了首个系统化推理范例,由此衍生出大量针对统计思维链提示(prompting)策略的研究,探索在不同难度层级与题型下,是否应显式使用思考(thinking)字段进行微调以最大化模型推理表现。其次,该数据集所采用的三类问题划分(概念性、解释性、陷阱/谬误)被后续研究采纳并扩展至数学、物理等其他学科,形成了跨学科的多模态推理基准体系。基于该数据集的模型检查点(如使用此数据微调的土耳其语Llama或Mistral变体)被广泛应用于后续的指令遵循能力评测中,并与国际知名的推理基准(如GSM8K)进行对比,推动了低资源语言推理能力泛化瓶颈的深入分析。更有学者以此为基础,收集并标注了包含数字计算环节的扩展版本,以弥补原始版本缺少数值计算问题的局限,从而构建出更全面的土耳其语统计推理评测套件。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


