
遇见数据集

Stop-Piramida Video Dataset

收藏
github2026-06-13 更新2026-06-14 收录
官方服务:

资源简介:

这是一个可重现的视频数据集包,用于反欺诈、媒体监控和证据导向分析任务,基于来自Stop-Piramida.kz的593个公共视频。数据集包含元数据层、媒体层和辅助元数据层,支持语音识别、OCR、实体提取等下游应用。

This is a reproducible video dataset package for anti-fraud, media monitoring and evidence-driven analysis tasks, consisting of 593 public videos sourced from Stop-Piramida.kz. The dataset includes a metadata layer, a media layer and an auxiliary metadata layer, supporting downstream applications such as speech recognition, OCR and entity extraction.

创建时间:
2026-06-13
原始信息汇总

数据集概述:Stop-Piramida Video Dataset Package

这是一个面向反欺诈、媒体监控和证据分析的可复现视频数据集包,包含来自 Stop-Piramida.kz 的 593 个公开视频。

数据集统计

  • 元数据记录数: 593
  • 维护者本地下载数: 590
  • 已知缺失数: 3
  • 数据来源: https://stop-piramida.kz/videos

数据集架构

数据集采用分层结构组织,便于复现:

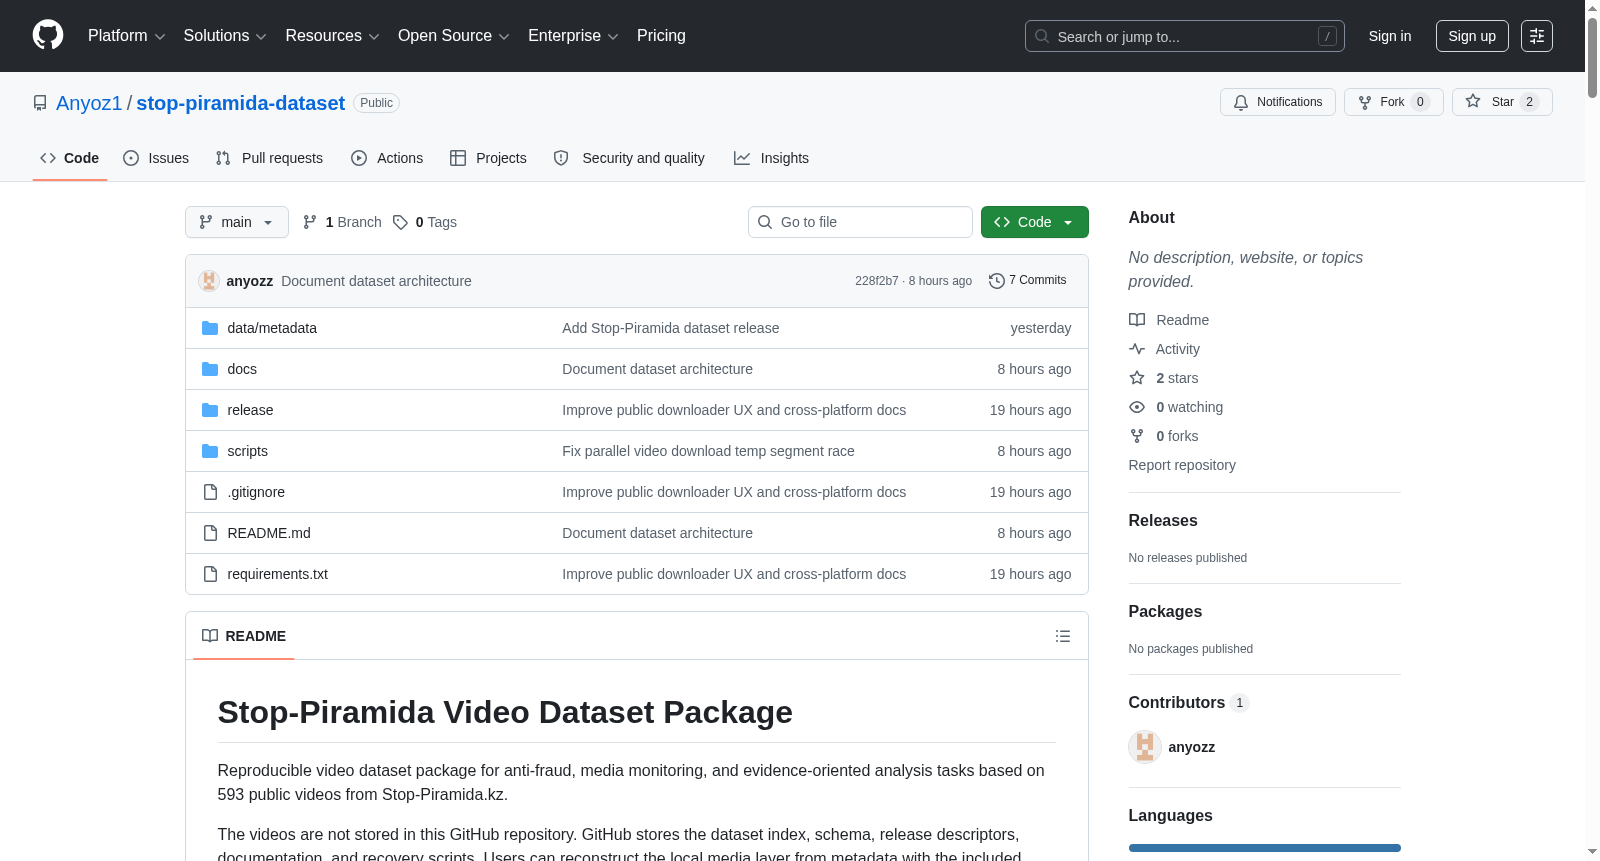
  • 元数据层 (data/metadata/): 存储于 GitHub 的主要数据集索引,核心文件为 data/metadata/all_videos.jsonl
  • 媒体层 (outputs/videos/<category>/<vimeo_id>.mp4): 最终下载的视频,不存储于 GitHub,用户可使用下载器从元数据层重建。
  • Sidecar 元数据层 (outputs/videos/<category>/<vimeo_id>.json): 描述单个下载视频的本地 JSON 文件,包含来源页面、Vimeo ID、类别、路径、状态及技术校验信息。
  • 原始/临时层 (data/raw/segments/, data/raw/failed_segments/): 包含中间 DASH 分段和故障调试产物,不推送至 GitHub。
  • 发布层 (release/): 用于发布或传输数据集包,包含 videos.csvmissing_videos.txtvideos.sha256 等文件。

规范数据集索引

规范数据源为 data/metadata/all_videos.jsonl,每行对应一个视频,记录类别、Vimeo ID、标题、来源页面 URL 和 Vimeo URL。

类别结构

类别对应 Stop-Piramida 视频库的版块,元数据和本地视频均采用基于类别的组织结构,例如 data/metadata/fishing.jsonl 对应 outputs/videos/fishing/<vimeo_id>.mp4

数据集可复现性

GitHub 仅存储元数据、模式、脚本、文档和发布描述符,不存储 MP4 文件。用户可克隆仓库并本地重建媒体层。

预期下游用途

  • Whisper ASR / 语音转文字
  • 视频帧 OCR
  • 实体提取(电话、URL、Telegram 用户名、域名、促销码、金额、加密钱包)
  • 欺诈场景检测
  • 媒体监控
  • 反欺诈证据报告

使用要求

  • 环境: Python 3.10+,Chromium 或 Google Chrome,ffmpegffprobe
  • 快速启动: 克隆仓库,创建虚拟环境并安装依赖,启动带远程调试端口的 Chrome/Chromium,运行 scripts/download_videoteca.py 下载视频。
  • 完整下载: 建议先使用稳定模式(--video-workers 1 --segment-workers 8),再使用快速模式(--video-workers 2 --segment-workers 4)。
  • 有用命令: 包括干运行(--dry-run)、显示缺失文件(--missing)、校验视频(--verify)和断点续传(--start-after)。

故障排查

  • Vimeo 播放列表超时: 减少 --video-workers 并重试。
  • 连接重置: 降低并行度。
  • 分段失败: 故障临时数据保存在 data/raw/failed_segments/
  • ffprobe 错误: 合并的 MP4 被视为失败并移除。
  • 无头服务器: 使用 xvfb-run 加 Chrome CDP。

发布文件

release/ 目录包含 videos.csvmissing_videos.txtvideos.sha256 以及复制的元数据和下载脚本。可通过 sha256sum -c release/videos.sha256 校验校验和。
搜集汇总
数据集介绍
Stop-Piramida Video Dataset 数据集图片
构建方式
在反欺诈与媒体监测领域,数据集的可复现性对于实证分析至关重要。Stop-Piramida Video Dataset基于公开的Stop-Piramida.kz平台构建,收录了593个揭露金融骗局的视频。该数据集采用分层架构组织,核心元数据层存储于GitHub仓库,包括视频ID、类别、标题及来源链接等关键信息,以all_videos.jsonl作为规范索引。媒体层由用户通过内置下载脚本从Vimeo平台还原,MP4文件按类别分类存储于本地目录。此外,侧车元数据层记录每个视频的下载状态与技术校验信息,原始层则暂存DASH分片与失败调试内容,不纳入最终发布包。这种设计确保了数据的可复现性与版本控制,同时避免了大型媒体文件对仓库的负担。
特点
该数据集具备显著的结构化与可扩展特性。元数据与媒体层严格分离,用户可仅通过索引文件在本地重建完整视频库,无需依赖原始网站。类别体系与Stop-Piramida视频库一一对应,涵盖钓鱼诈骗、伪造文件等多种欺诈类型,便于进行细粒度分析。内置的下载脚本支持断点续传、并行下载及完整性校验,有效应对网络不稳定性。命名规范采用类别与Vimeo ID组合,路径清晰明了。数据集还提供SHA256校验和与缺失文件列表,确保发布版本的可验证性。这些设计使得数据集适用于语音识别、视频帧OCR、实体提取及欺诈场景检测等下游任务。
使用方法
使用该数据集需Python 3.10及以上环境,并安装Chromium浏览器及ffmpeg工具。用户首先克隆仓库并安装依赖,通过脚本验证环境配置。随后以远程调试模式启动浏览器,利用下载器从元数据索引中获取视频。支持按类别或全局下载,可设定视频与分片并行数以平衡效率与稳定性。下载完成后,可通过验证脚本检查文件完整性,并利用缺失列表识别未成功获取的视频。元数据可按需从网站刷新,保持索引的时效性。所有过程均依赖命令行操作,无需图形界面,特别适合服务器或自动化流水线环境。
背景与挑战
背景概述
在金融诈骗与虚假信息泛滥的数字时代,视频证据的自动化分析成为反欺诈与媒体监测领域的关键技术需求。Stop-Piramida Video Dataset由研究团队于近年构建,源自哈萨克斯坦反欺诈平台Stop-Piramida.kz的593个公开视频,旨在为反欺诈、媒体监测及基于证据的分析任务提供高质量、可复现的基准数据集。该数据集的核心研究问题聚焦于利用视频内容提取结构化信息,如语音识别、文本抽取、实体识别及欺诈场景检测,以推动自动化反欺诈技术的发展。其影响力体现在为学术界与工业界提供了一个标准化且可扩展的数据基石,尤其在中亚地区网络犯罪防控领域具有开拓性意义。
当前挑战
该数据集面临的核心挑战包括:1)领域问题层面,视频内容多样性(覆盖钓鱼、传销、虚假旅游等多类别)导致欺诈场景的自动识别与分类极为困难,需应对噪声干扰、多语言混杂及高度隐蔽的诈骗话术;2)构建过程中,数据获取依赖于动态网站解析与Vimeo流媒体片段的下载,面临连接超时、SSL错误及断点续传等技术难题,且初始近3个视频丢失,需通过元数据恢复策略补全。此外,数据集的局部存储架构要求用户自行重建媒体层,增加了复现的复杂度与可靠性风险。
常用场景
经典使用场景
Stop-Piramida Video Dataset作为一个面向反欺诈与媒体监控领域的可复现视频数据集,汇聚了源自Stop-Piramida.kz平台的593条公开视频资源,其经典使用场景聚焦于自动化欺诈信息提取与证据链构建。研究者可借助该数据集开展多模态内容分析,例如通过Whisper ASR技术对视频中的语音进行转录,结合OCR技术提取帧图像中的文本信息,进而针对电话号码、URL链接、Telegram用户名、域名、促销代码、金额数值及加密货币钱包地址等高价值实体进行系统性抽取。这一流程为欺诈场景的深度检测与媒体舆情监控提供了标准化的数据基础,使得从非结构化视频流中挖掘欺诈线索成为可能。
解决学术问题
该数据集在学术层面着力解决了欺诈检测领域长期面临的标注数据匮乏与场景碎片化问题,特别是针对中亚地区以视频形式传播的庞氏骗局、钓鱼欺诈与虚假旅游等典型诈骗类型,提供了首个结构化、可复现的基准数据集。通过统一的数据模式与层次化架构,它有效支持了跨视频的实体识别、场景分类与异常行为建模,推动了少样本学习与弱监督方法在反欺诈任务中的应用。其引入的可复现机制更促进了研究的透明性与可验证性,为构建开放、可比较的学术评价体系奠定了重要基础,显著增强了算法在真实世界欺诈场景中的泛化能力。
衍生相关工作
围绕Stop-Piramida Video Dataset已衍生出多项具有代表性的创新工作,涵盖了从底层音频转录到高层欺诈场景推理的完整技术链条。在语音处理方向,Whisper ASR模型的微调与评估成为典型应用,研究者利用该数据集中的多语种语音内容优化了低资源环境下的转录精度。在视觉分析领域,基于视频帧的OCR与图像哈希技术被用于跨视频的重复内容检测与钓鱼页面识别。此外,实体抽取与知识图谱构建工作借助该数据集中的结构化元数据,实现了骗局模式的自动归纳与演化追踪。这些衍生成果不仅验证了数据集的实用价值,更拓展了其在金融犯罪预防、互联网治理与计算法学等交叉学科的研究边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

