
遇见数据集

dnagpt/omnigene4-mm-corpus

收藏
Hugging Face2026-06-05 更新2026-06-14 收录
官方服务:

资源简介:

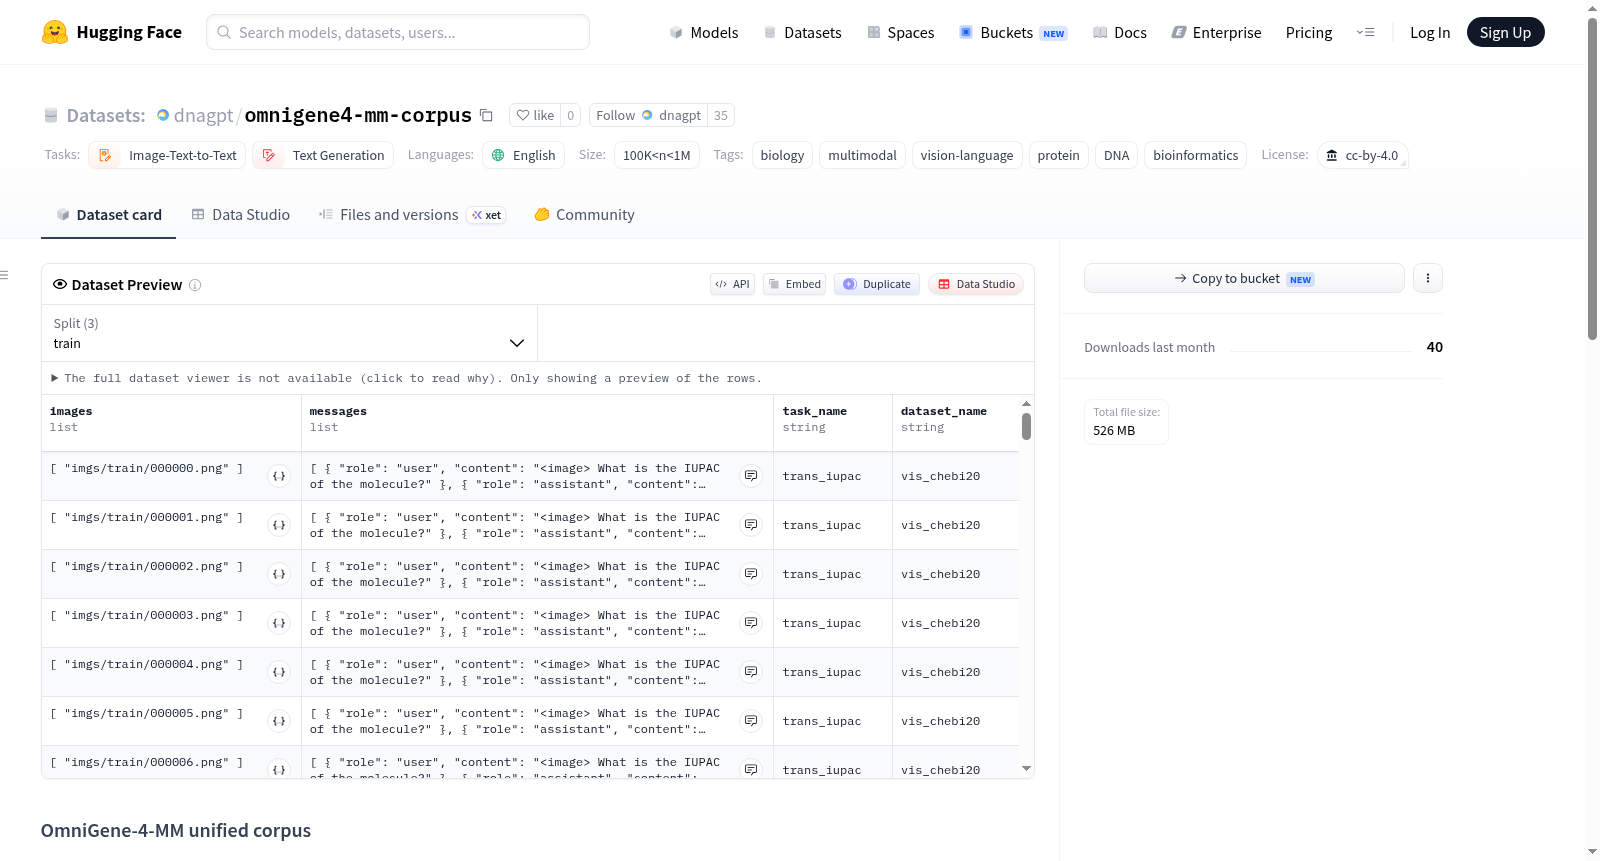
OmniGene-4-MM统一语料库是一个多模态训练数据集,用于OmniGene-4-MM的第1至第3阶段。每个数据行是一个JSON对象,包含messages(聊天格式)、images(相对图像路径列表)和modality字段。视觉数据行引用了来自多个源数据集的图像,包括Vis-CheBI20(化学结构识别)、PubMedVision(生物医学文献图像)、HPA10M(人类蛋白质图谱显微镜图像)、ChartQA(图表问答)以及内部合成的生物医学视觉任务。该语料库旨在支持生物信息学、多模态和视觉语言任务,涵盖生物学、蛋白质和DNA等领域。用户可以通过下载源视觉数据集并运行特定脚本来重现训练过程。

The OmniGene-4-MM unified corpus is a multi-modal training dataset used for OmniGene-4-MM Stages 1–3. Each row is a JSON object with messages (chat-format), images (list of relative image paths), and modality field. Vision rows reference images from source datasets including Vis-CheBI20 (chemical structure recognition), PubMedVision (biomedical literature images), HPA10M (Human Protein Atlas microscopy images), ChartQA (chart question answering), and synthetic biomedical visual tasks (project-internal). It is designed for bioinformatics, multimodal, and vision-language tasks, covering areas such as biology, protein, and DNA. Users can reproduce the training by downloading the source vision datasets and running a specific script.
提供机构:
dnagpt
搜集汇总
数据集介绍
dnagpt/omnigene4-mm-corpus 数据集图片
构建方式
OmniGene-4-MM统一语料库是为OmniGene-4模型多模态训练阶段定制的数据集,其构建过程整合了来自多个生物医学视觉来源的异构数据。每一行数据以JSON对象形式存储,包含对话格式的messages字段、记录相对图像路径的images字段以及标识模态的modality字段。视觉数据源自Vis-CheBI20、PubMedVision、人类蛋白质图谱显微镜图像、ChartQA以及项目内部合成的生物医学视觉任务。通过下载源视觉数据集至本地路径并运行脚本进行路径重映射,完成数据集的组装与对齐。
使用方法
使用者需首先从原始来源下载视觉数据集,并将其解压至匹配的本地目录。随后运行提供的脚本进行图像路径修复,确保数据引用正确。数据集以JSONL格式存储,适合与OmniGene-4的训练脚本直接配合使用,例如阶段一的视觉预热训练以及后续混合阶段的池化操作。验证集用于模型评估,并可在不同评估脚本中加载以测试多模态性能。
背景与挑战
背景概述
多模态生物学研究正沐浴于人工智能的浪潮之中,融合蛋白质、DNA序列与文本-图像描述的新型模型日益成为理解生命语言的关键工具。在这一背景下,OmniGene-4-MM统一语料库于2026年由研究者Wang Liang及其团队构建,旨在为OmniGene-4多模态模型的前三个阶段训练提供基础支撑。该数据集整合了来自Vis-CheBI20、PubMedVision、人类蛋白质图谱显微镜图像、ChartQA以及内部合成的生物医学视觉任务,覆盖约280K训练样本与5K验证样本,以JSON格式封装为对话结构并携带图像路径与模态标签。其核心研究问题在于弥合生物分子序列与视觉表征之间的语义鸿沟,有望推动可解释的、模态不变的跨域生物语言模型发展,对计算生物学与多模态信息融合领域产生深远影响。
当前挑战
该数据集所面临的挑战主要涵盖两个层面。在领域问题层面,现有生物信息学方法多局限于单一模态分析,难以将蛋白质结构与化学描述、基因功能与显微图像等异构信息统一建模,OmniGene-4-MM致力于通过多任务学习打破这一壁垒,但如何在不同模态间建立稳健的语义对齐仍是一大难题。在构建过程中,数据集需从多个源头获取并整合图像资源,涉及大量异构数据格式与许可协议的统一,同时需处理图像路径的本地化映射与子任务划分的细粒度控制,例如Vis-CheBI20中涵盖结构识别、描述生成、IUPAC与SMILES翻译等五项子任务,其平衡采样与验证逻辑的设计亦增加了系统复杂度与可复现性的挑战。
常用场景
经典使用场景
在生物信息学与多模态人工智能的交叉领域,数据集是驱动模型能力跃迁的核心基石。OmniGene-4-MM统一语料库专为训练具备视觉与文本理解能力的生物语言模型而构建,其经典使用场景聚焦于多阶段联合训练:模型首先利用约28万条包含图像与文本配对数据的训练集进行视觉预热,随后在混合任务池中渐进式学习,最终实现从分子结构图像到语义描述的精准映射。该数据集整合了Vis-CheBI20、PubMedVision、人类蛋白质图谱等多源生物学视觉数据,覆盖化学结构识别、分子描述生成、IUPAC命名翻译等五大子任务,为开发能同时解析蛋白质、DNA与化学分子图文信息的通用生物多模态模型提供了标准化训练范本。
解决学术问题
该数据集系统性地回应了生物多模态学习中数据异质性与任务碎片化的学术困境。长期以来,由于缺乏统一格式的高质量生物学图文语料,研究者难以训练出泛化能力强的模型。此语料库通过合并来自化学、病理学、蛋白质组学等不同子领域的数据,并明确标注五种有监督任务类型,解决了跨模态表示对齐不足与任务间知识迁移困难的问题。其意义在于首次为生物语言多模态模型提供了可复现的三阶段训练流水线,使学界能够量化评估模型在不同生物学视觉任务上的泛化性能,进而推动以“路由级可解释性”与“模态不变表征”为代表的前沿理论从概念验证走向实际落地。
实际应用
在实际研发场景中,该数据集赋能了对生物学知识自动化解析的多个关键环节。鉴于其覆盖了从化学分子结构到病理学显微图像的视觉资料,基于此语料库训练的模型可直接应用于药物研发管线中的化合物结构识别、生物文献图表自动解读、以及高通量显微成像实验的智能描述生成。例如,在蛋白质亚细胞定位分析中,模型可结合HPA10M显微镜图像与文本描述,生成符合生物学规范的报告;对医学科研人员而言,借助PubMedVision的病理图像示例,该模型能辅助自动化病历文书的编辑与审核流程,显著降低人工标注与复查的时间成本。
数据集最近研究
最新研究方向
该数据集聚焦于多模态生物语言建模的前沿方向,通过整合蛋白质、DNA序列与视觉表型数据,推动生物信息学从单一模态向跨模态融合的范式转变。其构建的OmniGene-4-MM语料库涵盖Vis-CheBI20分子结构识别、PubMedVision病理图像解析及人类蛋白质图谱显微镜数据,为训练具备视觉-文本联合推理能力的生物大模型提供了标准化训练资源。这一方向与当前AI for Science领域的热点事件紧密关联,尤其在AlphaFold之后,多模态学习正在重塑药物发现与基因功能预测的研究路径,该数据集通过引入合成生物医学视觉任务,为探索生物体的视觉-语言联合表征开辟了新途径,有望加速精准医学与合成生物学的技术突破。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

