
aisquared/databricks-dolly-15k
收藏官方服务:
资源简介:
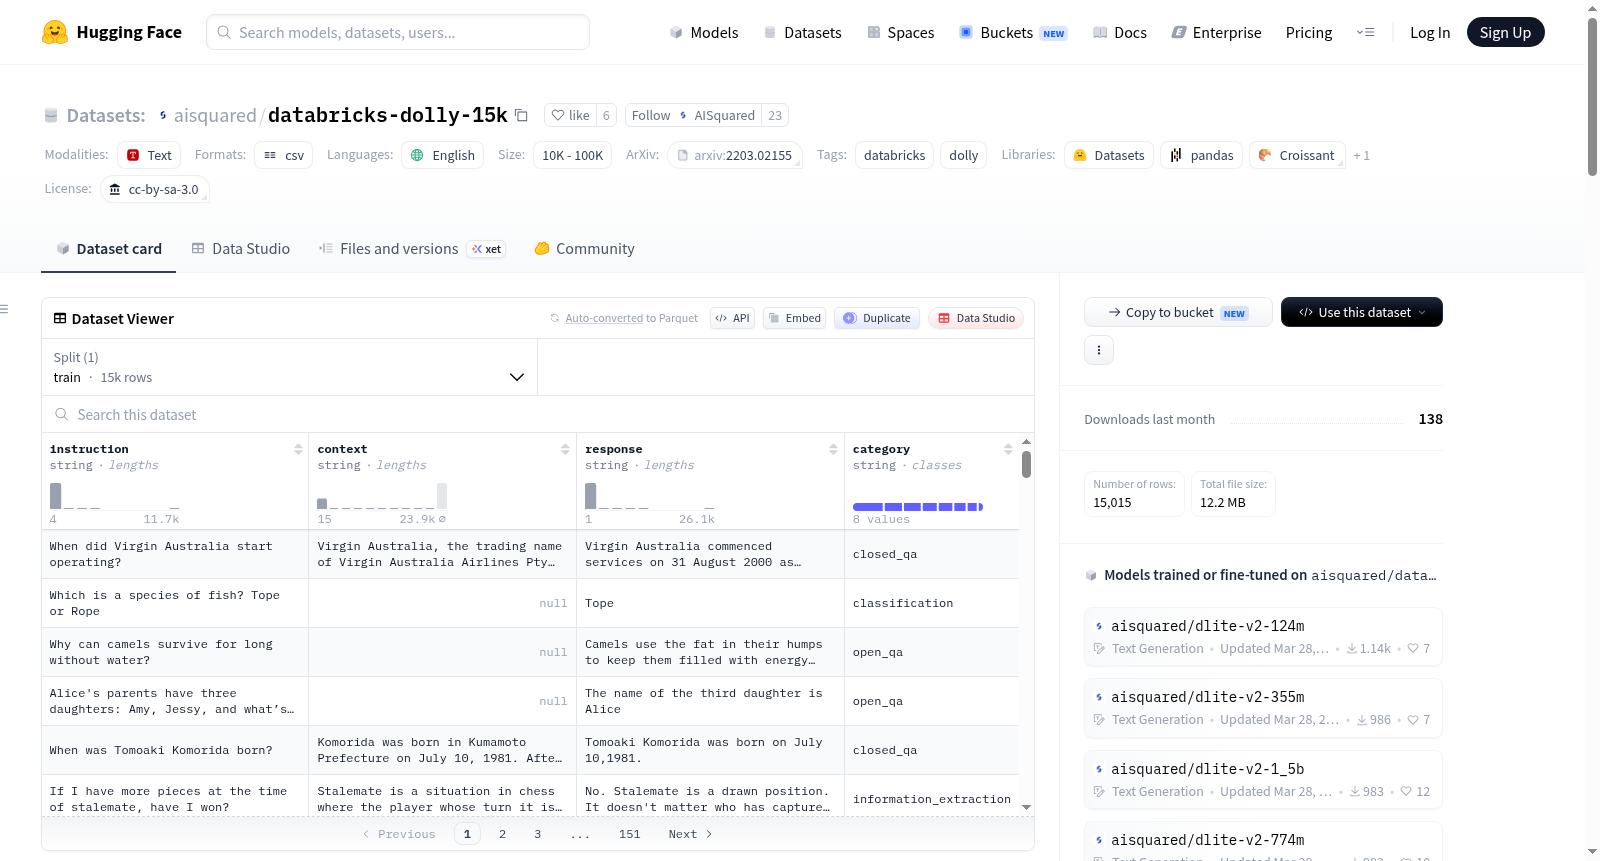
`databricks-dolly-15k`是一个开源数据集,包含超过15,000条由Databricks员工生成的指令跟随记录,涵盖了多种行为类别,如头脑风暴、分类、封闭问答、生成、信息提取、开放问答和总结。该数据集旨在训练大型语言模型以展示类似ChatGPT的交互性。数据集可用于学术或商业目的,遵循Creative Commons Attribution-ShareAlike 3.0 Unported License。
`databricks-dolly-15k`是一个开源数据集,包含超过15,000条由Databricks员工生成的指令跟随记录,涵盖了多种行为类别,如头脑风暴、分类、封闭问答、生成、信息提取、开放问答和总结。该数据集旨在训练大型语言模型以展示类似ChatGPT的交互性。数据集可用于学术或商业目的,遵循Creative Commons Attribution-ShareAlike 3.0 Unported License。
提供机构:
aisquared原始信息汇总
数据集概述
数据集名称
databricks-dolly-15k
创建者
- 所有者: Databricks, Inc.
- 创建者: Databricks员工
数据集内容
- 类型: 开放源代码数据集,包含超过15,000条指令遵循记录。
- 内容: 由Databricks员工生成的指令/响应对,涵盖八个不同的指令类别,包括创意写作、封闭式问答、开放式问答、总结、信息提取、分类和头脑风暴。
用途
- 支持任务: 训练大型语言模型(LLMs)、合成数据生成、数据增强。
- 应用: 用于指令微调大型语言模型,也可用于合成数据生成和数据增强。
许可
- 许可证: Creative Commons Attribution-ShareAlike 3.0 Unported License
- 使用限制: 可用于任何目的,包括学术和商业应用。
语言
- 主要语言: 美式英语
数据集特点
- 数据来源: 主要由Databricks员工生成,部分内容参考自Wikipedia。
- 注释指南: 提供简洁的注释任务描述和示例,以鼓励高任务完成率。
- 已知限制: 可能包含Wikipedia的偏见、事实错误和主题关注点;部分注释者可能非英语母语者;注释者的背景可能反映Databricks员工的组成。
数据集版本
- 版本: 1.0
搜集汇总
数据集介绍
构建方式
在大型语言模型微调领域,高质量指令数据的稀缺性一直是制约模型性能提升的关键瓶颈。databricks-dolly-15k数据集正是为应对这一挑战而诞生,由Databricks公司组织数千名员工基于InstructGPT论文中定义的行为类别(包括头脑风暴、分类、封闭式问答、生成、信息抽取、开放式问答和摘要)共同构建。构建过程中,员工被邀请创建提示与响应对,并严格遵循避免使用网络信息(维基百科特定子集除外)和生成式AI辅助的原则。数据生成中期,贡献者还可选择改写并回答其他参与者提出的问题。对于需要参考文本的类别,贡献者需从维基百科复制相关段落作为上下文,使得数据集兼具人工标注的多样性与知识来源的可靠性。
使用方法
该数据集最直接的应用场景是用于大型语言模型的指令微调,能够有效增强模型遵循人类指令的能力。基于其人工生成的提示文本,研究者可借鉴Self-Instruct论文中的方法,将少量示例提交给大型开源语言模型,从而合成出数百万条涵盖各类别的指令数据,实现数据集的规模化扩展。同时,指令和响应文本为数据增强提供了肥沃土壤,例如利用释义模型对提示或简短回答进行改写,并将改写文本与原标注样本关联,形成一种正则化手段,提升下游模型在指令遵循任务中的鲁棒性。用户需注意移除上下文字段中维基百科的引用编号,以确保数据在应用中的纯净性。
背景与挑战
背景概述
在大型语言模型(LLM)领域,指令微调是赋予模型遵循人类意图能力的关键技术,而高质量、多样化的指令数据集则是实现这一目标的基础。2023年,由Databricks公司主导,动员数千名内部员工共同创建了databricks-dolly-15k数据集,这是首个完全由人类生成的、面向商业与学术用途的开源指令跟随语料库。该数据集涵盖了InstructGPT论文中提出的七类行为模式,包括头脑风暴、分类、封闭式问答、文本生成、信息抽取、开放式问答及摘要,并额外增设自由创作类别,共计超过15000条指令-响应对。其核心研究问题在于如何通过人工标注的方式,构建一个能够模拟ChatGPT交互体验的、无版权限制的训练资源。这一数据集的发布,不仅为LLM的指令微调提供了即时可用的高质量语料,更推动了合成数据生成与数据增强方法的探索,对开源社区和商业应用产生了深远影响。
当前挑战
databricks-dolly-15k数据集在构建与应用中面临多重挑战。首先,从领域问题角度看,指令微调的核心挑战在于如何使模型准确理解并执行多样化的用户意图,而该数据集虽覆盖八类行为,但类别间的边界模糊、任务复杂度不均,可能导致模型在特定场景下泛化能力不足。其次,构建过程中,由于标注者来自Databricks内部员工,其人口统计特征与知识背景的局限性可能引入偏差,例如标注者并非均为英语母语者,且主题偏好可能受公司文化影响。此外,标注指南设计简洁以鼓励参与,却牺牲了严格遵循标注标准的可靠性,导致部分指令-响应对的质量参差不齐。同时,数据集依赖维基百科作为参考文本来源,后者作为众包语料,本身包含偏见、事实错误及主题聚焦问题,进一步放大了数据噪声。这些挑战对后续模型训练的鲁棒性与公平性构成了潜在制约。
常用场景
经典使用场景
在大型语言模型的指令微调领域,databricks-dolly-15k数据集扮演着奠基性的角色。该数据集由Databricks公司员工精心构建,收录了超过15,000条涵盖头脑风暴、分类、封闭式问答、文本生成、信息抽取、开放式问答与摘要等多类行为的指令-响应对。其设计灵感源自InstructGPT论文中的行为分类体系,旨在让模型习得类似ChatGPT的交互能力。研究者通常利用该数据集对预训练语言模型进行监督式微调,使其能够理解并遵循复杂的人类指令,从而显著提升模型在多样化任务上的泛化性能与对话流畅度。
解决学术问题
该数据集的核心学术贡献在于填补了高质量、开源且可商用的人类指令数据集的空白。在dolly-15k问世之前,学术界普遍面临指令数据稀缺、版权限制严格的困境,尤其是缺乏能够用于商业研究的开放资源。该数据集通过系统化的众包标注流程,提供了涵盖多种认知维度的指令样本,有效解决了模型在指令理解与遵循能力上的训练瓶颈。其意义在于为指令微调、少样本学习与模型对齐研究提供了标准化的基准数据,推动了可交互式语言模型从实验室走向工业应用。
实际应用
在实际应用层面,databricks-dolly-15k最直接的价值在于赋能企业级对话系统的开发与优化。开发者可基于该数据集微调开源大模型,构建定制化的智能客服、知识问答助手或内容生成工具。例如,通过提取其中的信息抽取与摘要样本,可训练模型自动从文档中提炼关键信息;借助头脑风暴与创作类指令,则能激发模型的创意表达能力。此外,该数据集还被广泛用于合成数据生成,即利用少量人工标注样本作为示例,引导更大规模的语言模型自动产出海量指令数据,从而降低下游应用的数据获取成本。
数据集最近研究
最新研究方向
databricks-dolly-15k数据集作为首个开源、人工生成的指令微调语料库,当前研究主要聚焦于利用其多样化的指令类别(如头脑风暴、分类、封闭式问答等)提升大语言模型的交互能力与任务泛化性。前沿方向包括基于该数据集的合成数据生成方法,通过自指令(Self-Instruct)范式扩展训练样本规模,以及采用数据增强技术(如释义模型改写)增强模型鲁棒性。该数据集开放商业使用许可,显著推动了ChatGPT类模型的民主化研究,尤其在低资源场景下为学术与工业界提供了可复现的基准,其影响延伸至指令微调策略优化、模型对齐性评估及人机交互质量提升等热点领域。
以上内容由遇见数据集搜集并总结生成


