
遇见数据集

nico8771/zinc_clean

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

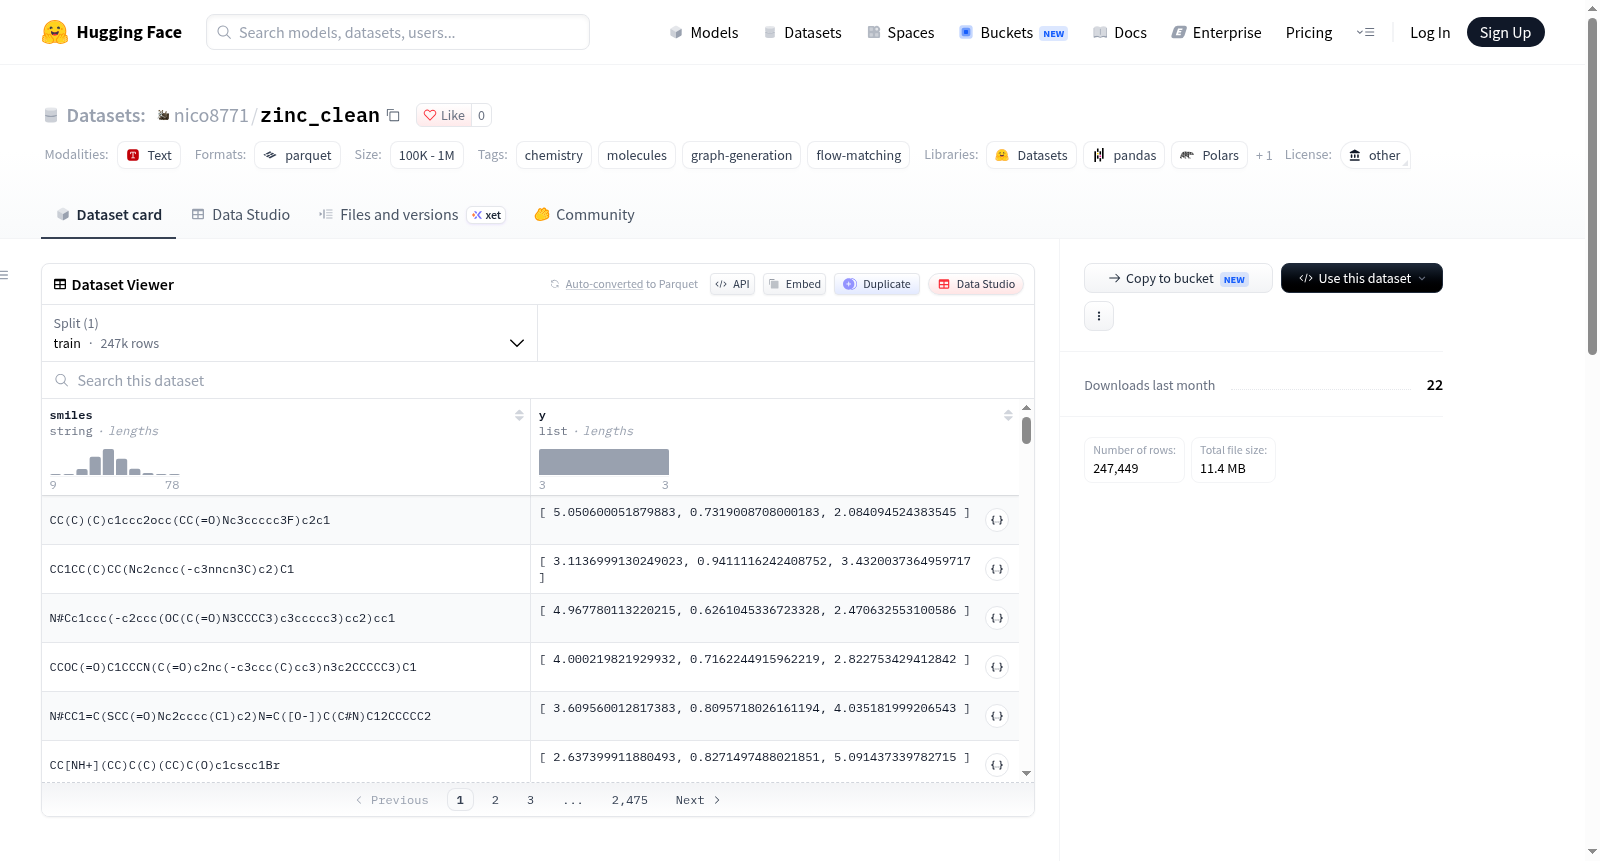
该数据集名为nico8771/zinc_clean — cleaned ZINC-250k,是一个经过清洗的ZINC-250k化学分子数据集。每个数据行代表一个分子,以规范SMILES(简化分子线性输入规范)格式表示,并包含通过RDKit重新计算的目标值(logP、qed、SAS),同时保留了带电基团(如N+和O-)。数据集来源于torch_molecule ZINC-250k,并经过严格的预处理流程:包括使用RDKit解析(丢弃不可解析的分子)、标准化(移除立体化学信息并进行净化,保留电荷)、Kekulize处理(基于原子词汇表,丢弃不在词汇表中的原子)以及往返检查(确保SMILES可重构为规范单片段分子)。键使用4个类别(无键、单键、双键、三键)。在构建过程中,丢弃了2,006个分子(其中1个因往返检查失败,2,005个因原子不在词汇表中),最终保留了247,449个分子。数据集适用于化学、分子、图生成和流匹配等研究领域,规模在10万到100万之间。

This dataset, named nico8771/zinc_clean — cleaned ZINC-250k, is a cleaned version of the ZINC-250k chemical molecule dataset. Each row represents a molecule as canonical SMILES with RDKit-recomputed targets (logP, qed, SAS), while preserving charged groups (e.g., N+ and O-). It is sourced from torch_molecule ZINC-250k and undergoes a rigorous preprocessing pipeline: parsing with RDKit (dropping unparseable molecules), standardization (removing stereochemistry and sanitizing while preserving charges), Kekulization (based on an atom vocabulary, dropping atoms outside the vocab), and a round-trip check (ensuring SMILES can be reconstructed into a canonical single-fragment molecule). Bonds use 4 classes (none, single, double, triple). During construction, 2,006 molecules were dropped (1 due to round-trip failure, 2,005 due to atoms outside the vocabulary), resulting in 247,449 kept molecules. The dataset is suitable for research in chemistry, molecules, graph generation, and flow matching, with a size category between 100K and 1M.
提供机构:
nico8771
搜集汇总
数据集介绍
nico8771/zinc_clean 数据集图片
构建方式
在分子图生成与化学信息学领域中,数据集的规范化处理是确保模型训练可靠性的关键环节。zinc_clean 的构建以 torch_molecule 发布的 ZINC-250k 为源数据,经由 RDKit 执行多阶段净化流程。原始分子首先被解析,无法解析的条目直接剔除;随后去除立体化学信息并进行 sanitize 处理,同时保留 N+ 与 O- 等带电基团。在此基础上,分子沿预设原子词表(C、N、O、F、P、S、Cl、Br、I、N+、O-)进行 Kekulize 转换,词表之外的原子所对应分子被丢弃。最终通过 smiles→(X,E)→mol→smiles 的往返一致性校验,仅保留能够复原为单一片段规范分子的条目,得到 247,449 个有效分子。
特点
该数据集以分子图生成任务为导向,呈现出若干鲜明特征。每行数据包含规范 SMILES 字符串及 RDKit 重新计算的三个理化目标值,即 logP、qed 与 SAS,为属性预测与条件生成提供了可靠的监督信号。键类型被统一为四类(无键、单键、双键、三键),原子类别限定于十一种常见元素与离子形态,这种受约束的表示降低了建模复杂度。数据规模处于 100K 至 1M 区间,经过严格的词表过滤与往返校验,约 2,005 个分子因原子超出词表被剔除,仅 1 个分子未通过往返检验,最终保留的分子均具备可 kekulize 的单片段规范形式。
使用方法
使用该数据集时,研究者可直接通过 HuggingFace datasets 库加载 nico8771/zinc_clean,读取 smiles 字段获取规范 SMILES,并解析 y 列表得到 logP、qed、SAS 三个目标值。针对分子图生成任务,可借助配套代码仓库 flow-matching-molecules 中的 dataset/ 模块完成原子与键的编码转换,将 SMILES 映射为 (X, E) 形式的图表示。训练流匹配或图生成模型时,该数据集可作为标准化的化学空间采样来源;评估生成质量时,可利用 RDKit 对生成分子重新计算目标属性,并与真实值进行比对。需注意,因立体化学已被移除且原子词表受限,涉及手性或多元素扩展的应用需另行处理。
背景与挑战
背景概述
分子生成与化学信息学领域长期依赖高质量分子数据集以推动图神经网络与深度生成模型的发展。ZINC-250k作为经典基准,源自ZINC数据库,广泛用于分子性质预测与从头设计。nico8771/zinc_clean于近年发布,由研究者Nico Conti等基于torch_molecule版本构建,旨在提供经RDKit标准化与Kekulize处理的规范SMILES及logP、qed、SAS等目标值。该数据集通过严格的单片段与可解析性筛选,剔除了词表外原子与错误分子,为流匹配等生成模型提供了更可靠的训练资源,在分子图生成与化学语言建模社区中具有重要影响力。
当前挑战
分子生成领域面临的核心挑战在于生成同时满足化学价键规则、拓扑有效性与目标性质约束的分子,而原始ZINC-250k中存在的非规范SMILES、立体化学冗余及碎片化分子会引入噪声,降低模型学习效率。构建zinc_clean时,需权衡词表覆盖度与数据保留量,例如过滤原子词表外元素导致2,005个分子被丢弃,同时需确保Kekulize后SMILES经图编码与解码仍能还原为单一规范分子,仅1个分子因往返校验失败被剔除。此外,电荷基团如N+与O-的保留、目标值从规范SMILES重新计算的一致性,以及在不引入立体信息前提下维持化学多样性,均为数据处理中的关键难点。
常用场景
经典使用场景
在分子生成与图表示学习领域,zinc_clean数据集凭借其规范化的SMILES表示与配套的RDKit理化性质标签,成为训练和评估生成模型的经典基准。研究者通常将其用于图生成模型(如基于流匹配或扩散模型的分子生成)的端到端训练,模型以原子和化学键为节点与边,学习分子图的分布,并同步预测logP、QED与SAS等关键属性。该数据集去除了立体化学信息并保留带电基团,使得生成任务在保持化学合理性的同时,降低了图结构建模的复杂度,因而被广泛用于分子生成、属性预测及表示学习的标准实验设置。
解决学术问题
该数据集主要解决了分子生成研究中数据质量参差不齐、标准化流程缺失以及理化性质标签不一致等常见问题。通过严格的RDKit解析、标准化、Kekulize及往返校验流程,它剔除了无法解析、词汇表外原子及非单片段分子,确保了每个样本均为规范、可逆的单片段SMILES,并重新计算logP、QED、SAS,消除了原始ZINC-250k中可能存在的标签噪声。这一处理为学术研究提供了可复现、低偏差的基准,使得不同模型在生成质量、属性优化与分布学习上的比较更加公允,推动了分子生成领域方法学的严谨化。
衍生相关工作
基于zinc_clean数据集,研究者已开展了一系列衍生工作,主要集中在流匹配分子生成框架的构建与评估。例如,配套代码库flow-matching-molecules利用该数据集实现了基于连续流匹配的分子图生成模型,并系统比较了不同生成范式在ZINC-250k清理版本上的表现。此外,该数据集也被用于图神经网络属性预测、分子分布学习及生成模型的鲁棒性分析等研究,成为分子生成领域若干经典基准实验的重要数据来源,促进了生成模型与化学信息学的交叉融合。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

