
pythainlp/thai-g2p-v4-dataset
收藏官方服务:
资源简介:
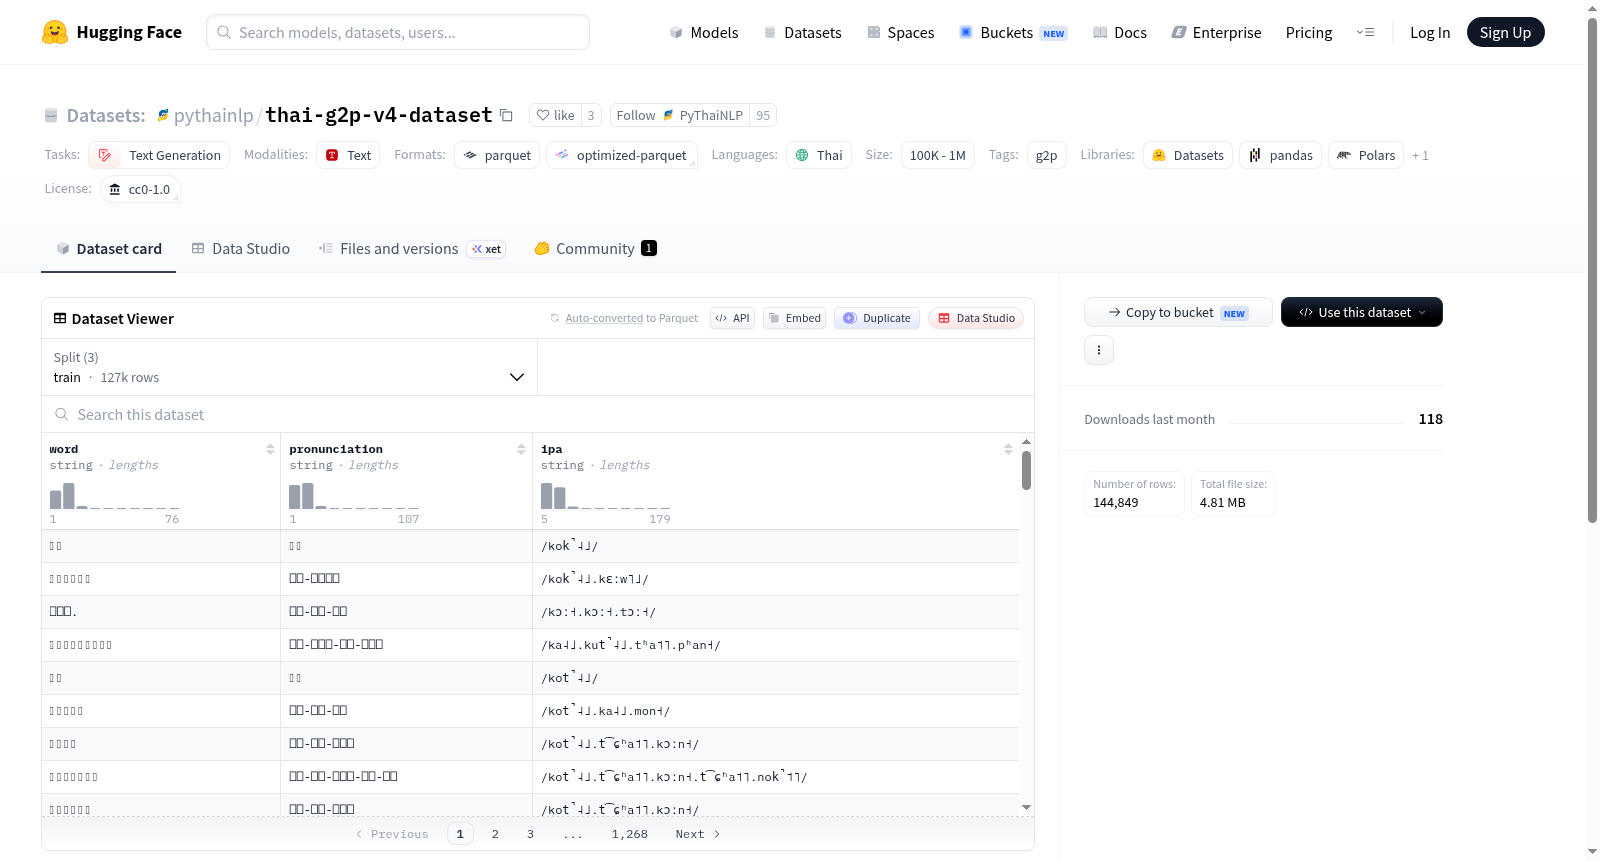
Thai G2P v4数据集是一个泰语字素到音素转换数据集,基于Thai W2P和Wiktionary th-pron transliterator构建。该数据集用于将泰语单词(字素)转换为其发音(音素),包含单词、发音和国际音标三个特征。数据集通过前两个字符进行分割,分为训练、测试和验证三个部分,适用于文本生成任务,特别是泰语语音处理或自然语言处理中的发音预测。
Thai G2P v4 dataset is a Thai grapheme-to-phoneme dataset that was built from Thai W2P and Wiktionary th-pron transliterator. We split the dataset by using the first 2 characters for the split group.
提供机构:
pythainlp搜集汇总
数据集介绍
构建方式
本数据集名为thai-g2p-v4-dataset,专注于泰语字形到音素的转换任务。其构建过程融合了泰语W2P数据集与维基词典th-pron音译器两大资源,通过整合两种来源的发音信息,形成了丰富的泰语词汇与对应发音配对。数据集按词汇前两个字符进行分组划分,最终得到训练集126718条、测试集8076条及验证集10055条样本,规模介于10万至100万之间,确保了数据分布的均衡性与代表性。
特点
该数据集的核心特点在于其多维度发音标注体系,每条记录包含词汇本身的泰语文字、基于泰语罗马化系统的发音标注以及国际音标(IPA)转录,为语音合成、自动语音识别等自然语言处理任务提供了精确的发音映射依据。数据集采用CC0-1.0许可证,完全开放共享,且由社区权威开发者维护,来源可追溯至PyThaiNLP生态,具备极高的可靠性与实用性。
使用方法
使用本数据集时,用户可通过HuggingFace数据加载库直接调用,其默认配置下包含train、test、validation三个子集,数据文件以通配符模式存储。适用于序列到序列的文本生成任务,尤其适合训练泰语G2P模型。研究者可将词汇列作为输入,发音或IPA列作为目标输出,构建端到端的音素预测系统,亦可针对不同子集进行模型性能评估与调优。
背景与挑战
背景概述
在自然语言处理领域,字形到音素(Grapheme-to-Phoneme, G2P)转换是语音合成与语音识别系统的关键基础任务,尤其对于泰语这类非字母拼写与发音对应关系复杂的语言而言,高质量的G2P数据集是提升模型性能的核心资源。thai-g2p-v4-dataset由Wannaphong Phatthiyaphaibun于2024年构建,依托泰国自然语言处理社区PyThaiNLP,融合了Thai W2P与维基词典泰语发音转写工具两大来源,精心整合了超过14万条词条-发音-国际音标三元组。该数据集通过按前两个字符划分训练集、验证集和测试集,显著提升了数据分布的合理性,为泰语语音技术研究提供了标准化基准,有力推动了低资源语言语音处理领域的发展。
当前挑战
构建thai-g2p-v4-dataset面临多重挑战。首先,泰语本身作为声调语言且存在大量同形异音词,其字形到音素的映射规则高度复杂,数据集中任何标注错误都将误导下游模型,因此从多个来源(Thai W2P与维基词典)整合时需严格交叉验证与去噪,这是一项艰巨任务。其次,数据集规模虽达到十万级,但相对于泰语丰富的词汇与方言变体仍显不足,训练出的G2P模型在覆盖罕见词或借词时易出现泛化瓶颈。此外,按前两字符划分数据虽增强了特定场景下的鲁棒性,却可能引入分布偏差,导致模型对外部新词的发音预测准确率受限。这些挑战共同决定了该数据集在推进泰语语音技术的同时,仍需持续完善与扩充。
常用场景
经典使用场景
在自然语言处理与语音技术交叉领域中,thai-g2p-v4-dataset作为一款泰语字形到音素(Grapheme-to-Phoneme)数据集,其最经典的使用场景是作为泰语文本到语音合成系统的核心数据。研究人员借助该数据集,能够将输入的泰语文字序列精准映射为对应的国际音标(IPA)表示,从而驱动语音合成模型的发音预测模块。该数据集包含超过12.6万条训练样本,覆盖了泰语丰富的声调与拼写规则,使得模型能够学习到从书面形式到标准发音的转换规律,为构建高自然度的泰语语音助手、电子书朗读工具等应用提供了不可或缺的基石。
实际应用
在实际应用场景中,该数据集被广泛整合于泰语语音合成服务、智能语音交互系统以及教育科技产品中。例如,在开发泰语语音助手时,系统需要将用户输入的文本快速转换为音素序列以驱动合成引擎,thai-g2p-v4-dataset为此提供了关键的预训练数据。同时,在泰语语言学教学软件中,该数据集可帮助自动生成学习材料的正确发音标注,辅助学生掌握准确的语音输出。此外,该数据集亦可应用于跨语言语音角色生成、无障碍阅读设备以及旅游翻译应用,显著提升了泰语相关语音产品的技术落地效率与用户体验质量。
衍生相关工作
该数据集衍生出多项经典研究工作,尤其在多语言G2P系统与低资源语音处理方向。基于该数据集,研究者构建了基于Transformer的泰语音素转换模型,并探索了预训练语言模型对G2P任务的迁移效果。此外,部分工作将其与周边语言(如老挝语、高棉语)的G2P数据集联合训练,发展了区域性跨语言音素映射模型。在实践层面,PyThaiNLP社区基于该数据集开发了泰语文本标准化工具与语音合成管线,进而催生了更多面向东南亚语言的开放语音资源。这些成果共同彰显了该数据集作为基准资源在推动区域语言技术演进中的关键支撑作用。
以上内容由遇见数据集搜集并总结生成


