audio_noise
收藏资源简介:
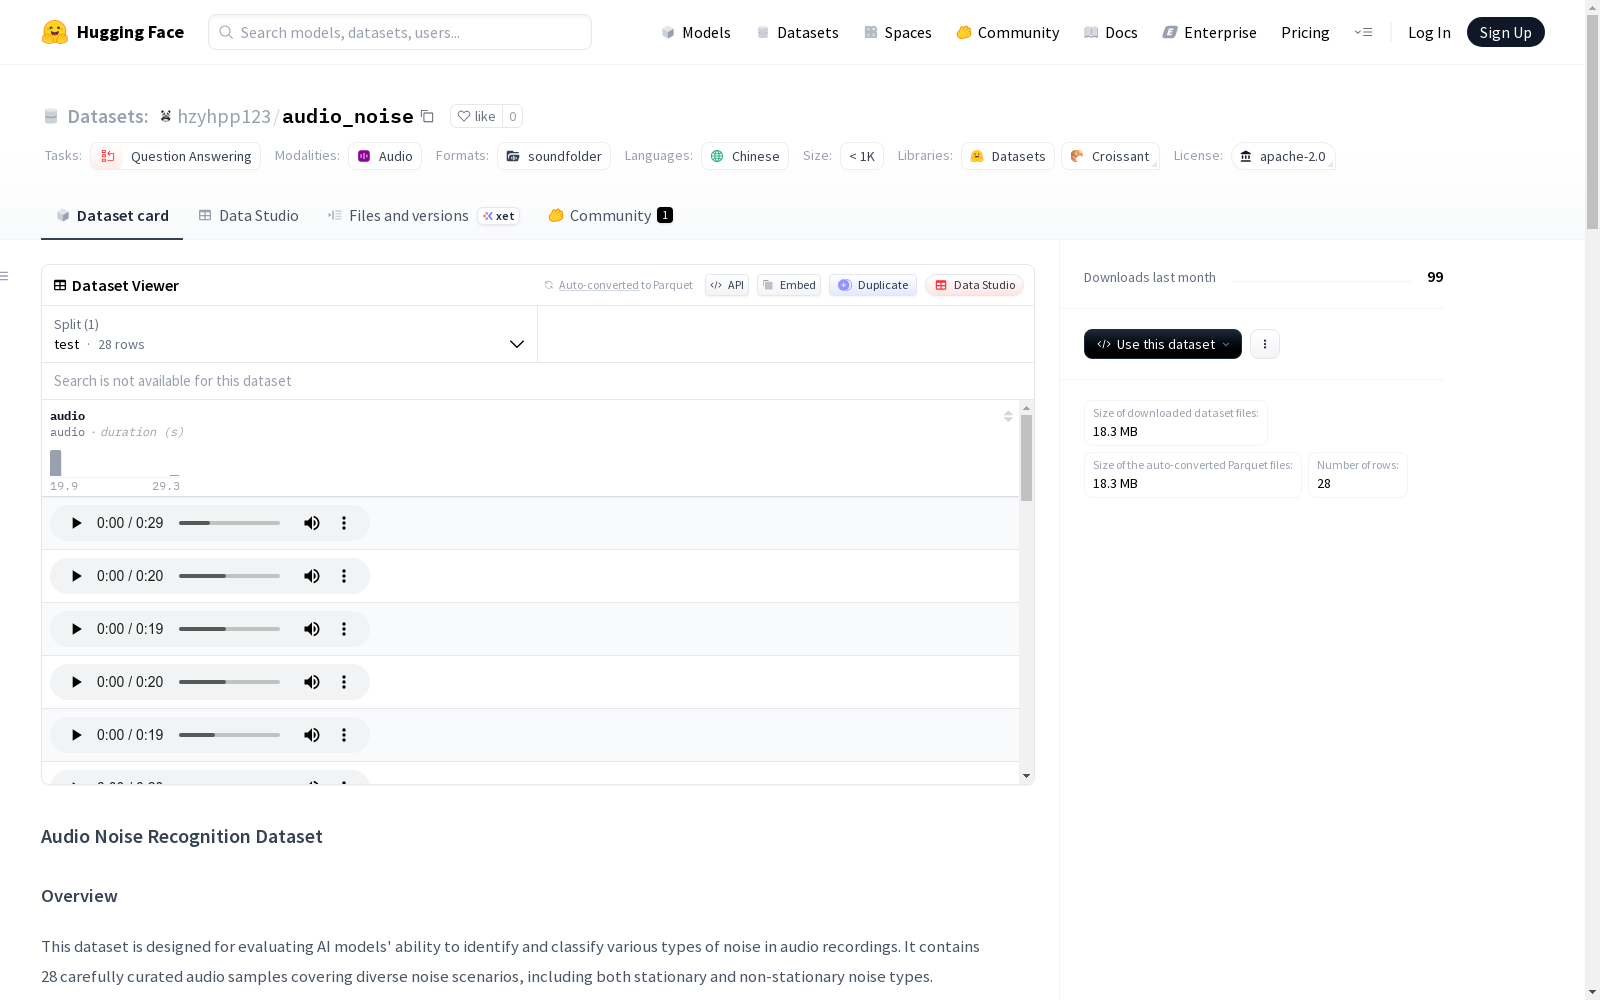
该数据集旨在评估AI模型在识别和分类音频录音中各种噪声的能力。包含28个精心挑选的音频样本,涵盖多种噪声场景,包括平稳和非平稳噪声类型。数据集结构包含WAV格式的音频文件和对应的JSONL格式标注文件。每个样本包含音频文件路径、任务信息(包括噪声类别和平稳性标签)以及详细的中文噪声描述。噪声分为平稳噪声(6个样本,如白噪声、空调噪声等)和非平稳噪声(22个样本,包括人声相关、音乐相关、环境噪声、动物声音和机械/电子噪声等)。数据集统计信息显示总样本数为28个,音频采样率为24,000 Hz,每个样本时长不超过30秒。适用于评估音频理解模型在噪声检测、分类和描述方面的能力。
This dataset is designed to evaluate the ability of AI models to identify and classify various noises in audio recordings. It contains 28 carefully selected audio samples covering diverse noise scenarios, including both stationary and non-stationary noise types. The dataset structure consists of WAV-format audio files and corresponding JSONL-format annotation files. Each sample includes the audio file path, task information (comprising noise category and stationarity label), and a detailed Chinese description of the noise. Noises are categorized into stationary noise (6 samples, such as white noise, air conditioner noise, etc.) and non-stationary noise (22 samples, including human voice-related, music-related, environmental noise, animal sounds, and mechanical/electronic noise, etc.). Dataset statistics show that the total number of samples is 28, the audio sampling rate is 24,000 Hz, and the duration of each sample does not exceed 30 seconds. It is suitable for evaluating the performance of audio understanding models in noise detection, classification and description.
音频噪声识别数据集
数据集概述
本数据集旨在评估AI模型识别和分类音频录音中各类噪声的能力。它包含28个精心挑选的音频样本,涵盖了多样化的噪声场景,包括平稳噪声和非平稳噪声类型。
数据集结构
数据集文件结构如下:
audio_noise/ ├── test/ │ ├── audio/ │ │ ├── NS_001.wav │ │ ├── NS_002.wav │ │ └── ... │ │ └── NS_028.wav │ └── data.jsonl └── README.md
数据格式
data.jsonl文件中的每个样本包含以下字段:
- audio: 音频文件路径(相对于test/audio/目录)。
- task: 任务信息。
- name: 任务描述("识别音频噪声")。
- label: 噪声类别("平稳噪声"或"非平稳噪声")。
- answer: 详细的中文噪声描述。
噪声类别
平稳噪声 - 6个样本
- 白噪声
- 空调噪声
- 电风扇噪声
- 风扇噪声
- 风声
非平稳噪声 - 22个样本
与人相关:
- 背景人声
- 婴儿啼哭声
- 车站大厅报幕声
- 空旷环境的背景人声
与音乐相关:
- 说唱音乐BGM
- 游戏音乐
- 电子音乐
环境相关:
- 地铁噪声
- 街道噪声
- 车站噪声
- 下雨声
- 风声
动物相关:
- 猫叫声
- 狗叫声
机械/电子相关:
- 警报声
- 汽车喇叭声
- 键盘噪声
- 鼠标噪声
- 滋滋噪声
- 捏塑料包装纸的噪声
- 擤鼻涕声
- 喷麦噪声
- 敲击噪声
- 金属碰撞声
数据集统计
- 总样本数: 28
- 平稳噪声样本: 6
- 非平稳噪声样本: 22
- 音频格式: WAV文件
- 采样率: 24,000 Hz
- 时长: 每个样本≤30秒
用途
本数据集可用于评估音频理解模型的以下能力:
- 检测音频录音中是否存在噪声。
- 对噪声类型进行分类(平稳噪声与非平稳噪声)。
- 识别特定的噪声特征。
- 提供噪声内容的自然语言描述。
样本示例
json { "audio": "audio/NS_001.wav", "task": { "name": "识别音频噪声", "label": "平稳噪声", "answer": "我觉得这段音频存在白噪声。" } }
任务
- 目标: 识别并描述音频噪声。
- 输入: 音频文件。
- 输出: 检测到的噪声的自然语言描述。
- 标签: 二元分类(平稳/非平稳) + 详细描述。
许可信息
- 许可证: Apache License 2.0
语言信息
- 语言: 中文