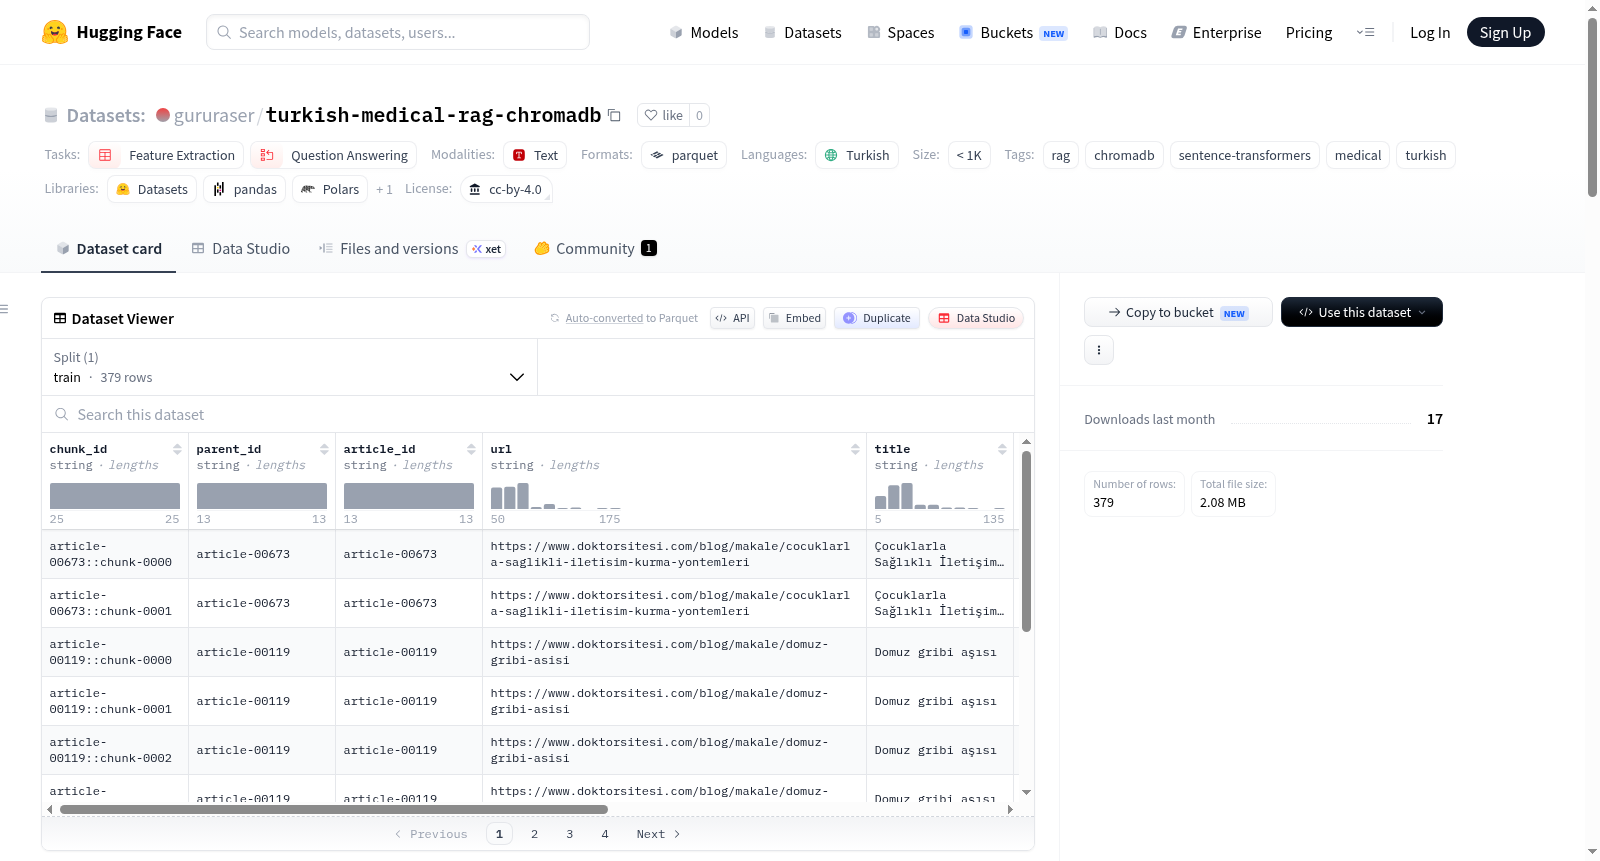
turkish-medical-rag-chromadb
收藏资源简介:
该数据集为土耳其语医学文章数据集,包含少于1000篇医学文章,可用于特征提取、问答、检索增强生成(RAG)等任务。数据集来源于医学文章,采用CC-BY-4.0许可证。原始数据集包含文章标题、正文等字段,经过预处理后形成chunk,每个chunk包含URL、文本内容、向量表示等字段。数据集适用于构建土耳其语医学领域的语义搜索和问答系统,但需注意其输出不能替代专业医疗诊断。
This dataset is a Turkish medical article dataset containing fewer than 1000 medical articles, suitable for tasks such as feature extraction, question answering, and retrieval-augmented generation (RAG). The dataset is derived from medical articles and is licensed under CC-BY-4.0. The original dataset includes fields such as article title and body text. After preprocessing, it forms chunks, each containing URL, text content, vector representation, and other fields. The dataset is intended for building semantic search and question-answering systems in the Turkish medical domain, but it should be noted that its output cannot replace professional medical diagnosis.
数据集详情:土耳其语医学RAG(含ChromaDB)
基本信息
- 数据集名称:Turkish Medical RAG with ChromaDB
- 语言:土耳其语(tr)
- 许可证:CC-BY-4.0
- 任务类型:特征提取、问答
- 标签:RAG、ChromaDB、句子Transformer、医学、土耳其语
- 数据规模:少于1000条样本(n<1K)
- 配置:默认配置,包含train分割,数据文件为
data/train.parquet
数据来源与构建
- 本数据集从
umutertugrul/turkish-medical-articles数据集中选取100篇土耳其语医学文章构建,使用固定随机种子(seed=42)选择。 - 这是一个用于RAG(检索增强生成)搜索的小型项目,目的是展示检索结果并处理低置信度场景。
- 重要声明:该系统不是医疗决策或诊断工具,所有结果必须由医疗专业人员验证。
数据处理与索引
- 分块策略:采用段落感知的混合分块,短段落合并,长段落按tokenizer窗口切分。默认窗口256个token,重叠40个token。
- 嵌入模型:默认使用
magibu/embeddingmagibu-200m,向量维度768,输出经过L2归一化。 - 向量存储:使用ChromaDB,采用余弦相似度空间(hnsw:space=cosine)。
- 每条记录包含字段:
url、chunk_text、chunk_vector,以及chunk_id、parent_id/article_id、title、token_count等可追溯性字段。
性能与基准
- 在100篇文章、379个分块上使用自然问题评估:
- 阈值设为0.45时,20个正向问题中18个正确分块排名第一(top-1)。
- 应用阈值后:17个真阳性、3个假阴性(召回率0.85)。
- 10个负向问题全部被拒绝,无假阳性,精确率1.00。
- 基准评估包含20个自然正向问题(覆盖症状、定义、风险、筛查、治疗等场景)和10个医学负向问题。
- 低置信度时返回固定消息:“Bu sorunun cevabı dokümanlarımda yer almamaktadır”(此问题的答案不在我的文档中)。
使用说明
- 需先访问原始数据集页面(
umutertugrul/turkish-medical-articles)接受使用条款并获取访问权限,通过hf auth login或HF_TOKEN环境变量认证。 - 提供
prepare、build、query、benchmark、export、push等命令行接口。 - 支持使用
--fake模式(确定性特征哈希编码器)无需下载模型即可运行流程,适合测试和CI环境。